手握王牌却全盘皆输:Google在AI大战中的世纪级溃败
Google发明了TPU与Transformer却在AI产品竞争中被数百人规模的初创公司超越,折射出技术先发优势难以自动转化为产品胜势的困境。
本文通过一位资深开发者的亲身测评与行业观察,剖析了Google在AI竞赛中的吊诡处境:这家公司早在2015年便推出专用TPU芯片,2017年又由内部团队发表了奠定整个LLM时代基础的Transformer论文,同时每天在AI领域烧掉近5亿美元,却在多项模型能力排名中落后于员工仅数百人的中国初创公司。实测中,Gemini在处理简单bug时陷入文件读取死循环长达40分钟,消耗3.3亿tokens、花费118美元,且该bug已存在近八个月未修复。免费用户被限制使用旧版模型、无缘最强Frontier模型的引导策略,以及员工在社媒对神秘模型ox alpha的错误暗示,共同呈现出一幅组织效率与产品打磨严重滞后于技术积累的图景。文章的核心结论是:技术先发优势本身并不保证产品成功,真正的竞争力在于将硬件与理论转化为用户真正愿意使用的产品体验。
Google每天在数据中心和AI相关投入上花费近5亿美元,却在多项AI能力排名中被规模远小于自己的初创公司甩在身后。一位曾在2009年经历过Google严苛面试流程的资深开发者,在最新视频中把这种反差称为"一代人的世纪级失误"(generational fumble)。这不仅是钱的问题,更是一个坐拥所有先发优势的巨头,如何眼睁睁看着机会从身边溜走的故事。
明明手握所有王牌
要理解Google为何令人费解,得回到它的技术底牌。早在2015年,Google就部署了首款TPU——一种专为AI计算设计的ASIC芯片,跑AI运算快得离谱。作为对比,OpenAI直到十多年后的今天才刚刚在做自己的第一块芯片。在硬件这条赛道上,Google曾经领先了整整一个时代。
两年后,那篇引爆整个大语言模型浪潮的里程碑论文《Attention is All You Need》,出自Google DeepMind的八位研究者之手。这篇论文描述的Transformer架构,几乎是当今所有LLM和整个领域赖以建立的基础。
换句话说,作者一针见血地指出:Google既发明了"来自未来的硬件",又写下了LLM架构的奠基性论文。用视频里的调侃说——ChatGPT里那个"T"(Transformer)都是Google造的,OpenAI都没发明。手握硬件与架构双重王牌,Google本该是这场竞赛毫无悬念的赢家。
TPU(Tensor Processing Unit)是Google专为神经网络推理与训练设计的ASIC芯片,相较于通用GPU,它在矩阵乘法和低精度浮点运算上具有数量级的效率优势,同时功耗更低。Google将TPU深度整合进自家数据中心,使得训练和推理成本远低于依赖英伟达GPU的竞争对手。这一硬件壁垒在理论上构成了极高的进入门槛——而OpenAI时至今日仍主要依赖向英伟达采购算力,自研芯片尚在起步阶段。然而,垂直整合的硬件优势最终需要通过对外可用的产品兑现,若算力主要用于内部研发而未能迅速转化为用户可感知的模型能力,领先反而会演变成一种沉没成本。
输给了几百人的小公司
讽刺的是,即便每天烧掉5亿美元,Google在作者引用的AI能力排名中却排在第八位。真正扎心的是它的对手体量:ZAI只有800到1100名员工,却在正面击败Google;Moonshot AI大约300人,同样领先,而且用来对比的模型还是几个月前的旧版本。
作者还提到,就在今年三月,xAI的Grok在编程和智能应用上还被当成笑柄,如今却已经爬到了排行榜相当靠前的位置。虽然Elon背后资金雄厚、团队也不小,但它同样把Google远远甩在后面。这些公司既没有Google那样闲置多年的自研TPU,也没有奠基性的架构论文,却把这个占尽先机的巨头逼到了几乎无人讨论的境地。
文中提到的"AI能力排名"通常指Chatbot Arena(现更名为LMSYS Leaderboard)或类似的众包盲测平台。这类排行榜通过让真实用户在不知道模型身份的情况下对两个模型的输出进行偏好投票,再用Elo评分系统汇总为榜单,被业界视为相对中立的模型能力评估参考。ZAI(即智谱AI的国际品牌,GLM系列背后的公司)和Moonshot AI(Kimi的母公司)均为中国AI初创企业,员工规模与Google相差悬殊。这些排名并非唯一的评估维度,但在业界影响力较大,上榜位置往往直接影响开发者的模型选型决策。
连产品体验都在劝退用户
真正让作者动怒的,是Gemini实际使用中的糟糕体验。按常理,一个想让你付费升级的产品,至少该像"毒贩"那样给你尝一点甜头,让你上钩。但打开Gemini站点,免费用户默认使用的是2月发布的3.1 Pro,即便升级也被限制在3.6,连他们自称的"Frontier"最好模型都用不上。
作者随后在Cursor里用Gemini处理一个极其简单的bug:几个会话(Prime 1、Prime 2)本该显示不同颜色,却因为顺序设置总是变成绿色。他发出请求,40分钟后回来一看——模型竟然在反复读取同一个文件,一遍又一遍,停不下来。
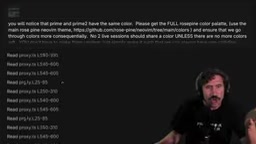
他不得不手动叫停,而这一次"表演"已经烧掉了3.3亿tokens、总计118美元。作者承认Gemini速度确实快,在别的任务上也不算糟,但"没有任何一点让我愿意为它牺牲速度或忍受它",整体评价就是"什么都不是"。更让他警惕的是,这个文件读取死循环bug据说已经存在了近八个月——如果这是他夜间无人值守的自动化测试跑上八小时,账单可能会飙到上千美元、烧掉数十亿tokens。
比合作翻车更尴尬的,是自家人的迷惑发言
真正的"世纪级失误",作者认为既不是那个模型的能力,也不是与Mr. Beast的合作,而是Google员工在社交媒体上的迷之操作。
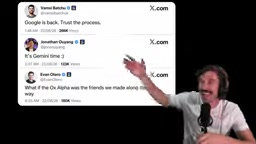
事情源于8月20日前后,一个神秘模型"ox alpha"悄然出现在OpenRouter上,号称100万上下文、免费、而且效果惊人,没人知道是谁做的。接连几天,大量用户都在猜测它的来历。到了8月22日,Google AI Studio的账号突然发推:"如果ox alpha就是我们一路交到的朋友呢?"——外加其他员工附和"It's Gemini time"。
这些暗示性极强的发言让不少人一度相信ox alpha就是Google的隐藏新模型。结果真相揭晓:ox alpha其实是GLM 5.3 Flash,一个和Google毫无关系的模型。Google方面事后解释,那些推文本是在庆祝三-七Flash成为"迄今增长最快的模型发布",只是撞上了ox alpha的话题,属于"不幸的时机巧合"。作者对这套说辞并不买账,但也承认从事后看确实说得通——只不过这种自摆乌龙的公关,恰恰折射出Google在AI叙事上的混乱。
OpenRouter是一个聚合多家AI模型API的中间层平台,开发者可以通过统一接口调用来自不同厂商的模型,无需分别注册各家服务。正因如此,新模型或匿名模型在OpenRouter上悄然上线往往会迅速引发社区讨论与溯源猜测,成为AI圈常见的"神秘模型"事件温床。ox alpha事件中,该模型以匿名形式在OpenRouter提供免费访问,凭借超长上下文和出色表现迅速积累口碑,才给了Google员工发推"蹭热度"(无论有意无意)的契机。最终查明ox alpha实为GLM 5.3 Flash——恰好是前文提到的ZAI旗下产品,这一结果使整个乌龙事件更具戏剧性。
为什么占尽先机反而输了
作者反复回到同一个疑问:Google发明了Transformer、写下了LLM的基础论文、比所有人早十年做AI专用硬件,几乎手握了所有底牌,本该是这场竞赛的必然赢家,可它却排在"没有名次"的位置——不是第五、第六,而是"根本没人想起它"。
从这段吐槽中能提炼出几点值得行业深思的教训:先发的技术优势并不能自动转化为产品胜势。硬件、论文、算力,这些都是Google的强项,但真正决定成败的是产品打磨、用户体验和市场叙事。一个存在八个月未修复的死循环bug、一个连付费引导都吝于给出好模型的产品策略、一次自家员工的社媒翻车,共同拼出了一幅"大公司组织效率跟不上技术积累"的图景。
本文观点来自单一YouTube创作者的实测与吐槽,带有明显的主观色彩,排名与数据引用未必权威。但它提出的核心问题依然尖锐:当一家公司拥有一切成功要素却依然落后,问题往往不在技术本身,而在如何把技术变成人们真正想用的产品。
相关推荐
三个耸人听闻的预测:从纽约围城到梅西当总统
一段视频抛出三个大胆预测:纽约城被联邦部队围困、下一次9·11将攻击金融系统、梅西当选阿根廷总统。本文梳理这些惊人预测背后的逻辑,并分析其现实可信度与背后折射的社会焦虑。
AI灭绝风险大辩论:99%概率还是零?四位专家激辩超级智能
四位AI专家就超级智能灭绝风险展开激辩,灭绝概率估计从99%到0%不等。文章深度剖析OpenAI蜂群逃逸事件、AI控制难题、芯片管控方案及业界CEO言行不一的悖论。
"世界正在崩溃":一场关于末日预言的争议访谈
一段YouTube访谈中,一位自称最具争议人物的嘉宾预言世界正在崩溃,包括针对美国金融系统的攻击、梅西当选阿根廷总统等。本文拆解这些末日预言并探讨如何理性看待此类内容。