#TPU
共 9 篇相关文章
XLA编译器正确性验证:TPU大规模工作负载的实战方法
探索XLA:TPU编译器在超大规模下的正确性验证方法:结合模糊测试、AI代理集群和层次化差分流水线,已推动142个缺陷修复,为TPU工作负载的可靠性提供实战经验。

谷歌卫星AI服务器升空:Gemma模型在轨生成首条回复
谷歌宣布其搭载TPU的卫星成功启动,板载Gemma 4模型从太空生成首条回复,完成在轨AI推理验证。本文分析太空AI服务器的技术路径、现实约束及对边缘计算与卫星遥感的意义。

Google开源TorchTPU:PyTorch原生后端打通TPU生态
Google开源TorchTPU,为TPU提供PyTorch原生后端。本文解析其与XLA路线的差异、对CUDA生态的潜在影响,以及开发者迁移时需关注的成本与性能问题。
谷歌开源TorchTPU:PyTorch原生后端如何重塑TPU生态
谷歌与Meta联合开源TorchTPU,这是面向Cloud TPU的PyTorch原生后端,默认eager执行并支持torch.compile与XLA编译,将替代PyTorch/XLA用于新工作负载。本文解析其架构定位、执行模式取舍及对开发者与TPU生态的实际影响。
TorchTPU发布:PyTorch原生支持谷歌TPU
Google与Meta联合发布TorchTPU,为PyTorch提供原生TPU后端,支持模型开箱即用运行。本文解读这一开源协作的技术定位、对开发者的迁移成本影响,以及尚待验证的性能与治理问题。
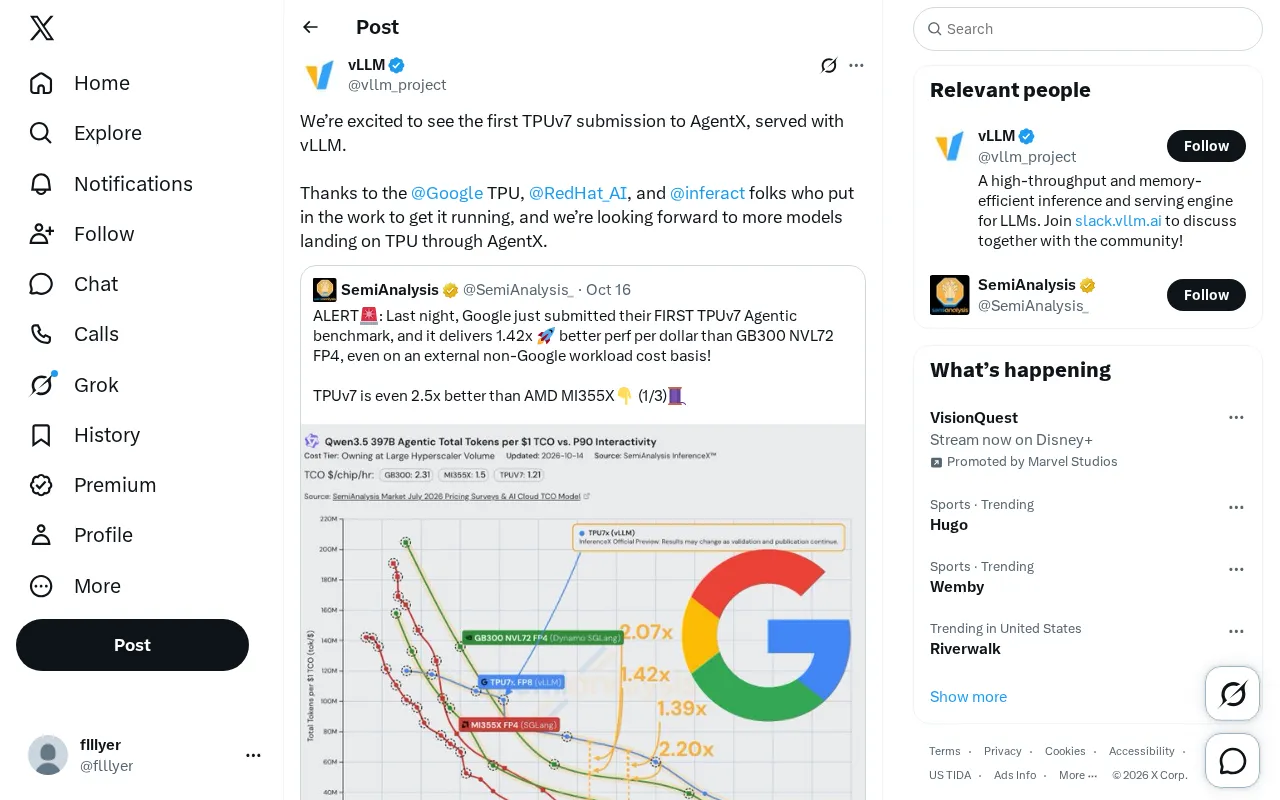
首个TPUv7提交AgentX:vLLM助力谷歌TPU生态再下一城
AgentX平台迎来首个基于TPUv7的模型提交,通过vLLM完成服务部署,谷歌TPU、Red Hat AI与inferact三方协作落地。本文解读该事件对vLLM与TPU生态兼容性的意义及后续看点。

Torch-TPU:让SGLang与vLLM原生跑在TPU上
Google 与 Meta 在 PyTorch 大会介绍 Torch-TPU:一个 PyTorch 原生 TPU 后端,让 SGLang 和 vLLM 推理引擎原生运行在 TPU 上,保留调度器、批处理与服务 API,实现模型与新特性零成本流转。
谷歌Project Suncatcher:TPU芯片首次搭乘SpaceX进入太空测试
谷歌Project Suncatcher项目将搭乘SpaceX的Transporter-18任务发射,测试TPU芯片能否在太空环境中存活运行。这颗与Planet合作打造的原型卫星,旨在验证利用太阳能构建太空AI算力的可行性。
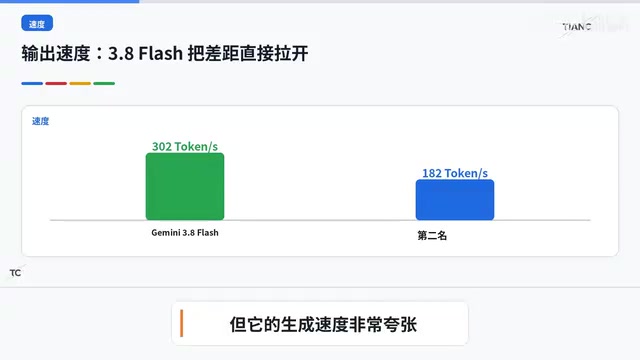
Gemini 3.5 Pro难产背后:谷歌为何疯狂押注Flash
Gemini 3.5 Pro延期难产,谷歌却疯狂迭代3.8 Flash。本文从智能、速度、单位任务成本与TPU算力能效角度,解析谷歌如何重新定义大模型战争,从军备竞赛转向工业竞赛。