Google开源TorchTPU:PyTorch原生后端打通TPU生态

TorchTPU 以原生后端替代 XLA 翻译层,降低 PyTorch 迁移 TPU 的成本。
文章围绕 Google 开源的 TorchTPU 展开,指出其定位是 PyTorch 的 native back end,而非在 PyTorch 与 TPU 之间再加一层图转换器。过去在 TPU 上运行 PyTorch 需经 XLA 桥接,开发者要显式处理设备标记与图捕获,并承担算子覆盖不全、调试割裂、性能不符预期等隐性成本。TorchTPU 试图让 PyTorch 的执行语义直接落到 TPU,把编译细节收进后端内部,从而降低迁移改动量,对依赖动态控制流与自定义算子的研究项目尤为关键。文章还分析了 Google 以独立组织开源的信号意义,以及 CUDA 在算子库、调试工具与社区积累上的壁垒,并给出迁移成本、性能兑现、调试体验三项开发者应重点评估的指标。
从"适配"到"原生":TorchTPU想解决什么问题
PyTorch 早已是深度学习研究与工程落地的事实标准,而 Google 的 TPU 一直以性能见长,却长期处在 PyTorch 生态的边缘。过去在 TPU 上跑 PyTorch,通常要经过 XLA 桥接层做图转换,开发者会遇到算子覆盖不全、调试链路割裂、性能不符合预期等隐性成本。
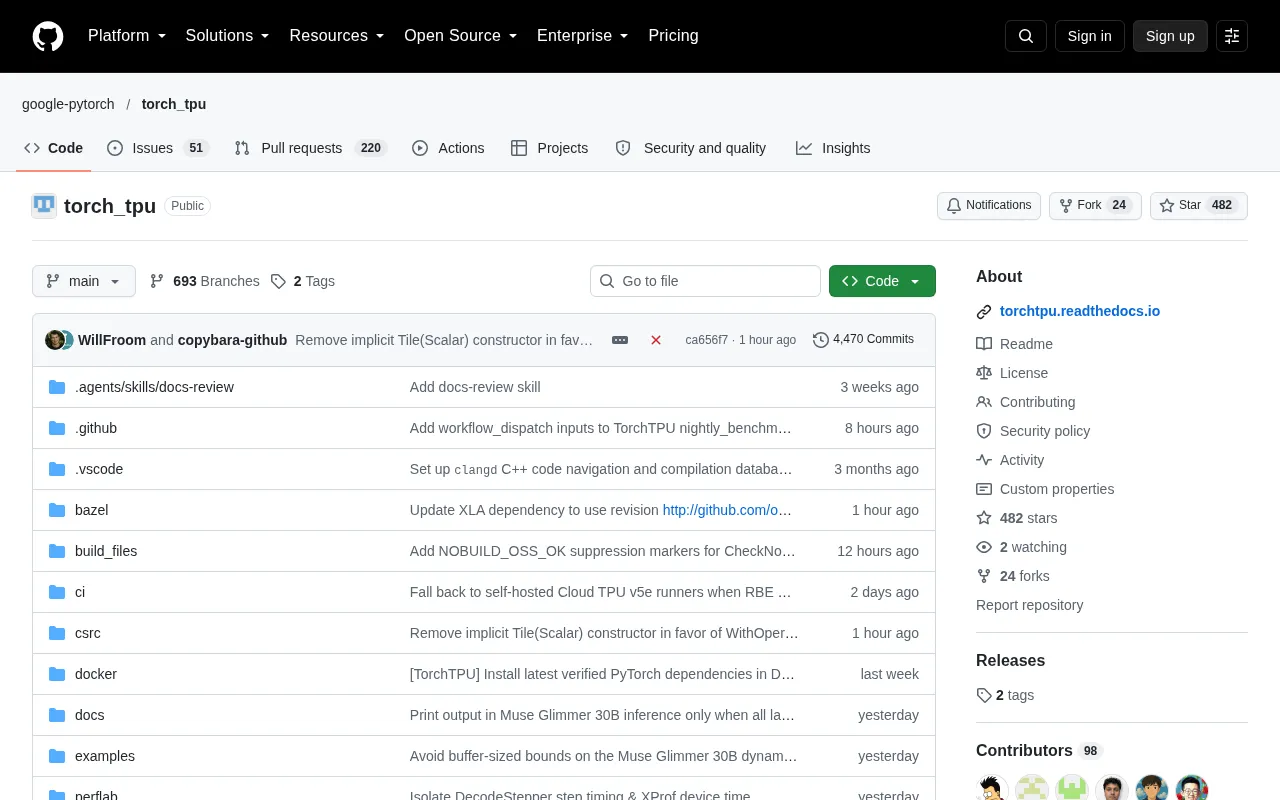
Google 开源的 TorchTPU(仓库地址 github.com/google-pytorch/torch_tpu)定位为"native PyTorch back end",关键词在 native——它不是再包一层转换器,而是试图让 PyTorch 的执行语义直接落到 TPU 上。对长期被 CUDA 生态绑定的训练框架来说,这一步的意义不只是多一个硬件选项。
该项目在 Hacker News 上获得 344 分、73 条评论,讨论热度集中在两点:PyTorch 用户能否真正"零成本"迁移,以及 Google 是否愿意把 TPU 从自家框架的护城河里放出来。
后端意味着什么:PyTorch 与 TPU 的接缝在哪
后端抽象的层次
PyTorch 的硬件后端通常涉及设备管理、算子派发、内存分配与编译器协同几个层面。TorchTPU 作为后端项目,核心工作是把 PyTorch 的算子与调度映射到 TPU 的编译执行模型上,同时保持 eager 模式的开发体验。
**算子派发(operator dispatch)**是理解 PyTorch 后端机制的关键。PyTorch 在运行时根据张量所在的设备类型与数据类型,通过 dispatcher 将每个算子路由到对应的内核实现;CUDA 后端注册的是 GPU kernel,CPU 后端注册的是 CPU kernel。一个「原生后端」的工作,就是为 TPU 注册一整套算子内核与调度规则,让 torch.matmul 这类调用无需用户改写即可落到 TPU 上执行。这也解释了为什么算子覆盖度是后端成熟度的硬指标:未被注册的算子会回退到 CPU,造成设备间数据搬运,性能断崖式下降。
eager 模式与图模式的分野同样重要。eager 模式逐算子立即执行,便于调试但难以做全局优化;图模式先捕获完整计算图再编译,利于融合与内存规划。TPU 的编译执行模型天然偏向图模式,因此原生后端必须在两者间做权衡,既保留 eager 的开发体验,又在内部完成图捕获与编译。
与 XLA 路线的差异
既有的 PyTorch/XLA 方案本质上是把 PyTorch 图翻译给 XLA 编译器,开发者往往需要显式处理设备标记与图捕获。TorchTPU 若能做到原生后端,意味着编译细节更多由后端内部消化,用户的代码改动量会显著下降。这对依赖动态控制流、自定义算子的研究型项目尤其关键。
**XLA(Accelerated Linear Algebra)**是 Google 主导的开源编译器,负责把高层计算图下降为针对特定硬件(TPU、GPU、CPU)优化后的机器码,核心手段包括算子融合、内存布局优化与流水线调度。PyTorch/XLA 的方案依赖 xla_device 与 lazy tensor 机制:张量上的操作先被记录成图,直到需要具体数值时才触发编译执行。这种惰性求值正是开发者需要显式处理图捕获与设备标记的根源,也使动态控制流与自定义算子的支持变得棘手。
TorchTPU 若走原生后端路线,本质是把 XLA 作为内部实现细节而非用户可见的编程模型,由后端自行决定何时构图、何时编译。这种分层差异决定了迁移成本的高低:前者要求用户理解编译器的边界,后者把边界收进后端内部。
生态博弈:TPU 的开放与 CUDA 的护城河
Google 把 TorchTPU 放到独立的 google-pytorch 组织下开源,而不是只留在 TensorFlow 体系内,这是一个值得注意的信号。TPU 的竞争力长期受限于"只能用 JAX/TensorFlow"的刻板印象;一旦 PyTorch 能在 TPU 上获得接近原生的体验,云上算力采购的决策逻辑就会松动——模型代码不再需要为硬件重写。
反过来说,CUDA 的壁垒并不只在硬件性能,更在算子库、调试工具与社区积累。TorchTPU 能否形成同等厚度的工具链,决定了它是一次"能用"的补充,还是"好用"的替代。开源是降低信任门槛的第一步,但生态建设是长期工程。
CUDA 护城河的构成值得拆开看。除硬件本身,它还包括 cuBLAS、cuDNN、NCCL 等高度优化的算子与通信库,Nsight 系列 profiler 与调试器,以及十余年积累的教程、问答与第三方框架适配。这些资产形成正向循环:开发者越多,算子与工具越完善,迁移意愿越强。TPU 侧对应的 XLA 编译器、PJRT 运行时与 JAX 生态在性能上并不逊色,但面向 PyTorch 用户的工具链厚度明显不足,这正是 TorchTPU 需要补齐的部分。
云算力采购的决策逻辑也受此影响。企业选型时,模型代码与硬件解耦程度直接决定议价空间:若迁移只需改配置而非重写算子,多供应商竞价才具备可行性。TorchTPU 的象征意义在于降低这种解耦的门槛,但真正形成替代,仍需在 profiler、分布式通信与自定义算子扩展等工程细节上达到与 CUDA 可比的水准。
开发者该关注什么
迁移成本。 现有 PyTorch 项目切换后端的改动量、对自定义算子的支持度,是最直接的评估指标。
性能兑现。 TPU 的算力优势需要在真实负载上体现,尤其是大模型训练中的通信与内存效率。
调试体验。 错误栈是否可读、profiler 是否可用,往往比峰值性能更影响日常开发效率。
对研究者而言,多一条不依赖 CUDA 的路径本身就是价值;对企业而言,算力供应的可替代性直接关联成本结构。TorchTPU 的成熟度还需要时间验证,但它把 PyTorch 与 TPU 之间的那道缝,从"翻译"改成了"对接"。
相关推荐
ChatGPT正在为你建立心理画像:隐私边界再引争议
Reddit热帖讨论ChatGPT是否在为用户建立心理画像。本文解析对话记忆、情绪信号与行为数据如何累积成心理侧写,探讨个性化服务与隐性监控的边界,并给出用户保护隐私的实用建议。
多AI智能体邮件身份管理:别名、独立收件箱还是API方案?
多个AI智能体如何管理邮件身份?本文分析邮件别名、独立收件箱和API按需创建三种方案的优劣,并给出按智能体角色分层管理的实践建议,帮助团队在安全隔离与运维效率之间取得平衡。
iPhone Duo碎屏门:YouTuber拆解揭示铰链缺陷
苹果iPhone Duo折叠屏手机爆发碎屏门,用户报告铰链处屏幕快速开裂。YouTuber拆解发现铰链设计缺陷或异物入侵,导致应力集中。事件引发社区热议,苹果尚未回应,折叠屏可靠性再受质疑。