数据融合破解测量误差难题:Fuse-EIV方法解析

Fuse-EIV利用异质外部重复测量数据,在条件可迁移性假设下有效校正目标研究中的变量测量误差。
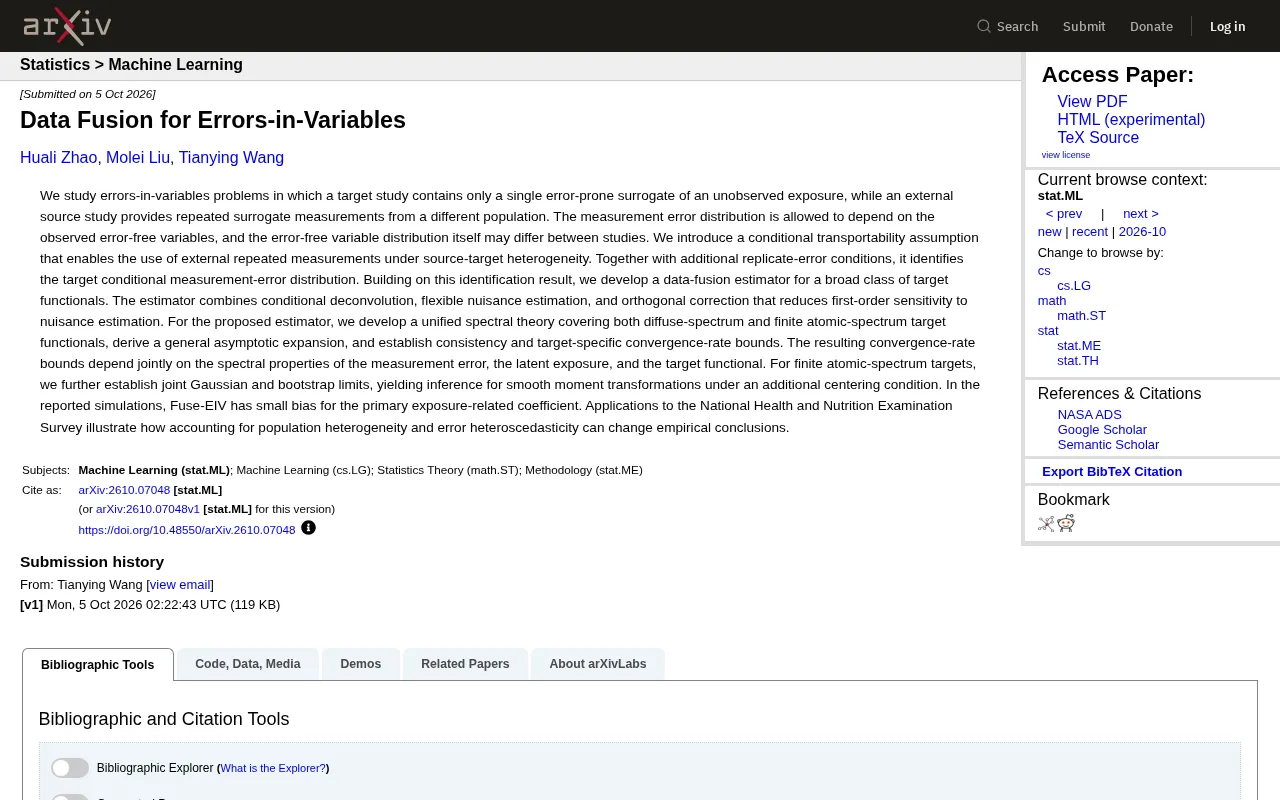
Fuse-EIV是一种针对「变量含误差」(EIV)问题的数据融合统计方法,专门应对目标研究仅有单次含误差替代测量、而外部异质人群提供重复测量数据的现实场景。研究的理论核心是「条件可迁移性假设」,允许在两个人群分布不同、误差存在异方差性的条件下,合法借用外部重复测量来识别目标人群的条件测量误差分布。估计器整合了条件去卷积、灵活冗余参数估计和正交校正三项技术,后者借鉴双重/去偏机器学习思想,降低了对中间估计误差的敏感性。论文还发展了覆盖弥散谱与有限原子谱两类目标泛函的统一谱理论,提供收敛速率界与自助法推断。NHANES实证分析表明,正确处理人群异质性与误差异方差性会实质性地改变研究结论,忽视这些因素可能导致系统性偏误。
测量误差问题的现实困境
在流行病学、经济学和公共卫生研究中,研究者经常面临一个棘手的问题:真正想研究的变量(暴露因素)无法被直接观测,手头只有带误差的替代测量值。比如营养摄入、血压长期水平、环境污染暴露等,往往只能通过一次性问卷或单次检测近似获得。这类「变量含误差」(errors-in-variables, EIV)问题如果处理不当,会导致回归系数估计出现系统性偏差,进而扭曲最终的科学结论。
一篇发表于 arXiv 的新研究(arXiv:2610.07048)针对这一难题提出了名为 Fuse-EIV 的数据融合方法。其核心场景极具现实意义:目标研究(target study)中每个个体只有单次含误差的替代测量,而一个来自不同人群的外部来源研究(source study)则提供了重复测量数据。如何借助外部的重复测量来校正目标研究的误差,正是该工作要解决的问题。
条件可迁移性:跨人群借力的关键假设
这项研究最具价值的贡献之一,是正视了「两个研究来自不同人群」这一现实。传统误差校正方法通常假设外部验证样本与主研究同分布,但现实中外部数据往往来自另一个群体,其无误差变量的分布本身就可能不同,而测量误差的分布还会依赖于这些可观测的无误差变量(即误差的异方差性,heteroscedasticity)。
论文引入了「条件可迁移性假设」(conditional transportability assumption),使得在源-目标人群存在异质性的情况下,仍能合法地使用外部重复测量。配合额外的重复误差条件,该假设能够识别出目标人群的条件测量误差分布。这是整个估计框架成立的理论基石——没有可识别性,后续的估计与推断都无从谈起。
可迁移性(transportability) 是因果推断中处理研究人群与目标人群不一致问题的一套系统性框架,由Pearl和Bareinboim等人在2010年代前后发展完善。其基本问题是:在源人群中估计的因果效应或分布特征,在何种条件下可以合法地「迁移」到目标人群?一般可迁移性依赖于对两个人群在可观测协变量上的选择差异进行显式建模,并通过重加权或回归调整来消除人群间分布偏移。Fuse-EIV中的「条件可迁移性假设」是这一思想在测量误差场景下的定制化应用:它不要求两个人群的暴露分布相同,而是假设在给定可观测的无误差协变量后,测量误差的生成机制在源人群与目标人群之间具有某种一致性,从而可以用源人群的重复测量来推断目标人群的条件误差分布。这一假设比完全同分布假设宽松得多,但仍需研究者在具体场景中仔细评估其合理性。
估计器的三大技术支柱
基于上述识别结果,作者构建了一个适用于广泛目标泛函(target functionals)的数据融合估计器。它整合了三项关键技术:
条件去卷积(conditional deconvolution):从含误差的观测分布中还原出潜在暴露的真实分布。
灵活的冗余参数估计(flexible nuisance estimation):允许使用现代机器学习等灵活方法估计中间量,而非拘泥于严格的参数模型。
正交校正(orthogonal correction):降低估计结果对冗余参数估计误差的一阶敏感性。这一思路与近年来兴起的双重/去偏机器学习(double/debiased ML)一脉相承,能让估计在冗余参数收敛较慢时仍保持良好性质。
双重/去偏机器学习(Double/Debiased ML) 是近年来计量经济学与统计学交叉领域的重要进展,由Chernozhukov等人于2018年系统提出。其核心思想是:当目标参数的估计依赖于若干「冗余参数」(nuisance parameters,如条件均值函数、倾向得分等)时,若直接将机器学习估计的冗余参数代入目标估计量,偏差会以难以控制的方式累积。双重/去偏ML通过构造对冗余参数「Neyman正交」的估计方程,使目标参数估计的偏差从线性依赖于冗余参数误差降阶为二次依赖,从而允许冗余参数以较慢的速率收敛,同时目标参数仍能达到参数级的收敛速率并满足中心极限定理。Fuse-EIV中的正交校正正是借鉴了这一框架,使得在条件去卷积等中间步骤引入灵活机器学习方法时,最终的泛函估计仍具备可靠的统计性质。
统一的谱理论与收敛速率
在理论层面,论文发展了一套统一的谱理论(spectral theory),同时覆盖「弥散谱」(diffuse-spectrum)与「有限原子谱」(finite atomic-spectrum)两类目标泛函。作者推导了一般性的渐近展开,建立了相合性(consistency)以及针对具体目标的收敛速率界。
值得关注的是,这些收敛速率界并非孤立决定,而是联合依赖于三方面的谱性质:测量误差本身、潜在暴露,以及目标泛函。这意味着估计的难易程度取决于问题的整体结构,而非单一因素。对于有限原子谱类目标,作者进一步建立了联合高斯极限与自助法(bootstrap)极限,在额外的中心化条件下,为光滑矩变换提供了可用的统计推断工具。
谱方法(spectral methods) 在测量误差文献中的应用源于一个关键观察:含误差观测变量的特征函数(characteristic function)等于真实变量特征函数与误差特征函数的乘积。因此,去卷积问题在频域(傅里叶域)中可以被表述为一个除法运算,其难度直接取决于误差分布特征函数的衰减速率——衰减越快(如超光滑误差),识别和估计越困难。「弥散谱」与「有限原子谱」之分对应目标泛函在频域中的能量分布方式:有限原子谱目标(如有限混合分布的矩)仅依赖有限个频率点的信息,因而理论分析更为精细,可建立联合高斯极限;弥散谱目标则需要对连续频率范围的积分,收敛速率往往受制于误差的超光滑程度。这套统一框架的贡献在于,将原本需要分情形讨论的问题纳入同一理论体系,给出可比较的速率界。
模拟与实证:异质性为何重要
理论之外,论文通过模拟实验验证了方法的表现:Fuse-EIV 对主要的暴露相关系数估计偏差很小,说明误差校正是有效的。
更有说服力的是对美国国家健康与营养调查(NHANES)数据的应用。研究展示了当分析中正确考虑人群异质性和误差异方差性后,实证结论会发生改变。这一点对应用研究者尤为重要——它提示我们,若忽视外部数据与主研究之间的人群差异、或假设误差方差恒定,得出的结论可能带有偏误。
对实证研究的意义
Fuse-EIV 代表了因果推断与测量误差校正领域一个务实的方向:不追求外部数据与主研究完美匹配的理想假设,而是在承认异质性的前提下设计可迁移、可识别、可推断的估计框架。对于大量依赖替代测量、且只能借助异质外部数据集的观测性研究而言,这类方法提供了更稳健的分析路径。
需要说明的是,这是一篇理论性较强的统计方法学论文,实际落地仍需研究者具备相应的建模能力,并仔细核验条件可迁移性等关键假设在具体场景中是否合理。
相关推荐

开源多Agent模拟经营项目实战评测
基于B站UP主开源的多Agent沙盘经营项目实测,拆解其规划、记忆、多Agent通信、HITL与评估机制,对比大模型自主决策与固定规则引擎在不同场景下的收益差异,为Agent开发者提供选型与工程实践参考。
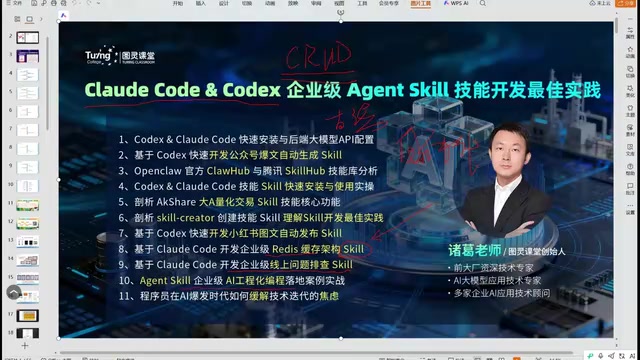
AI工程化实战:Claude Code与Agent Skill开发全流程
B站实战课解析AI工程化:用Claude Code、Codex、WorkBuddy开发企业级Agent Skill,涵盖公众号报文、量化分析、小红书自动发布等案例,讲透Skill驱动开发的范式转移与工具选型。
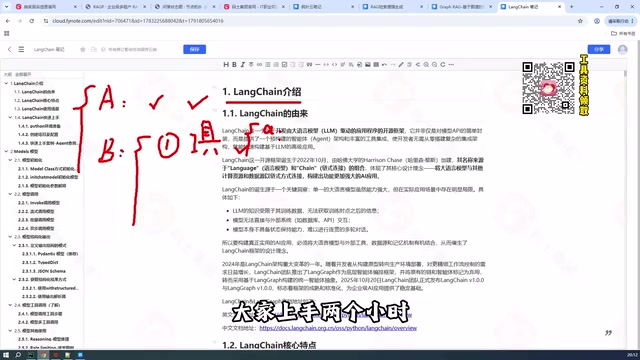
LangChain零基础入门:结构化输出与Agent实战指南
从LangChain零基础讲起,厘清低代码平台与大模型应用开发的本质区别,覆盖结构化输出、工具调用、Agent实战与多租户RAG企业项目落地四大模块,适合有开发基础想转型AI应用开发的工程师。