双机DGX Spark对决M5 Ultra:本地AI谁更能打?
实测对比揭示M5 Ultra在长上下文和投机解码上的隐藏短板,双机DGX Spark综合性能未必更弱。
B站UP主小蛋糕通过实测与推演对比了双机DGX Spark与苹果M5 Ultra的本地大模型推理性能。表面上M5 Ultra内存带宽占优,但BF16算力仅为半个Spark;在长上下文场景下,Spark衰减更慢,M5 Ultra输入速度可能仅为其一半。更关键的是投机解码:该技术在Spark上带来两倍加速,而M5目前仅有4%–40%提升,构成英伟达生态的核心护城河。苹果未来或可通过int8核心优化和ANE神经引擎逆向突破实现约两倍提升,但现阶段尚不成熟。综合散热稳定性、CUDA软件生态成熟度等因素,UP主最终选择保留Spark,而非购入M5 Ultra。
本地AI硬件的选择正在成为不少开发者和AI爱好者纠结的问题。B站UP主小蛋糕在入手两台DGX Spark后不久,苹果就发布了M5 Ultra,于是他通过一系列实测与推演,试图回答一个核心问题:跑本地大模型,双机Spark和M5 Ultra到底该买哪个?结论可能出乎很多人意料——M5 Ultra或许没有大家想象的那么强。
算力与带宽:M5 Ultra的账面参数解读
从内存带宽和算力的价格对比来看,M5 Ultra的性能基本等同于两台M5 Max,符合发布前的预期。但它在BF16算力上仅相当于半个Spark。有意思的是,一旦进入FP4精度,两者的算力差距会明显缩小——因为M5 Ultra的FP8、FP4浮点算力和BF16是一致的。
作为参照,两台Spark大致相当于半张RTX Pro 6000,而后者当前价格已经从一万美元涨到了一万五千美元。这意味着单纯看性价比,双机Spark并非没有竞争力。
很多人只看到M5 Ultra的内存带宽碾压Spark,就断定它综合性能更强。但UP主的实测分析指出,事情远没有这么简单。
长上下文衰减:Spark的隐藏优势
真正拉开差距的,是长上下文场景下的性能衰减。
实测显示,双机DGX Spark在0到64K范围内输入速度基本不变,稳定在2300 token/秒左右,之后才开始缓慢下降。而M3 Ultra从16K左右就开始衰减,到500K时增量速度已经降到峰值的三分之一到四分之一,Spark在同样位置还能保持二分之一左右。
这里有个容易被忽略的统计陷阱:输入速度有"增量统计"和"平均统计"两种口径,网上评测常常不说明用的是哪种,而平均口径看起来会更高。对Agentic工作流而言,增量统计更贴近真实体验。
按照M5 Ultra相对M3约3到4倍算力推算,其长上下文输入速度可能依然只有双机Spark的一半左右。考虑到未来Agent流程中长上下文会越来越常见,尤其是coding场景的"长上下文冷启动",在Mac上的等待相当痛苦,这一点值得高度关注。
长上下文场景下的性能衰减,根源在于Transformer架构的注意力机制(Attention)计算复杂度随序列长度增长而上升,以及KV Cache(键值缓存)占用的显存/内存随上下文变长而线性膨胀。KV Cache需要实时从内存读取,因此内存带宽成为长上下文推理的核心瓶颈之一。当KV Cache体积超过芯片缓存容量后,每步解码都需要从主内存频繁调取大量数据,带宽压力骤增,速度随之下滑。此外,部分硬件在处理超长序列时,注意力计算的实现效率也会显著下降——文中提到M5微架构在长上下文attention和indexer方面效率偏低,正是这一问题的体现。"增量统计"与"平均统计"的差异也在此场景下尤为关键:平均统计掩盖了后期严重的速度跌落,而Agent流程中每一步新增token的实际等待时间,才是用户真实感知到的体验。
投机解码:英伟达生态的护城河
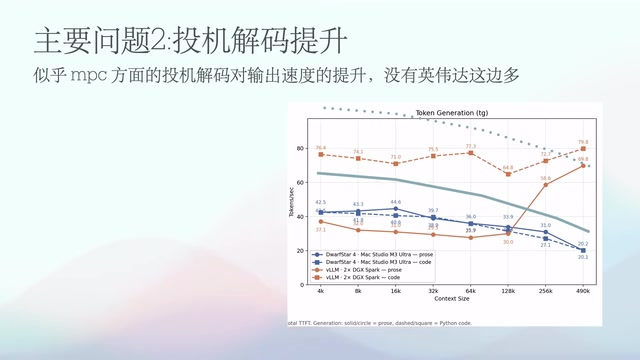
投机解码(speculative decoding)是Spark翻身的关键。在Spark上,投机解码能带来整整两倍的提升,这也是当年被嫌弃的Spark如今变成香饽饽的原因。
UP主用了一个精妙的比喻:英伟达在整个AI界是"低息利益"般的存在——当苹果还在琢磨如何用内存换带宽、换算力时,整个行业都在帮英伟达研究如何用剩余算力弥补带宽不足。投机解码正是典型例子,它能在N卡上用富余算力极大补偿内存带宽短板。
反观苹果,目前观测到的M5投机解码提升仅在4%到40%之间,M3 Ultra几乎没有提升,代码和文本场景开不开投机解码没什么区别。当然这可能是软件问题——有个叫MTP LX的项目已经能在M5 Max上对某模型实现两倍解码加速。如果M5 Ultra能实现两倍提升,coding场景会强过Spark;如果做不到,那么优势就没那么明显。
UP主实测双机Spark输出速度稳定在40到45 token/秒,长上下文下也能维持这个区间。如果M5 Ultra的投机解码提升有限,长上下文下和Spark的差距其实并不大。
投机解码是一种通过引入小型"草稿模型"来加速大模型推理的技术。其基本原理是:先让一个参数量极小的草稿模型快速生成若干候选token,再由目标大模型并行验证这些候选token是否可接受。由于验证可以批量并行执行,而草稿模型生成速度极快,整体上能大幅减少大模型串行推理的轮次,从而在不损失输出质量的前提下显著提升token生成速度。这项技术的关键前提是系统存在"算力冗余"——即GPU的计算单元在标准推理中因内存带宽瓶颈而处于等待状态,有空闲算力可以用来并行运行草稿模型和验证步骤。英伟达GPU算力远超内存带宽的架构特点,使其天然适合这一优化;而苹果芯片的设计哲学是让算力与带宽更加均衡,冗余算力有限,这直接导致投机解码在Apple Silicon上的收益远低于CUDA平台。
多机互联:老黄的"刀法"精准在哪
扩容互联是绕不开的话题。互联要考虑延迟和带宽两个维度:延迟影响decode阶段(张量并行有大量小消息操作),带宽影响长上下文prefill和大batch推理。
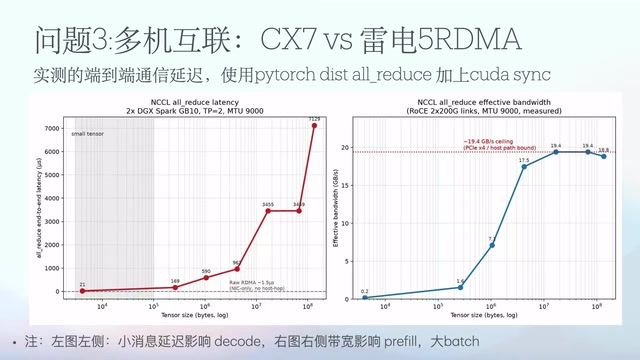
实测发现,Spark上的CX7号称1.5微秒延迟,但由于RDMA要绕CPU一圈才到GPU,实际延迟约20微秒。UP主感叹"老黄的刀法相当精湛"——这个成绩相对NVLink很差,但相对雷电5和PCIe依然优秀。
对个人双机互联而言,延迟和带宽带来的损耗只有约5%。但如果输出超过100 token/秒,延迟占比会超过10%;若要大规模扩容与云厂商竞争,则完全不可能。苹果这边基于雷电5的RDMA刚刚落地,物理延迟看似更高,但算上整个通路可能和Spark差不多,只是带宽偏小,大batch和长prefill会更受限。
RDMA(远程直接内存访问)是一种允许网络中的计算机直接读写对方内存、绕过操作系统内核的高速互联技术,常见于数据中心的InfiniBand和RoCE网络。DGX Spark所配备的ConnectX-7(CX7)网卡正是基于InfiniBand/RDMA标准,标称延迟1.5微秒。然而文中指出,Spark的RDMA通路需要"绕CPU一圈才到GPU",实际端到端延迟升至约20微秒,这与NVLink直连GPU的延迟(通常在亚微秒级别)相比差距显著。NVLink是英伟达专有的GPU间高速互联总线,带宽和延迟均远优于任何基于PCIe或网络的方案,但被英伟达保留在DGX H系列等高端产品线中,Spark作为面向个人的边缘设备并未配备,这正是作者所说"老黄刀法精准"的含义——恰好卡住了多机扩展的上限。
软件生态:M5的提升空间在哪里
M5 Ultra的一个潜在变数在于软件生态。VLM、SGLang等英伟达软件栈非常成熟,而苹果生态若能补齐,M5的理论上限值得期待。
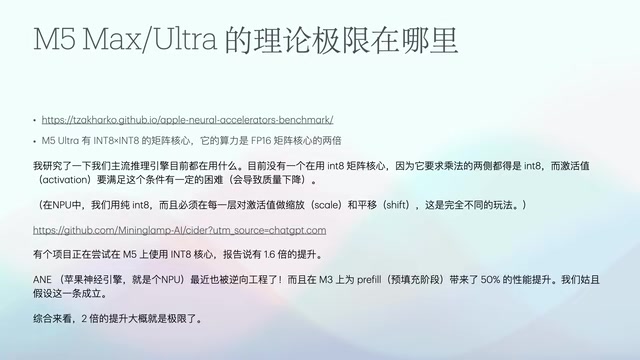
先说坏消息:M5的微架构似乎仍落后英伟达Blackwell一代,在长上下文attention、indexer等方面效率明显偏低,这可能解释了它衰减更快的原因。
好消息则有两个技术方向。其一是int8矩阵核心:M5的int8算力是BF16的两倍,而FP4可以完美用int8表示。GitHub上已有项目尝试用M5的int8核心运算,报告了1.6倍提升。不过int8激活量化会影响模型质量,目前主流推理引擎还没人这么用,技术尚不成熟。其二是苹果ANE神经引擎近期被逆向破解,有人报告在M3上能给prefill带来50%性能提升。若两者都能落地,M5这一代输入速度相比当前可能还有约两倍提升空间,届时与Spark的差距会大幅拉近。
散热与内存:容易被忽略的细节
散热方面差异明显。Spark运行时其实不算吵,满功率噪音与M3 Ultra相当,但内部温度上升下降都极快——满载两三分钟,即便是用料更足的华硕版Spark,CPU也会冲到90度以上。同样负载下M3 Ultra只到60度,长时间满载也仅72度左右。想省心的话,苹果的稳定性和散热设计完全不是一个量级,Spark可能需要散热改装。
内存利用上,多机Spark有个小劣势:每台机器都要运行系统和VLM本身,实际可给模型和KV Cache用的内存会比苹果的大统一内存少一些。跑超大模型的极限场景下,多机Spark可用的KV Cache会稍微吃紧。
本地AI的价值与最终选择
如果只算电费,本地AI绝无胜算——B200这类大机器每token耗电相比GB10有两个数量级差距。本地AI的真正价值在于隐私(敏感数据处理)、速度(好机器可比任何云端API更快,对创业和紧急研发无可匹敌)、小众模型支持,以及可靠性(云端服务商质量参差,本地配置好后不会降智,且可测试超长上下文下的可靠性)。
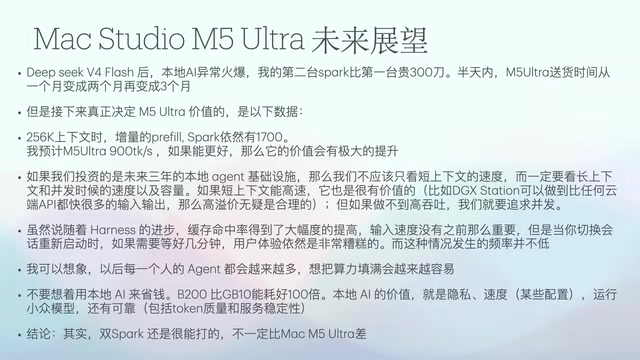
UP主的最终决定是:不买M5 Ultra,保留Spark。除了性能考量,更关键的是他要做AI实验,CUDA平台库拿来即用,阻力远小于苹果生态,且实验对算力要求更高。但如果你更看重解码视频或做家庭主控中心,Mac的优势依然很大。
结论是:双机Spark在绝对性能上不一定比M5 Ultra差(注意不是性价比),这取决于你的负载偏prefill还是decode。随着Harness进步、缓存命中率提升,decode比重会上升,但个人使用中多绘话切换带来的冷启动等待,仍是体验的关键变量。真正决定M5 Ultra价值的,是它在长上下文下的实际性能曲线——如果256K能跑到900 token/秒,可用性会大幅提升。至于UP主本人,他更期待M7系列。
相关推荐
Fable 5.2灰度测试曝光:Anthropic或将超越GPT-6 Astra
Anthropic疑似灰度测试Fable 5.2和Opus 5.2,社区测试者称其推理能力超越GPT-6 Astra,但代价是更慢的生成速度与更高成本。本文梳理泄露细节、IPO商业博弈与AI安全叙事争议,并提醒相关信息未获官方证实。
免费调用 GPT-6 Astra:配合 Cline 实测生成 4 款 3D 游戏
详解如何免费试用 GPT-6 Astra 模型:通过 Zenslab 关联 Telegram 领取积分,配合 VS Code 的 Cline 扩展接入 API,实测生成烹饪游戏、战术射击及 Dust2 地图等 4 款 3D 游戏,并分析免费额度的实际能力与限制。
警惕第三方ChatGPT充值陷阱:三种方式的风险辨析
针对社交平台流行的第三方ChatGPT充值教程,本文客观辨析代充网站、境外信用卡直充、移动端内购三种方式的流程与风险,重点提示所谓"不给密码就安全"的误导性及封号隐患。