思维链(CoT)为何提升推理能力?四层本质深度拆解

引言:一个高频面试题背后的深度
在大模型相关的技术面试中,「思维链(Chain-of-Thought,CoT)为什么能显著提升模型推理能力」是出镜率极高的考题。大多数候选人会给出「让模型逐步拆解问题、一步步思考」这样的标准答案——方向不错,但深度明显不够。一旦面试官追问「为什么分步思考就能提升推理效果」,大部分人便会卡壳。
本文从底层计算原理出发,完整拆解思维链背后的核心逻辑,并结合 DeepSeek广告 R1 的强化学习实证,帮你建立对 CoT 的系统性认知。
第一层本质:算力固定,token 数量决定思考深度
理解思维链,要先明确大模型最基础的一个计算特性:模型每生成一个 token,所消耗的算力开销是固定值,与任务难度无关。无论是简单问答还是复杂的多步推理,单个 token 消耗的计算资源完全相同。
这一特性根植于 Transformer 架构的工作方式。每次前向传播(Forward Pass)生成一个 token 时,模型都需要经过完整的多头注意力计算和前馈网络层,这个计算量由模型参数规模决定,与问题难度完全解耦。以 GPT-4 级别的模型为例,单次前向传播涉及数千亿次浮点运算,但无论输入是「1+1等于几」还是「证明黎曼猜想」,每个 token 的计算成本相同。这种架构特性决定了:要让模型处理更复杂的问题,唯一合法的路径就是增加 token 数量,而非期望单个 token 承载超出架构上限的计算量。
这就引出第一个关键结论——模型的思考深度,实际上由输出 token 的数量决定。
以算术为例:直接要求模型输出 123 × 456 的结果,它只能依靠单个(或极少数)token 完成全部运算,几乎没有中间计算空间。但若要求输出完整的演算步骤,数十个 token 便构成一条完整的计算链路,为模型提供了充足的「运算空间」。
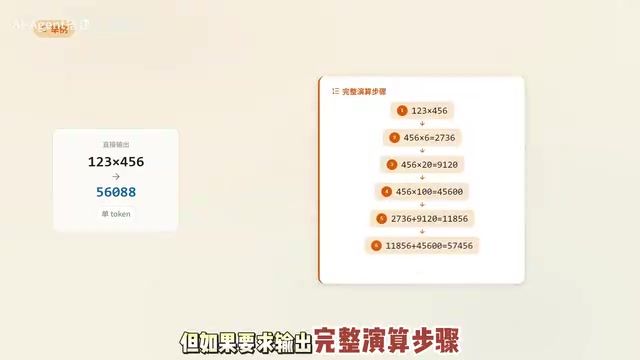
因此,思维链的第一层本质在于:通过增加输出 token 的数量,延长模型的完整计算链路,让原本挤压在单步的复杂运算得以在多步中展开。
第二层本质:将工作记忆外部化
仅有更多计算量,还不足以完整解释推理能力的提升。我们还需要关注模型的上下文机制。
模型在生成文本时,只能读取已经生成的前文内容,无法预知后续信息。这意味着:如果不输出中间推导步骤,那些中间计算结果就不会保存在上下文里,后续推理环节也就无法复用前置结论。
从技术层面看,Transformer 的注意力机制(Attention Mechanism)允许模型在生成每个新 token 时,对序列中所有历史 token 进行加权访问。这在本质上等价于一种「可寻址的外部存储器」——只要中间计算结果以 token 形式存在于上下文中,后续计算步骤便可通过注意力权重精确检索并复用。这与人类工作记忆(Working Memory)的局限性形成鲜明对比:人类工作记忆容量约为 7±2 个组块(Miller's Law),而模型的上下文窗口可达数万乃至数十万 token,将推理步骤外部化后,理论上不存在「记忆容量瓶颈」。
这里有一个贴切的人类类比:心算 17 × 24 时,需要在脑中同时记住 17 × 4 = 68 和 17 × 20 = 340 这两组中间值,再进行求和。记忆负荷极高,极易出错。而把步骤写在纸上,每步只做简单运算,历史结果随时可查,出错概率大幅降低。
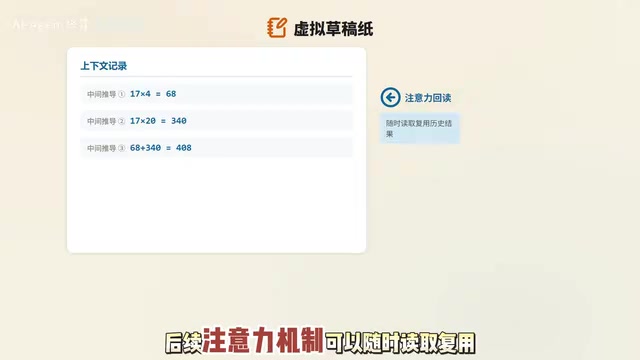
思维链就相当于给模型配备了一张「虚拟草稿纸」:把所有中间推导结果存入上下文,借助注意力机制可以随时读取和复用。这是第二层本质——将模型内部的工作记忆外部化,分摊单步推理的认知压力。
第三层本质:唤醒预训练中的链式推理范式
第三层逻辑来自预训练数据的「范式沉淀」。
预训练语言模型通过在海量文本上进行下一 token 预测任务(Next Token Prediction)来学习,这一过程本质上是对人类书面知识的高度压缩与模式提取。海量的预训练文本中,大量链式推理内容无处不在:数学证明、分步推导、逐行实现的代码、分层论证的学术观点……模型在拟合这些数据分布时,被迫习得「前提→推导→结论」的固定范式。
当我们使用「让我们一步步思考」这类 CoT 提示词时,实际上是在统计意义上将模型引导至训练数据中「高质量链式推理」的分布区域,而非「直接给答案」的低质量问答区域。反之,若直接提问求答案,模型会优先匹配简短的问答范式,直接输出结论。这一现象在大模型研究中也被归类为「涌现能力」(Emergent Abilities)的一种表现形式。
特定的提示格式能够唤醒模型在预训练阶段习得的链式推理能力。 思维链提示词并非在教模型新技能,而是激活了它本已具备的推导能力。
实证支撑:DeepSeek R1 的 Aha Moment
DeepSeek R1 的强化学习实验为上述理论提供了有力的实证支撑。
研究团队直接以基座模型开展强化学习,跳过了监督微调(SFT)阶段,观察模型能否自主掌握推理逻辑。DeepSeek R1 采用的核心方法是基于结果的强化学习(Outcome-based RL),具体使用了 GRPO(Group Relative Policy Optimization)算法,以最终答案的正确性作为奖励信号,而非依赖人工标注的过程监督。实验中出现了一个有趣现象:训练到特定阶段后,模型会自发产生「Wait」「Let me reconsider」这类自我复盘、自我校验的语句——全程没有任何人工标注的示范样本,这完全是模型自主演化出的行为。
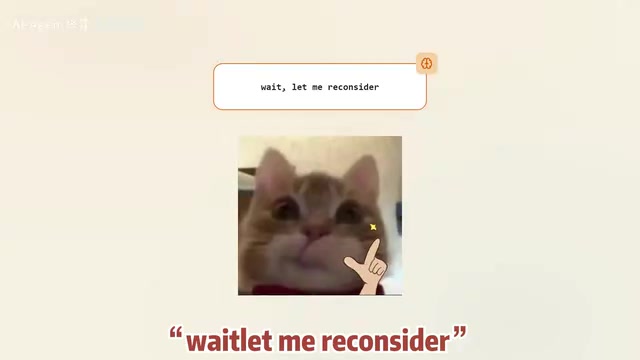
团队将该现象命名为 「Aha Moment」(顿悟时刻)。背后逻辑清晰:强化学习以答案正确率作为奖励信号,模型在海量试错中发现,增加反思和自查步骤能大幅提升准确率,因此主动保留了这套推理行为。「Aha Moment」出现的深层原因在于:模型在参数空间中早已编码了自我校验能力(源自预训练阶段),强化学习的奖励信号相当于一个「选择压力」,使这种潜在能力得到强化并稳定输出——这与进化生物学中的自然选择机制在数学形式上高度类似。
这个实验推翻了一个常见误区:思维链并非人为强加给模型的外部技巧,而是模型为提升任务正确率而自主演化出的最优推理策略。它同时证明,分步推理、自我校验的能力早已存储在模型参数之中——普通提问无法触发,思维链提示词是手动唤醒,强化学习则让模型学会自主判断场景、主动启用推理链路。
适用边界:为什么简单任务上 CoT 反而有害?
一个高频的延伸问题是:为什么思维链对简单任务提升微弱,甚至适得其反?
原因主要有两点:
第一,简单任务单步即可求解。 强行拆分成多步会新增大量 token,而每多生成一个 token 就多一分出错概率,反而累积了误差风险。研究者将此称为「幻觉级联」(Hallucination Cascade)——每一步的微小错误都可能在后续步骤中被放大,最终导致错误答案。实验数据也表明,参数量低于 100 亿的小模型在使用 CoT 时提升幅度有限,甚至出现性能下降,这是因为小模型缺乏足够的「推理基础能力」,强行拆分步骤只会累积更多错误。
第二,冗长的推导内容会占用宝贵的上下文窗口,挤压关键的输入信息,造成有效信息丢失。
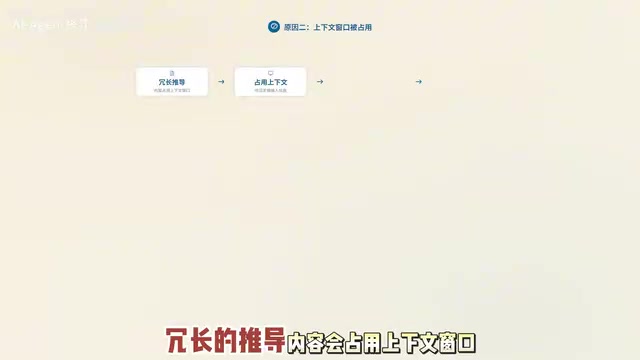
因此,思维链存在明确的适用边界:仅当任务复杂度超出模型单步推理上限时,使用 CoT 才能获得正向收益。工程实践中通常需要根据任务类型动态决策是否启用 CoT,对简单任务盲目套用,往往得不偿失。
面试满分回答:四层递进结构
如果面试中遇到这道题,建议按四层递进结构作答:
一、底层算力逻辑:大模型基于 Transformer 架构,单个 token 的前向传播算力固定,更多输出 token 对应更长、更深的计算链路,为复杂推理提供充足运算空间。
二、上下文记忆机制:分步推导将中间结果存入上下文,借助注意力机制复用历史计算,实现工作记忆的外部化,突破人类工作记忆 7±2 组块的瓶颈,降低单步推理难度。
三、预训练范式激活 + 实证佐证:分步思考的文本格式激活了模型预训练阶段习得的链式推导范式(涌现能力的一种体现);DeepSeek R1 的 GRPO 强化学习实验证明模型可自主生成反思语句,说明分步推理是模型的原生能力,而非人工外部技巧。
四、适用边界补充:简单任务使用 CoT 会触发幻觉级联、增加出错概率、挤占上下文;复杂推理任务才能产生正向增益,需结合任务难度灵活选用。
结语
思维链的价值,不在于「教」模型如何思考,而在于释放模型本已具备的推理潜能——它同时解决了算力空间、工作记忆和范式激活三重问题,并被 DeepSeek R1 的实验证明为模型自发演化的最优策略。真正理解这一点,才能在实际应用中准确判断何时该用、何时该省,把思维链用在刀刃上。
相关推荐

本地AI部署神器LocModel:一键玩转开源模型与AI生成
LocModel是一款本地AI部署工具,可自动适配硬件、一键下载开源模型,支持图片生成、视频生成、无审查大模型和Agent智能体,完全免费。本文基于实测视频介绍其安装与使用流程。

Antigravity CLI:终端免费调用Gemini与Claude顶级模型
Antigravity CLI(agy)宣称可在VS Code终端免费调用Gemini 3.1 Flash、Claude Sonnet等顶级模型,几秒完成安装。本文拆解其使用流程、终端内调用模型的价值,以及免费宣称背后需要核实的安全与可持续性问题。

聊天机器人与AI智能体:核心区别与选型指南
聊天机器人与AI智能体到底有什么区别?本文从工具、记忆、工作流三个维度拆解两者差异,用整理收件箱、安排会议等四个真实场景对比,并给出权限控制、不可逆操作确认等风险防范建议与选型判断标准。