Sonnet 5.5 与 GPT 6.1 Sol 实测:3D 任务成本相差 30 倍

同一Three.js任务,Sonnet 5.5成本是GPT 6.1 Sol的30倍,质量却相近。
一名开发者用相同的Three.js 3D键盘动画提示词对比了GPT 6.1 Sol与Anthropic Sonnet 5.5的表现。结果显示,两者产出质量相近,但成本天壤之别:Sol仅用4个agent、11分钟、$1.78完成任务;Sonnet 5.5则动用19个agent、耗时78分钟、产生逾2亿token读取量,API等效成本高达$57.34,约为Sol的30倍。Sonnet的高成本主要源于其激进的多agent拆解策略——每个agent反复读取上下文缓存,即便缓存命中率极高,庞大的绝对量仍推高了账单。测试者表示在质量相近的前提下会选择Sol并手动微调,这一案例揭示了在AI编程实践中,性价比往往比边际质量优势更具决策权重。
一位 Reddit 用户用同一道 Three.js 3D 建模题,对新发布的 GPT 6.1 Sol 和 Anthropic 的 Sonnet 5.5 进行了正面对比。结果颇具冲击力:两者产出质量相近,但 API 等效成本相差整整 30 倍。这个案例值得所有关注 AI 编程成本的开发者仔细看看。
测试是怎么做的
测试者给两个模型下达了完全相同的提示词——生成一段 Three.js 动画,呈现一个透明亚克力键盘「逐键自我组装」的效果,类似当下常见的键盘广告风格。两个模型都跑在同一套 ultracode 环境下,通过 atomic.chat 平台调用(GPT 使用 5x 订阅档、Claude 使用 20x 订阅档)。
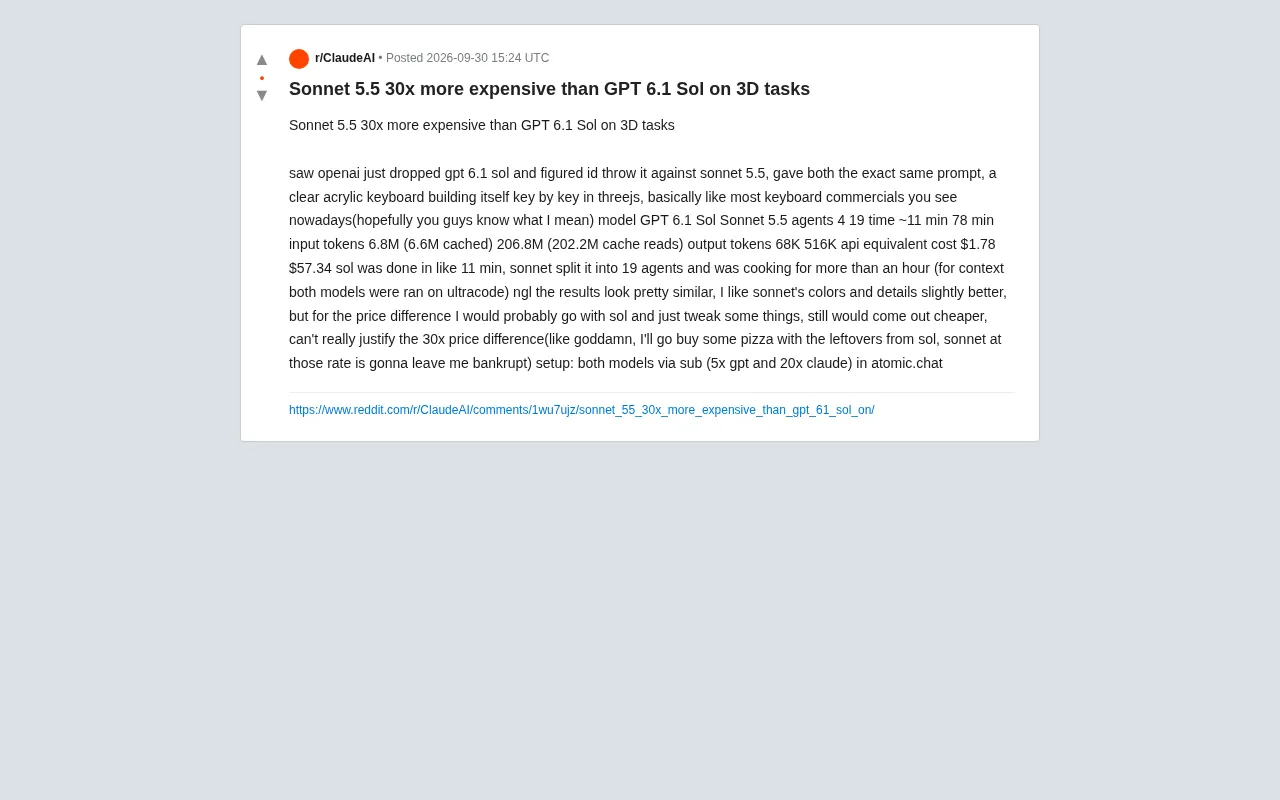
相同的任务、相同的运行环境,是这次对比相对公平的前提。差异主要来自两个模型各自的执行策略。
Three.js 是一个基于 WebGL 的开源 JavaScript 3D 渲染库,允许开发者在浏览器中创建复杂的三维场景、动画和交互效果,无需直接编写底层 WebGL 代码。它被广泛用于产品可视化、数据可视化和游戏原型开发。「逐键自我组装」这类动画涉及粒子轨迹计算、材质透明度控制(亚克力效果需要 PBR 材质参数调校)以及逐帧补间动画逻辑,对 AI 代码生成能力有较高要求——它不仅考验语法正确性,还考验空间几何理解和视觉审美判断。这类 3D 可视化任务因代码量大、依赖关系复杂,也是测试 AI 多轮推理和自我纠错能力的典型场景,与简单的文字生成任务相比,更能暴露不同模型在执行策略上的差异。
数据对比:效率与成本的巨大落差
从测试者给出的原始数据看,两个模型的表现差异非常明显:
| 指标 | GPT 6.1 Sol | Sonnet 5.5 |
|---|---|---|
| 调用 agent 数 | 4 | 19 |
| 耗时 | 约 11 分钟 | 78 分钟 |
| 输入 tokens | 680 万(660 万缓存) | 2.068 亿(2.022 亿缓存读取) |
| 输出 tokens | 6.8 万 | 51.6 万 |
| API 等效成本 | $1.78 | $57.34 |
GPT 6.1 Sol 只用了 4 个 agent、11 分钟就完成任务;Sonnet 5.5 则把任务拆成 19 个 agent,跑了一个多小时。输入 token 的差距尤为夸张——Sonnet 的 2 亿级 token 读取量是 Sol 的 30 倍以上,直接推高了最终成本。
为什么 Sonnet 消耗这么多 token
Sonnet 5.5 采用了更激进的多 agent 拆解策略,19 个 agent 反复读取上下文缓存,累积出惊人的 token 量。虽然大部分是缓存读取(成本较低),但绝对量级摆在那里,最终 API 等效成本仍高达 57 美元。相比之下,Sol 的「少 agent、快收敛」路线显得更克制。
多 agent 架构(Multi-Agent Architecture)是指将一个复杂任务分解给多个独立的 AI 代理(agent)协作完成,每个 agent 负责子任务并相互传递结果。这种架构的核心代价在于上下文膨胀:每个 agent 启动时通常需要读取任务背景、前序 agent 的输出以及共享记忆,随着 agent 数量增加,累积读取的 token 量会呈现近似线性甚至超线性增长。Sonnet 5.5 的 19 个 agent 中,大多数时间花在反复读取同一段上下文缓存上,这正是其 2 亿 token 读取量的主要来源。
缓存读取(Cache Read)的单价虽然显著低于新生成 token(通常低 5-10 倍),但无法改变「量大即贵」的基本逻辑。当缓存读取量达到数亿 token 级别时,即便折扣后的单价也会累积出高额账单。这也解释了为何 Sonnet 的缓存命中率高达 97% 以上,成本仍远超 Sol——命中率高不等于总成本低,关键变量是缓存读取的绝对体量。
产出质量:相近,但不等价
测试者的主观评价是:两者结果「看起来相当接近」。他个人更偏爱 Sonnet 的配色和细节处理,认为略胜一筹。但这种优势在 30 倍的成本差距面前显得微不足道。
用他的原话说:「以这个价差,我会选 Sol,然后自己微调一些细节,算下来还是更便宜。」他甚至调侃,用 Sol 省下的钱够买披萨,而 Sonnet 那个费率「会让我破产」。
这其实点出了一个现实的工程权衡:当两个模型的产出都能达到「可用、可微调」的基线时,成本效率往往比边际质量提升更重要。
对开发者的启示
这个单一案例不足以给两个模型下定论,但它揭示了几个值得思考的方向。
多 agent 不等于更好。 Sonnet 5.5 把任务拆成 19 个 agent 换来的质量提升非常有限,却带来了数十倍的 token 消耗。对预算敏感的场景,agent 数量的暴涨可能是成本黑洞。
缓存机制的作用有限。 即便 Sonnet 的绝大多数 token 来自缓存读取,庞大的绝对量仍让成本失控。缓存能降低单价,但挡不住量级膨胀。
性价比是真实的决策因子。 在质量趋同的前提下,「便宜且够用」往往比「稍好但昂贵」更有商业意义,尤其是需要批量生成 3D 或可视化内容的团队。
需要提醒的是,这只是一名用户在特定任务(Three.js 3D 动画)上的一次测试,样本极小,不同任务类型下的表现可能完全不同。想真正评估,建议结合自己的实际工作负载做多轮对比。
相关推荐

beacon.sh:为AI编程助手装上自我进化记忆
beacon.sh 是一款开源、可自我进化的 AI 编程代理记忆层,支持 Claude Code、Cursor、Codex 等 20 多个 harness,把代理会话转化为复利式知识层,解决跨工具记忆断层问题。

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。