SpringAI+RAG企业级实战:打破大模型三大瓶颈

拆解Spring AI Alibaba+RAG+Milvus如何解决大模型企业落地的四类短板。
文章基于B站教程《SpringAI+RAG传统应用AI化升级企业级实战》,梳理大模型在企业落地时暴露的知识截止、无跨轮记忆、幻觉和私有数据盲区四类结构性短板,指出RAG是补齐这些短板的工程解法。方案以Spring AI Alibaba + RAG + Milvus构成完整链路,覆盖模型接入、文档向量化、相似度检索、并发处理与容器化部署。教程能力目标包括Ollama本地部署千问3、千问Plus与Embedding集成、JDK 21虚拟线程及Docker部署,目标人群以Java开发者为主,无需转Python即可切入AI应用开发。文章同时提醒检索质量、文档切分和Embedding选型会显著影响落地效果,并纠正原文口播中“Muverse”应为Milvus。
大模型接口调用已不新鲜,但真正落地企业时,知识截止、金鱼记忆、幻觉和私有数据盲区这四道坎,让不少团队卡在Demo阶段。B站教程《SpringAI+RAG传统应用AI化升级企业级实战》给出的解法是:Spring AI Alibaba + RAG + Milvus(原文口播为Muverse,实为向量数据库Milvus)的技术组合。本文基于该教程内容,拆解这套方案要解决什么问题、适合谁学、能达成什么目标。
为什么单纯调用大模型不够用
大模型语言能力再强,落到企业场景也会暴露结构性短板。教程将问题归纳为三类:
- 知识截止:模型训练数据存在时间边界,原文举例说模型数据可能只更新到某个月份,此后发生的事它一概不知。
- 金鱼记忆:多轮对话中,用户已提供订单号,再次提问时模型仍要求重复提供——它没有跨轮次的持久记忆。
- 幻觉:模型对没有数据支撑的问题会胡编乱造,原文用“问某人性别却得到错误答案”来说明这类“胡说八道”。
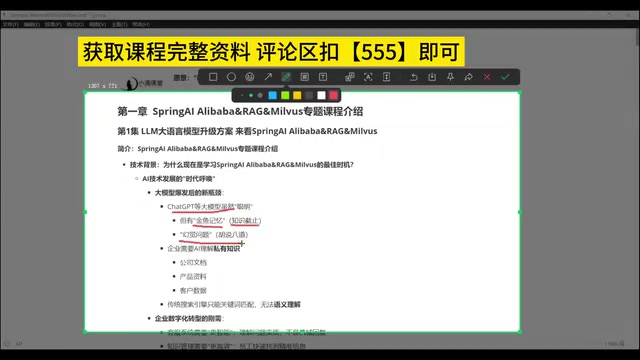
这三类问题指向同一个根源:模型是别人训练的通用模型,既不知道你的私有数据,也不天然具备企业业务所需的上下文。
私有知识与语义搜索的双重缺口
企业文档、产品信息、客户数据不会进入通用模型的训练集,直接提问必然得不到答案。传统搜索引擎同样受限——它靠关键词和字面匹配,搜“手机”会带出“手套”“手表”,却无法理解“智能产品”这类语义关联。教程由此引出RAG的核心价值:用检索增强生成,把私有知识喂给模型,同时借助大模型的语言理解能力补上语义搜索的短板。
RAG(检索增强生成) 是一种将外部知识库与大语言模型结合的技术范式。其核心流程分两步:检索阶段,系统将用户问题转化为向量,在向量数据库中搜索语义最相近的文档片段;生成阶段,把这些片段作为上下文拼入提示词,让模型基于真实资料作答。RAG 的价值在于无需微调模型即可注入私有知识,同时大幅降低幻觉——模型被约束在检索到的证据范围内回答。相比微调,RAG 的知识更新更及时、成本更低,适合企业文档频繁变动的场景。
向量化与 Embedding 模型:文本无法直接计算语义相似度,需通过 Embedding 模型将句子映射为高维浮点数向量,语义相近的文本在向量空间中距离更近。教程中使用的千问3 Embedding 模型即负责这一转换。文档入库前要经过提取、切分、向量化三步,切分粒度直接影响检索命中率——切得太碎丢失上下文,切得太大引入噪声。相似度搜索通常采用余弦相似度或内积,Milvus 等向量数据库通过近似最近邻算法(如 HNSW、IVF)在亿级向量中实现毫秒级检索。
企业真正的刚需在哪里
教程把企业需求拆成三个层次,对应AI化升级的三个落点。
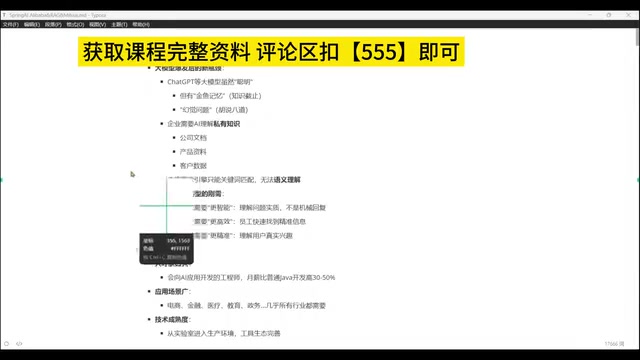
客服系统更智能。 用户表达过的问题应当被记住,回复要基于理解而非机械匹配。订单号只提供一次,后续追问不应重复索要——这正是记忆机制要解决的事。
知识管理更高效。 员工查资料不必再绞尽脑汁凑专业术语,用自然语言描述需求即可检索到目标信息。
内容推荐更精准。 当模型能理解“可爱的、甜的、酸的、苦的”这类语义描述,推荐系统就能捕捉用户真实偏好,而不是停留在字面匹配。
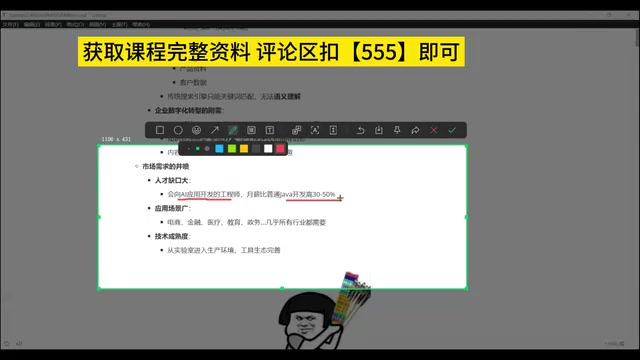
教程还提到市场层面的信号:会AI应用开发的工程师薪资比普通开发工程师高出30%到50%,且需求呈上升趋势;应用场景覆盖电商、金融、医疗、教育、政务等行业;Spring AI Alibaba已推出1.0版本,技术从实验室走向生产环境。
这套技术栈的学习路径与目标
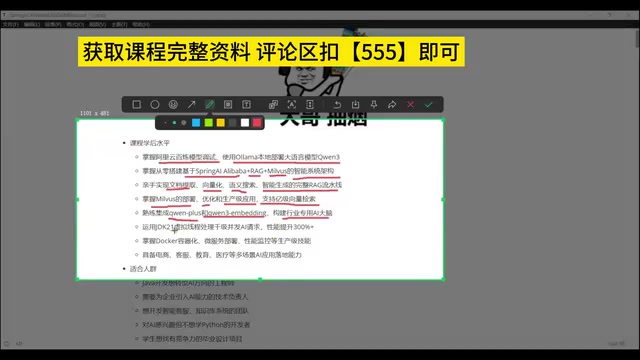
教程给出的能力清单相当具体,可以看作一条从模型接入到生产部署的完整链路:
- 模型层:掌握阿里云广告百炼平台的模型调试,以及用Ollama本地部署千问3模型。
- 架构层:从零构建Spring AI Alibaba + RAG + Milvus的智能系统,落地智能客服或知识库场景。
- 数据层:亲手实现文档提取、向量化与相似度搜索,跑通完整RAG流水线。
- 存储层:掌握Milvus向量数据库的部署、优化与生产级应用,支持亿级向量检索。
- 模型集成:接入千问Plus大模型与千问3 Embedding向量模型,构建专业AI大脑。
- 工程化:基于JDK 21的虚拟线程处理并发(原文称性能提升将近300%),用Docker完成容器化部署与性能监控。
- 项目实战:以教育场景为主,覆盖电商客服、医疗等不同行业场景,训练AI应用落地能力。
说个细节JDK 21虚拟线程的引入——RAG系统涉及大量并发检索与模型调用,传统线程模型在高并发下开销明显,虚拟线程让并发处理更轻量,这也是教程选择JDK 21而非旧版本的原因。
JDK 21 虚拟线程是 Java 平台引入的轻量级线程实现,由 JVM 调度而非操作系统调度,创建成本极低,单机可支撑数百万个虚拟线程。传统平台线程与操作系统线程一一对应,每个线程占用约 1MB 栈空间,高并发下线程池耗尽会成为瓶颈。RAG 系统中大量时间花在等待向量检索和模型 API 响应上,属于 I/O 密集型负载,虚拟线程在阻塞时自动让出载体线程,因此能显著提升吞吐量。原文所称“性能提升将近300%”应理解为特定压测场景下的吞吐量对比,实际收益取决于 I/O 等待占比。
适合哪些人学
教程的目标人群划得很清楚,本质上覆盖三类角色:
- 转型者:Java开发者想转AI应用开发,不想额外学Python。教程明确把“对AI感兴趣但不想学Python的开发者”列为适配人群,Spring技术栈背景可直接复用。
- 企业技术决策者:需要为团队引入AI能力的技术负责人,或要开发智能客服、知识库的团队。
- 项目需求者:需要高竞争力毕业项目的学生、想快速体验AI产品的创业者、传统行业IT部门做技术升级的团队。
几点判断
从教程内容看,这套方案的价值不在单点技术,而在把模型接入、私有知识检索、向量存储、并发处理、容器部署串成一条可交付的工程链路。对Java背景的开发者而言,Spring AI Alibaba降低了进入AI应用开发的门槛——不必切换到Python生态,用熟悉的Spring体系就能搭建RAG系统。
需要留意的是,教程对RAG效果的描述集中在能力层面,实际落地中检索质量、文档切分策略、Embedding模型选型都会显著影响最终效果,这些细节需要在项目实战中逐步打磨。另外原文口播中的“Muverse”应为Milvus,学习时以官方文档为准。
相关推荐

9家AI订阅套餐积分换算:每亿Token真实成本揭秘
B站UP主实测火山、阿里、腾讯、百度、智谱、小米、MiniMax等9家AI订阅套餐,统一换算每亿Token真实成本,拆解固定额度与三档系数两类计费逻辑,揭示缓存、时段折扣和窗口限额对实际额度的影响。

Vibe Coding入门:用意图表达代替手写代码
Vibe Coding 是什么?B站137集实战课程给出定义:核心不是写代码而是表达意图。本文解析 Vibe Coding 的生产力逻辑、适合人群与入门预期,帮助零基础者判断是否值得投入学习。
LangChain入门指南:从LangGraph到Deep Agents的智能体开发路线
理清LangChain、LangGraph和Deep Agents的封装关系,掌握智能体开发框架的学习路线与选型逻辑,适合大模型开发入门者参考。