StochBench:首个随机过程Lean形式化证明基准详解
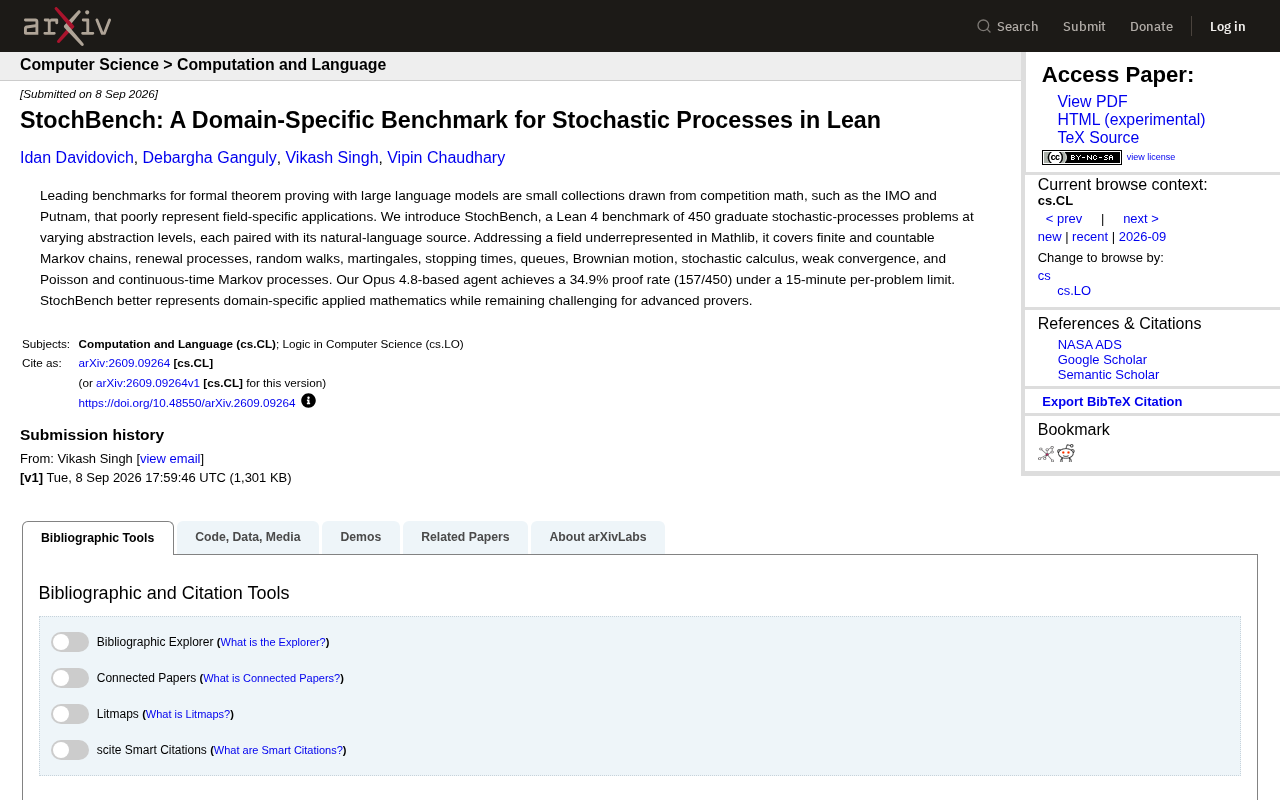
StochBench:首个随机过程领域的Lean 4形式化证明基准,AI成功率34.9%。
arXiv最新研究推出StochBench,一个包含450道研究生级别随机过程问题的Lean 4形式化证明基准测试集,填补了形式化证明在应用数学方向的空白。该基准涵盖马尔可夫过程、鞅理论、布朗运动、排队论等核心主题。基于Opus 4.8的AI智能体在15分钟时限下仅达34.9%成功率,表明应用数学领域对AI证明能力构成远超竞赛数学的挑战,也标志着形式化数学基准进入垂直细分新阶段。
形式化数学的新战场
当前主流的形式化定理证明基准测试,如IMO(国际数学奥林匹克)和Putnam数学竞赛题集,虽然具有一定挑战性,但它们主要聚焦于竞赛数学,难以代表特定学科领域的实际应用需求。形式化定理证明是指使用严格的计算机程序语言来表述和验证数学定理的过程——与传统纸笔证明不同,形式化证明要求每一个推理步骤都被计算机验证器检查,从而消除人为错误的可能性。这一方法论的历史可以追溯到20世纪60年代,但真正获得广泛关注是在2005年Georges Gonthier使用Coq证明了四色定理,以及2017年Thomas Hales团队完成了开普勒猜想的形式化验证(Flyspeck项目)。这些里程碑事件证明了形式化方法能够处理人类数学家难以完全手动验证的复杂证明。来自arXiv的最新研究论文介绍了StochBench——一个专门针对随机过程领域的Lean 4基准测试集,填补了形式化证明在应用数学方向上的重要空白。
Lean 4是由微软研究院开发的新一代交互式定理证明器和函数式编程语言,它既可以作为通用编程语言使用,也可以作为构建和验证数学证明的工具。相较于前代版本,Lean 4在性能和可用性上有显著提升,采用了更现代的编译器架构,支持元编程和自定义策略(tactic),使得用户能够灵活地扩展证明自动化能力。目前主流的定理证明器除了Lean之外,还包括Coq、Isabelle/HOL和Agda等,它们各自基于不同的类型论基础。Lean 4选择了基于归纳构造演算(Calculus of Inductive Constructions)的依赖类型论,这使得它能够在统一的框架下同时处理命题(证明)和数据(计算),这种"证明即程序"的对应关系(Curry-Howard同构)是现代形式化数学的理论基石。
这个基准包含450道研究生级别的随机过程问题,每道题目都配有其自然语言源文本,涵盖了从基础到高级的多个抽象层次。随机过程领域在Mathlib(Lean的核心数学库)中长期处于代表性不足的状态,而StochBench的推出正是为了弥补这一缺口。Mathlib是目前规模最大的单一形式化数学库之一,由全球数百名贡献者协作维护,截至目前包含超过百万行形式化代码,涵盖代数、分析、拓扑、数论等广泛的数学分支。然而,Mathlib的覆盖并不均匀——纯数学的代数和分析分支相对完善,而应用数学方向如随机过程、偏微分方程、数值分析等领域的形式化程度仍然较低。
随机过程在Mathlib中形式化程度低的原因是多方面的。首先,随机过程的严格定义需要大量测度论基础设施——可测空间、σ-有限测度、条件期望的正则版本等概念本身就极其复杂。其次,许多经典教科书中的证明依赖于"选择公理"的各种形式和不可构造性论证,这在构造性类型论环境中需要额外的处理。再者,随机过程涉及大量的"几乎处处"(almost everywhere)推理,即忽略零测度集上的行为,这种推理模式在形式化环境中需要反复处理商空间和等价类,技术上极为繁琐。此外,概率论中频繁出现的极限交换操作——如积分与极限的交换(Lebesgue控制收敛定理)、期望与条件期望的交换——每一次使用都需要验证严格的技术条件(如一致可积性或控制函数的存在),这些在纸笔证明中常被简要带过的步骤,在形式化环境中却需要逐一显式验证。这种不均衡性直接影响了AI系统在这些领域进行自动证明的能力,因为缺乏基础引理和定义意味着AI必须从更底层开始构建推理链。
StochBench的覆盖范围与技术深度
StochBench的题目覆盖范围体现了随机过程理论的完整知识图谱。随机过程是概率论中研究随时间演化的随机现象的核心理论框架,其数学基础深植于测度论——由勒贝格和科尔莫格洛夫等人建立的现代概率公理化体系。在测度论框架下,概率空间被定义为一个三元组(Ω, F, P),其中Ω是样本空间,F是σ-代数(事件的集合),P是概率测度。条件期望不再是简单的条件概率除法,而是通过Radon-Nikodym定理定义的几乎处处唯一的可测函数。这种高度抽象的数学基础使得随机过程的形式化尤为困难,因为每一个看似直觉性的概念背后都需要严格的测度论支撑。
StochBench具体包括以下核心主题:
-
马尔可夫过程:有限和可数马尔可夫链、连续时间马尔可夫过程。马尔可夫过程的核心特征是"无记忆性"——未来状态的概率分布只依赖于当前状态,而与过去的历史无关。在形式化环境中,定义马尔可夫性质需要精确表达条件概率对σ-代数的依赖关系,涉及到滤波(filtration)的概念,即一族递增的σ-代数,用于建模信息的逐步揭示。有限状态马尔可夫链可以通过转移矩阵紧凑表示,但可数状态和连续时间的推广则需要处理无穷维矩阵的收敛性和半群理论——具体而言,连续时间马尔可夫过程的转移概率构成一个单参数半群,其生成元(也称Q-矩阵或速率矩阵)完整刻画了过程的动态特性,这一关系的形式化需要泛函分析中算子半群理论的支撑,而这在Lean中需要大量的基础设施建设。
-
随机游走理论:经典随机游走及其变体。随机游走是最基本的离散时间随机过程模型,由Karl Pearson在1905年命名。简单对称随机游走——每一步等概率向左或向右移动一个单位——看似简单,却蕴含着丰富的数学结构。Pólya在1921年证明的经典结果表明,一维和二维的简单随机游走几乎必然回到原点(常返性),而三维及更高维度的随机游走则以正概率永远离开原点(非常返性)。这个优美的维度依赖性在形式化证明中需要精细的组合计数和级数收敛性分析。随机游走还与调和函数、电网络理论、图上的势论有着深刻联系——这种跨领域的数学关联使得其形式化不仅限于概率论范畴。
-
鞅理论:鞅过程、停时理论。鞅(Martingale)是概率论中最优雅也最深刻的概念之一,源自赌博策略的研究,后来发展成为现代随机分析的核心工具。直觉上,鞅描述的是一个"公平赌博"——在已知过去信息的条件下,未来的期望值等于当前值。停时(Stopping Time)则是一种特殊的随机变量,表示某个事件首次发生的时刻,其关键性质是"是否停止"的判断只能基于当前和过去的信息。鞅的可选停时定理(Optional Stopping Theorem)将这两个概念联系起来,在金融衍生品定价中具有基础性地位——Black-Scholes期权定价公式的数学基础正是鞅测度理论。在鞅收敛理论中,Doob分解定理将一般的适应过程分解为鞅和可预测过程之和,而Doob鞅收敛定理则保证了上鞅在特定条件下几乎必然收敛,这些深层结构性定理的形式化需要精细的σ-代数操作和极限论证。
-
更新过程:更新理论及其应用。更新过程研究的是重复发生的随机事件之间的时间间隔,其核心结果——更新定理——描述了事件发生频率的长期行为。基本更新定理(Elementary Renewal Theorem)指出,更新次数除以时间几乎必然收敛到事件间隔期望的倒数,而关键更新定理(Key Renewal Theorem)则给出了更精细的渐近估计。更新理论中一个有趣的悖论是"等待时间悖论"(也称检验悖论):如果你在随机时刻到达公交站,你等待的平均时间通常大于平均发车间隔的一半——这是因为你更有可能落入较长的间隔中。更新理论在可靠性工程(设备替换策略)、保险精算(索赔到达模型)和库存管理中有广泛应用。
-
排队论:各类排队系统建模。排队论是运筹学中研究等待现象的数学理论,由丹麦工程师A.K. Erlang在1909年研究电话交换系统时奠基。经典排队模型使用Kendall记号A/S/c来描述,其中A表示到达过程、S表示服务时间分布、c表示服务台数量。从M/M/1队列(泊松到达、指数服务、单服务台)到G/G/k队列的推广涉及越来越复杂的随机过程工具。排队论中的核心量度包括系统利用率ρ、平均队长L和平均等待时间W,它们通过Little定律(L = λW)联系在一起——这个看似简单的恒等式实际上具有极为广泛的适用条件,其严格证明需要遍历论的工具。排队论的形式化特别有价值,因为它是少数能够直接指导工程实践的概率论分支——云计算资源调度、网络拥塞控制、医疗系统容量规划等都依赖排队模型的定量结果。
-
布朗运动与随机微积分:布朗运动、伊藤积分等高级主题。布朗运动(也称维纳过程)是连续时间随机过程的基石,具有独立增量、正态分布增量和连续样本路径三大特征。尽管其路径连续,但几乎处处不可微——这一反直觉的性质使得经典微积分工具无法直接应用。布朗运动的路径具有无限变差(即在任何有限时间区间上的总振幅为无穷大),这意味着经典的Riemann-Stieltjes积分理论不适用。伊藤积分正是为了解决这一问题而发展出来的随机积分理论,由日本数学家伊藤清于1944年创立。与经典Riemann-Stieltjes积分不同,伊藤积分需要特别注意积分近似中取值点的选择(左端点而非中点),否则会导致不同的积分结果(对比Stratonovich积分)。这种选择的差异不仅是技术性的——伊藤积分产生的过程是鞅,而Stratonovich积分保持经典的链式法则,两者在物理和金融中各有适用场景。伊藤引理——随机微积分的链式法则——是金融数学、物理学和工程学中无处不在的核心工具,其与经典链式法则的区别(多出一个二阶修正项)直接来源于布朗运动的二次变差性质。
-
收敛理论:弱收敛、泊松过程。弱收敛(也称依分布收敛)是概率论中最精细的收敛概念之一,研究随机变量序列的分布函数的极限行为。中心极限定理——统计学的基石——本质上就是一个弱收敛定理。在概率论中,收敛的概念形成了一个层次结构:几乎必然收敛 → 依概率收敛 → 依分布收敛,每一层的关系都需要严格的测度论论证。Prokhorov定理建立了弱收敛与胎紧性(tightness)之间的等价关系,为证明弱收敛提供了实用的判别准则。泊松过程则是最基本的计数过程模型,描述稀有事件在时间上的随机发生模式,其特征性质包括独立增量和增量的泊松分布。泊松过程与指数分布之间的深刻联系使其成为连接离散和连续随机模型的桥梁。
这些主题不仅是概率论和随机过程课程的核心内容,更是金融工程、运筹学、通信理论等应用领域的数学基础。通过将这些内容形式化为Lean 4代码,StochBench为AI系统在专业数学领域的能力评估提供了更贴近实际的标准。
AI证明能力的试金石:34.9%的成功率意味着什么
研究团队使用基于Opus 4.8的智能体对StochBench进行了系统测试,在每道题15分钟的时间限制下,成功证明率为34.9%(157/450)。该证明智能体采用了大语言模型与形式化验证器交互的架构模式:LLM负责生成证明策略(tactic)序列,而Lean编译器则实时验证每一步推理是否正确。当某个策略失败时,智能体会根据错误信息调整策略,形成一个"生成-验证-修正"的闭环。这种方法的优势在于结合了LLM的模式识别和直觉猜测能力与形式验证器的绝对严格性。15分钟的时间限制意味着智能体需要在有限的搜索预算内找到正确的证明路径,这对策略选择的效率提出了很高要求。
AI辅助定理证明的技术路线经历了几个重要阶段。早期方法如ATP(自动定理证明器)依赖于穷举搜索和启发式规则,如E-prover和Vampire等系统,它们在一阶逻辑领域表现出色,但难以处理高阶逻辑和复杂类型论中的证明。2020年前后,DeepMind的AlphaProof和Meta的HyperTree Proof Search开始将深度学习引入证明搜索,使用神经网络来指导策略选择,大幅提升了搜索效率。当前的主流范式是将大语言模型作为"策略生成器",结合树搜索算法(如蒙特卡洛树搜索或最佳优先搜索)来探索证明空间。一些前沿工作还引入了"专家迭代"(Expert Iteration)机制,即用已成功的证明来微调模型,形成自我改进循环。最近的研究还探索了"全证明生成"(whole-proof generation)范式,即让LLM一次性生成完整的证明脚本而非逐步交互,这在简单问题上效率更高,但在复杂问题上缺乏中间反馈的纠错能力。
这一数据传递了两层关键信息。
一方面,这个成功率表明StochBench确实具有相当的挑战性。即便是先进的大语言模型配合专门的证明策略,也只能解决约三分之一的问题。这与IMO等竞赛基准中某些问题已接近完全解决的现状形成鲜明对比。值得注意的是,未被解决的65.1%的问题并非随机分布——它们可能集中在Mathlib基础设施薄弱的子领域(如伊藤积分相关问题,因为随机积分的形式化需要同时处理可预测过程的可测性、L²空间的完备性和鞅性质),或者涉及需要深层创造性洞察的非常规证明路径。还有一类困难来自所谓的"gap lemma"问题——某些在数学教科书中被视为"显然"的中间步骤,在形式化环境中却缺乏对应的引理,需要从头证明。
另一方面,34.9%的成功率也展示了当前AI在形式化数学证明方面取得的实质进展。随机过程涉及大量抽象概念、极限理论和测度论基础,这一表现说明AI系统已经具备处理专业领域数学问题的初步能力,而不仅限于初等数学或竞赛技巧。这一结果也为评估不同AI系统的数学推理能力提供了一个有区分度的标尺——34.9%的成功率意味着基准既不会因为过于简单而失去区分度,也不会因为过于困难而无法产生有意义的比较数据。
对AI数学推理研究的启示
传统的形式化定理证明基准往往偏重于离散数学和初等代数,而StochBench引入的连续性、随机性和测度论概念,为AI系统带来了全新的挑战维度。竞赛数学如IMO和Putnam的题目通常具有"自包含"的特点——题目所需的知识范围有限,关键在于巧妙的组合和推理技巧。而应用数学领域的定理证明则截然不同:它们往往依赖于庞大的理论体系,一个定理的证明可能需要调用数十个前置引理,横跨多个数学分支。例如,证明随机过程中的大偏差原理可能同时涉及拓扑学(紧性论证)、泛函分析(对偶空间和Fenchel-Legendre变换)和测度论(弱收敛和指数胎紧性),这种跨领域的知识整合能力是目前AI系统面临的核心瓶颈之一。
这种结构性差异对证明搜索算法提出了根本不同的要求。竞赛题的证明通常较短(几十步到几百步策略),具有明确的目标和有限的搜索空间,且往往存在"关键洞察"——一旦找到核心思路,证明就能顺利推进。而应用数学定理的证明通常是"深而宽"的:证明链条很长,每一步可能需要调用不同子领域的引理,且中间步骤的目标状态难以从最终目标直接推断。这种结构性差异意味着在竞赛数学上有效的证明搜索策略(如beam search或单步策略预测)在应用数学中可能效率极低,需要发展新的分层规划和子目标分解技术。具体而言,有效的应用数学证明智能体可能需要具备"分层抽象"能力——先在高层制定证明大纲(例如"先建立一致可积性,然后应用鞅收敛定理,最后取极限"),再逐步细化每个子目标为具体的Lean策略序列。这种自上而下的规划与自下而上的策略搜索相结合的混合方法,是当前研究的前沿方向之一。
例如,证明布朗运动的性质需要理解连续函数空间的拓扑结构(特别是C[0,1]上的一致收敛拓扑和Wiener测度的构造);证明鞅收敛定理需要操作条件期望和几乎必然收敛等高级概率概念,其经典证明依赖于上穿不等式(upcrossing inequality)这一精巧的组合论证。这类问题所需的推理深度远超常见的竞赛数学题目。
这种领域特定的基准测试对于推动AI在科学研究和工程应用中发挥实际价值至关重要。与其在竞赛数学上单纯追求高分,不如在实际学科领域建立可靠的形式化能力——这才是AI辅助数学研究的核心方向。从更宏观的视角看,形式化数学可能成为连接AI与科学发现的关键桥梁:如果AI能够可靠地形式化和验证专业数学定理,那么它就有可能参与到真正的数学研究过程中——不仅仅是验证已知结果,而是通过形式化探索来发现新的数学结构和定理。
未来展望:形式化数学基准的垂直细分趋势
StochBench的发布标志着形式化数学基准测试进入了垂直细分的新阶段。随着更多领域特定基准的出现,可以预见以下发展趋势:
-
更精准的能力评估:针对不同数学分支设计专门测试,而非用通用基准一概而论。未来可能出现类似的基准集覆盖偏微分方程、代数几何、范畴论等目前形式化程度较低但学术重要性极高的领域。每个基准不仅测试AI的证明能力,还间接推动相应领域在Mathlib中的基础设施建设,形成"基准驱动形式化"的良性循环——当研究者为创建基准而必须形式化基础定义和引理时,这些工作本身就扩展了Mathlib的覆盖范围,进而使未来的AI系统能够调用更丰富的工具库。
-
领域知识的深度整合:促使AI模型学习特定领域的证明模式和直觉。这可能催生新的模型架构或训练策略,例如在预训练阶段引入特定领域的教科书和论文,或者开发能够动态检索和调用Mathlib引理的检索增强生成(RAG)系统。RAG在定理证明中的应用尤为自然——面对一个新的证明目标,系统可以通过语义检索找到Mathlib中相关的已有引理和定义,将它们作为上下文提供给LLM,从而大幅减少"幻觉"(生成不存在的引理名)和搜索空间的浪费。更进一步,可以构建"证明模式库"——将成功证明中的常见策略组合抽象为模板,使AI在证明过程中能够更有效地利用已有的形式化知识和领域惯用法。
-
实用化的形式化工具:推动Mathlib等形式化数学库在应用数学领域的持续扩展。随着AI证明能力的提升,"人机协作形式化"模式有望成为主流——数学家提供高层证明思路和关键洞察,AI负责填充技术细节和处理繁琐的引理匹配,从而大幅加速形式化进程。这种协作模式已经在一些项目中初现端倪:例如,Terence Tao在形式化PFR猜想的证明时就利用了社区协作和AI辅助工具。未来,这种模式可能进一步演化为"持续形式化"(continuous formalization)——数学家在撰写论文的同时实时生成形式化版本,AI实时检测潜在的逻辑漏洞并提供修复建议,使形式化验证成为数学研究工作流的自然组成部分。
对于概率论、统计学和相关应用领域的研究者而言,StochBench不仅是一个评估工具,更可能发展为教学和研究中验证证明正确性的辅助平台。当AI能够可靠地处理这些专业问题时,数学家将获得一个高效的形式化验证伙伴。
相关推荐
开源AI的真相:你拿到的只是蛋糕,不是配方
海外博主深度揭秘开源AI真相:你下载的只是权重(蛋糕),而非训练数据与代码(配方)。文章拆解开放权重与真正开源的差异,剖析Meta、阿里、DeepSeek的商业策略,以及中美欧三国政府如何用营收门槛与算力上限重画开放边界。
DSH白嫖DeepSeek V4.1 Flash:积分批量领取与国际版WorkBuddy实测
DSH项目最新升级实测:WorkBuddy端可批量领取100积分,限流额度提升、重置时间缩短,国际版WorkBuddy现已支持免费调用混元4与DeepSeek V4.1 Flash,附使用建议与风险提示。
DSH-SUBAGENT-UI插件:DeepSeek Harness子代理管理神器
DSH-SUBAGENT-UI 是 DeepSeek Harness Web 客户端插件,提供子代理总览、搜索、本地分类与完成快照功能,数据存本地不侵入原会话,一条命令即可安装,助力多子代理工作流高效管理。