提示词还是概率?大模型语义焦点敏感性的评估之争

研究比较token概率与提示法评估语义焦点敏感性,发现两者随模型规模呈现系统性分歧。
该研究比较了评估语言模型语言能力的两种路径:token概率法与提示法,测试场景为语义焦点敏感性——即仅靠粗体、斜体等焦点标记区分意义的句子对。结果显示,token概率法在所有规模模型上均稳定高于随机水平,但受模型不主动生成out-of-the-blue焦点标记的偏好拖累;提示法则与模型规模高度相关,在小模型上不如概率法,在部分大模型上大幅反超。研究者通过将焦点标记替换为随机标记进行验证:概率法性能下降幅度显著大于提示法,支持了“生成偏好干扰”假说。作者据此指出,评估方法的选择会系统性影响对模型语言能力的判断,方法论的自觉比单一结论更重要。
两种评估路径的分野
评估语言模型的语言能力,学界和工业界长期存在两条路径:一条是观察模型对标准文本的token概率分布,另一条是直接提示模型(prompting)做元语言判断,比如问它"哪句话更自然?"。据rss来源的研究《Prompts and probabilities in the linguistic assessment of language models: Evidence from semantic focus-sensitivity》,这两条路径在语义焦点敏感性(semantic focus-sensitivity)这一新领域给出了耐人寻味的分歧结果。
所谓语义焦点敏感性,指的是"Lucy only SWAM yesterday"与"Lucy only swam YESTERDAY"这类仅靠焦点标记(重音、粗体、斜体)区分意义的对比。研究用粗体和斜体等文本焦点标记测试了不同规模的模型,结果呈现出清晰的图景:token概率在所有模型上都稳定高于随机水平,而提示法的表现则与模型规模高度相关。
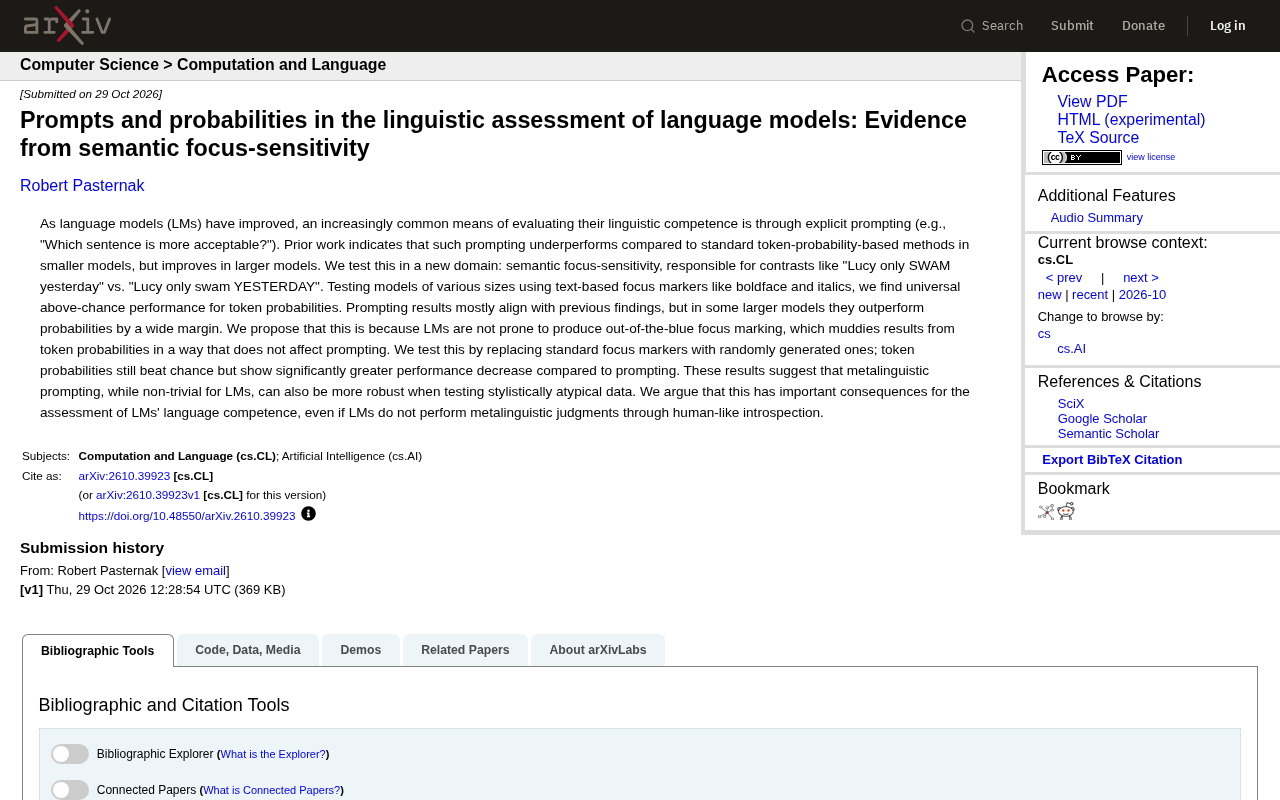
token概率评估法通常指:给定一个(或一对)句子,直接读取模型对每个token的对数概率,再据此计算句子概率或困惑度,并比较不同候选句的概率高低。它不需要模型“回答问题”,只利用模型作为自回归语言模型的原生输出分布,因此实现简单、结果连续、方差较小。**提示法(prompting)**则是把任务包装成自然语言指令,让模型生成“A更自然”“B更自然”之类的判断,再解析其输出。前者测量的是模型“会怎么说”,后者测量的是模型“会怎么判”,二者探测的认知层面并不相同,这正是后文分歧的根源。
概率法稳但"太老实"
研究中最值得玩味的一点,是token概率方法的"下限高、上限受限"。它在各种规模的模型上都高于随机猜测,说明模型确实捕捉到了焦点标记带来的语义差异。但问题在于,语言模型本身并不倾向于在自然输出中主动生成"out-of-the-blue"式的焦点标记——也就是说,模型在常规文本中很少自发使用粗体或斜体来标记焦点,这让基于概率的评估在遇到焦点敏感数据时会被"稀释"。
研究者提出了一个巧妙的验证:把标准的焦点标记替换成随机生成的标记。结果token概率依然高于随机水平,但性能下降幅度明显大于提示法。这直接支持了他们的解释——概率法的表现受制于模型对焦点标记的自然生成倾向,而非模型本身不理解焦点语义。
提示法在大模型上反超
提示法的结果与既有研究基本一致:小模型上不如概率法,但在部分大模型上,提示法的表现大幅反超概率法。这与之前的发现——提示法在更大模型上效果提升——形成了呼应。
这背后的含义值得细想。元语言提示(metalinguistic prompting)对语言模型来说并非易事,它要求模型跳出"生成文本"的模式,转而对文本做出判断。但当测试数据在风格上不典型(比如依赖粗体、斜体这类模型平时不怎么生成的标记)时,提示法反而展现出更强的鲁棒性。
**元语言判断(metalinguistic judgment)**指把语言本身当作对象来谈论或评判的能力,例如判断“哪句更通顺”“这两个句子意思是否相同”。它与使用语言(把语言用于交流)相对。对语言模型而言,元语言提示要求它从“续写文本”切换到“评估文本”,这一模式转换并不在其预训练目标的直接覆盖范围内,因此小模型往往表现不佳。但随着规模增大,模型逐渐具备零样本执行此类任务的能力,这也解释了为何提示法的效果与模型规模高度相关,而概率法不依赖这种模式切换。
对语言能力评估的启示
作者的核心论点是:这一发现对评估语言模型的语言能力有重要影响,即便模型并不是通过类人的内省来完成元语言判断。换句话说,提示法奏效不代表模型"懂"语言学意义上的焦点,但它确实是一种在某些数据条件下更稳健的探测工具。
这给评估实践提了个醒:单一方法可能系统性地低估或高估模型能力。概率法在风格典型的数据上可靠,却会被模型的生成偏好拖累;提示法在大模型上更灵活,却对模型规模敏感。两种方法的分歧本身,就是理解模型语言能力边界的一手信息。
对关注AI评估的研究者和工程师而言,这项工作的价值不在于宣布哪种方法"更好",而在于揭示评估方法的选择会如何塑造我们对模型能力的认知。在语义焦点这类细微的语言现象上,方法论的自觉比结论本身更重要。
背景补充
out-of-the-blue是语义学/语用学中的术语,指脱离任何预设语境、突然抛出的句子。与之相对的是“有语境支撑”的句子——例如在上下文中已经提到Lucy,再说“Lucy only SWAM yesterday”就很自然。焦点标记(尤其对比焦点)通常需要语境触发,因此在孤立句子中强行加粗或斜体,本身就带有“不自然”的色彩。这解释了为何模型在自然文本中很少自发产生这类标记:训练语料中粗体、斜体多用于标题、强调或排版,而非语言学意义上的焦点标注,模型的生成分布因此被系统性偏移,概率评估也随之被“稀释”。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。
PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。