Token缓存如何让你的DeepSeek账单省下98%

DeepSeek靠硬盘缓存复用稳定前缀,把重复阅读的输入成本降到五十分之一。
文章借用一位B站UP主的拆解,解释了大模型API账单差异巨大的原因:模型没有持久记忆,每轮请求都要把全部历史对话重新作为输入发送,输入token随对话增长而膨胀,而输出单价又是输入的四倍。DeepSeek的做法是把读过的内容存入硬盘缓存,当新请求开头与历史完全一致时直接复用,命中价格仅为未命中的五十分之一,存缓存免费、几秒生效且无需改代码。真实账单显示,输入约九万七千token的调用中大部分命中缓存,输入成本降低二十六倍。但缓存只认一字不差的开头,且是尽力而为,高峰时段价格还会翻倍,因此省钱的关键是保持前缀稳定。
每次调用大模型API,你都在为“重复阅读”付费。一位B站UP主用不到两分钟的视频拆解了DeepSeek的token缓存机制,揭示了账单差异惊人的秘密:同样读近十万token,有人花不到半分钱,有人却贵出几十倍。
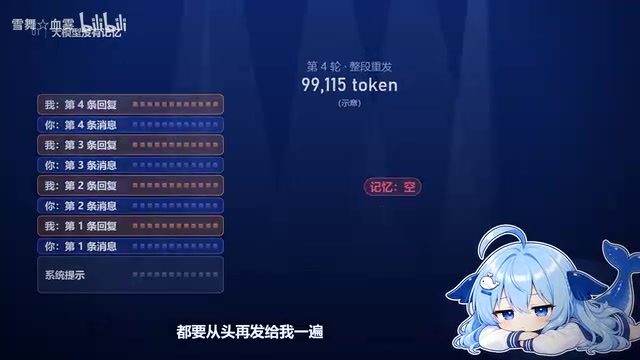
大模型没有记忆,每次都在“从头读”
大模型本质上没有持久记忆。你每发一条新消息,系统需要把之前的每一轮对话重新打包,作为输入发给模型。这意味着对话越长,每次请求携带的输入token就越多,成本随之膨胀。
输入和输出的计价逻辑完全不同。输入是整段同时读取,速度快、单价低;输出只能一个token一个token地生成,速度慢,单价更高——原文指出输出单价是输入的四倍。所以长对话的成本大头往往不在你写的那句话,而在反复回传的历史上下文。
Token与计费单位
Token是模型处理文本的基本单位,并非严格的“字”或“词”。常见做法是把文本切成子词片段:英文一个常见词可能占1个token,生僻词会被拆成多个;中文通常一个字约对应1~2个token,具体取决于分词器和文本内容。API账单上的输入、输出价格,都是按token数量计费,而非按请求次数。
上下文窗口
模型单次能读入的token总数有上限,称为上下文窗口。多轮对话时,系统会把历史消息、系统提示词和新问题拼成一个整体输入,一旦接近上限,就需要截断或摘要历史。这也是“每次重新打包全部历史”会持续推高成本的根源:对话越长,打包进去的token越多。
硬盘缓存:读过的内容不再全价重算
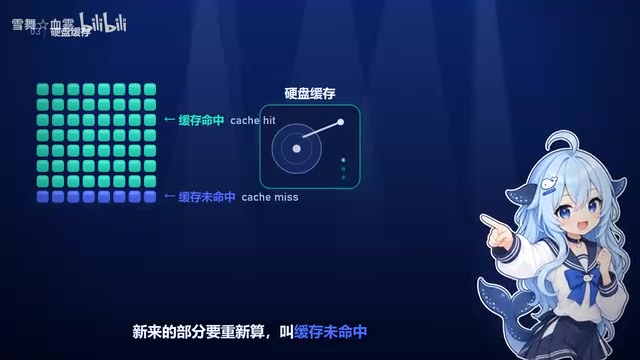
DeepSeek广告的解法是把读过的内容存进硬盘缓存。当新一轮请求的开头与历史内容完全一致时,这部分直接从缓存读取,称为“缓存命中”;只有新增部分需要重新计算,称为“缓存未命中”。
价格差距是数量级的:缓存命中的价格只有未命中的五十分之一,而且存缓存不额外收费,几秒内即可生效,开发者无需修改任何代码。
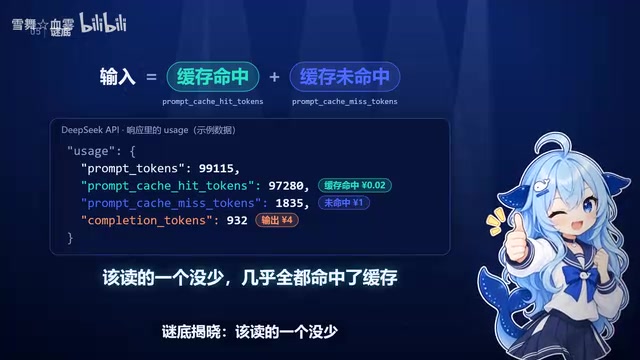
UP主用一笔真实账单演示:一次调用输入约九万七千多个token,其中绝大部分是早已存好的老对话,真正未命中的只有最新的一千八百多个。光看输入部分,不用缓存要一毛钱,用了缓存不到四厘,便宜了二十六倍。
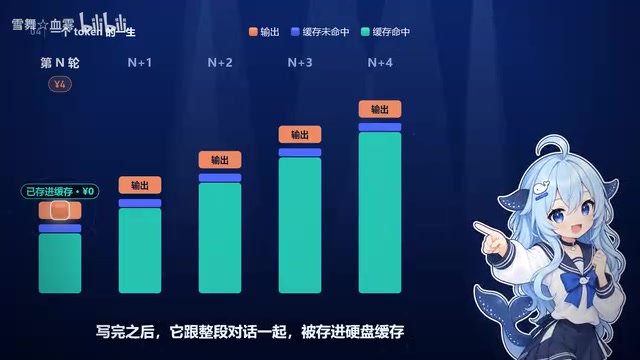
前缀缓存(Prompt Caching)
这类机制在业界通常称为前缀缓存或提示词缓存:服务端把一次请求的输入前缀及其内部计算结果(键值缓存等中间状态)保存下来,下次请求若前缀完全相同,就直接复用,跳过重复计算。它节省的主要是算力和时间,因此价格能显著低于未命中。
命中与未命中的判定
判定依据是前缀的逐token比对:从第一个token开始,连续相同的部分才算命中,一旦出现差异,后续全部按未命中计算。所以缓存命中率取决于“公共开头有多长、是否稳定”,而不是整段内容是否相似。
缓存的两个硬约束
缓存并非万能。它只认“一字不差的开头”——只要开头改一个字,后面的缓存全部作废。这解释了为什么系统提示词的微小改动会让成本骤升。
另一个约束是“尽力而为”:缓存不保证每次都命中。此外,工作日高峰时段价格会翻倍,进一步放大了未命中缓存的代价。
TTL与缓存淘汰
“尽力而为”背后是缓存的生命周期管理。服务端缓存通常有存活时间(TTL),长时间不访问会被清理;同时缓存容量有限,会按淘汰策略移除旧条目。这意味着即使前缀完全一致,间隔太久或服务端负载高时也可能未命中。工程上通常把稳定前缀放在最前、把易变内容后置,并尽量在缓存有效期内连续调用,以提高命中概率。
省钱的本质是“保住前缀”
UP主最后总结:该读的内容一个字没少读,但重读的钱省下了九成八。对开发者而言,优化方向很明确:保持对话前缀稳定,避免频繁改动系统提示词,把可变内容尽量后置。
这也侧面解释了标题里的疑问——账单贵五十倍,往往不是模型偏心,而是缓存命中率的天壤之别。理解token的生命周期,比换更便宜的模型更能直接降低成本。
相关推荐

9家AI订阅套餐积分换算:每亿Token真实成本揭秘
B站UP主实测火山、阿里、腾讯、百度、智谱、小米、MiniMax等9家AI订阅套餐,统一换算每亿Token真实成本,拆解固定额度与三档系数两类计费逻辑,揭示缓存、时段折扣和窗口限额对实际额度的影响。

Vibe Coding入门:用意图表达代替手写代码
Vibe Coding 是什么?B站137集实战课程给出定义:核心不是写代码而是表达意图。本文解析 Vibe Coding 的生产力逻辑、适合人群与入门预期,帮助零基础者判断是否值得投入学习。
LangChain入门指南:从LangGraph到Deep Agents的智能体开发路线
理清LangChain、LangGraph和Deep Agents的封装关系,掌握智能体开发框架的学习路线与选型逻辑,适合大模型开发入门者参考。