Uber如何用Omni MCP解决MCP最大的上下文难题

Uber用四个元工具构建Omni MCP代理,解决5000个工具撑爆AI智能体上下文的问题。
当Uber内部MCP工具数量膨胀至5000个、分布在800余台服务器上时,传统MCP"先列举全部工具再选择"的机制在第一个任务开始前就会耗尽模型上下文。Uber的解决方案是Omni MCP——一个代理服务器,对外只暴露四个元工具:发现服务器、发现工具、获取工具Schema、调用工具。智能体按需逐步加载信息,每一步收窄选择范围,始终只有当前所需的少量定义进入上下文。配套的注册表作为控制平面管理工具目录,网关作为数据平面处理实际调用并执行细粒度权限(区分人类、服务、智能体三类调用方)。对于调用后结果过大的问题,系统提供响应投影(预先声明所需字段)和代码模式(结果落盘后用grep过滤)两种机制。Uber未公布实测token节省数据,但Anthropic类似设计的示例曾实现98.7%的压缩率。
问题的起点:5000个工具塞爆上下文
MCP(Model Context Protocol)已成为AI智能体调用工具的标准方式,但当工具数量膨胀到一定规模时,一个尖锐的问题浮出水面:一个拥有5000个工具的智能体,还没读到你的任务,上下文就已经被填满了。
Uber报告称其内部有超过5000个MCP工具,分布在超过800个服务器上。上下文是模型一次能读取的文本量,如果按传统方式手动配置数百个服务器,光是工具清单就会撑爆这个空间。
在标准的MCP流程中(2025年11月25日版本的规范),客户端先列出工具,模型挑选一个,客户端再调用它。每个工具定义都包含名称、描述和输入schema(描述该工具接受哪些字段的简短说明)。问题在于:列举这一步会把每一个定义都塞进上下文。在Uber的规模下,这意味着数千个定义同时涌入。
更棘手的是,MCP本身没有跨服务器搜索能力。正如Uber所写,智能体必须事先就知道该与哪个服务器对话,才能去询问那里有哪些工具可用。这是一个鸡生蛋的死循环。
MCP(Model Context Protocol)是由Anthropic于2024年底提出并开源的协议,旨在为AI模型与外部工具、数据源之间的通信提供统一标准。其设计类似于USB-C的理念:无论工具来自哪个服务商,只要符合MCP规范,智能体就可以用同一套方式调用它。协议规定了三种核心原语:工具(tools,可执行操作)、资源(resources,可读取数据)和提示(prompts,预定义的模板)。在工具调用场景中,客户端通过tools/list接口获取服务器上所有工具的完整定义,每条定义包含名称、自然语言描述和JSON Schema格式的输入参数说明。这套机制在工具数量较少时运作良好,但协议本身没有分页、懒加载或跨服务器搜索的原生设计,当工具规模膨胀到企业级时,"先列举全部"的假设就成了性能瓶颈。
Omni MCP:四个元工具改写游戏规则
Uber给出的答案是Omni MCP——一个位于智能体和其他服务器之间的代理服务器。它对外暴露四个元工具(meta tool,即用来发现和调用其他工具的工具)。
智能体按顺序使用这四个工具:发现服务器(discover server)、发现工具(discover tools)、获取工具schema(get tool schema)、调用工具(invoke tool)。核心思想是:只有智能体主动请求的内容才会进入上下文,智能体永远不会看到完整的工具定义清单。
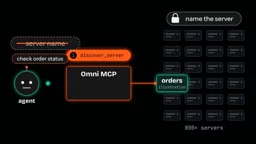
让我们用一个假想请求走一遍流程。假设某个智能体需要查询一笔外卖订单的状态:
第一步:发现服务器
智能体发送一个表达意图的查询,比如"检查订单状态",工具返回一个匹配的服务器。这里的关键是:智能体不需要指定服务器名称,这就解决了前面那个"必须先知道服务器"的死循环。
不过Uber的文章并未说明discover server如何对服务器排序——它可能是关键词匹配,也可能用模型来比较语义。这个选择直接影响第一步的效果。
第二步:发现工具
智能体指定第一步得到的服务器,工具返回该服务器的工具列表。回复中很可能为每个工具附带简短描述,因为智能体需要据此做出选择。Uber用大语言模型(LLM)为发现的工具自动撰写"智能体友好"的描述——描述质量差会把智能体导向错误的工具,所以文本质量本身就是设计的一部分。
第三步:获取工具schema
智能体选定一个工具,索要它的JSON schema。标准MCP定义本就携带相同的输入描述,但现在智能体只加载一个schema,而非数千个。智能体不去猜字段,而是直接从schema中读取。
第四步:调用工具
智能体根据schema填入参数并发起调用,请求送达拥有该工具的服务,结果返回给智能体。这一步根本不需要目录的其余部分。
数一数到底有什么进入了上下文:一个服务器、一份该服务器的工具列表、一个schema、一个结果。剩下5000多个工具始终停留在上下文之外。

每一步都在收窄选择范围——先选服务器,再选该服务器下的某个工具,最后填参数。判断这类设计好坏的通用标准是:问每一步是否给下一步留下了更少的选择。
幕后架构:注册表、网关与权限控制
Uber的系统还有两个关键组成部分。注册表(registry)是控制平面,持有工具目录,记录哪些工具存在;网关(gateway)是数据平面,负责处理实际调用。不过文章没有详细说明这两者与Omni MCP的具体关系。
网关会把一次MCP调用转换为三种协议之一——HTTP、gRPC或t-channel——然后把执行交给Motley(Uber的服务网格sidecar,即运行在服务旁边的辅助进程)。
目录的填充有两条路径:原生MCP服务器直接用list tools查询;对于其他服务,一个叫autocrawler的工具读取用protobuf或thrift写的接口定义文件。autocrawler同样让LLM为发现的工具撰写友好描述,然后注册每一个工具——每个工具初始状态都是禁用的。
Uber明确表示:每个MCP服务器和工具都从禁用状态开始,必须由负责的团队显式审查并启用。也就是说,机器先写文本,人再做决定,而这个审查与权限检查是分开的。

在权限层面,网关使用Uber内部的访问控制系统来施加所谓的"charter策略"。规则按服务器设置,单个工具可以有自己的覆盖规则。更精细的是,策略还取决于调用方——网关会检测调用方是人类、服务还是智能体,同一个工具可以针对三种调用方设置不同规则。授权和个人数据(PII)脱敏都是按工具生效的。
不过文章没说清discover tools这一步是否会按调用方权限或工具启用状态进行过滤。合理的做法是两者都过滤,这样智能体就无法选中它无权调用的工具——在调用发生之前,发现阶段就减少了进入上下文的内容。
Protobuf(Protocol Buffers)和Thrift是两种主流的接口定义语言(IDL),常用于微服务之间的合约描述。Protobuf由Google开发,Thrift由Facebook(现Meta)开发,Uber历史上大量使用Thrift。autocrawler通过解析这些IDL文件来"理解"服务暴露了哪些方法及其参数类型,再由LLM将机器友好的接口签名转化为自然语言描述,供智能体在发现阶段进行语义匹配。这种"IDL→LLM描述→工具注册"的流水线意味着:凡是已有接口定义的服务,无需改造即可接入Omni MCP体系,大幅降低了存量服务的迁移成本。sidecar模式(Motley所采用的)是服务网格的典型部署方式,辅助进程与主服务共同部署在同一容器组中,负责处理流量路由、鉴权、可观测性等横切关注点,主服务无需感知这些基础设施细节。
结果过大的第二个难题
发现机制解决了调用前的上下文问题,但调用后仍有隐患:一个过大的返回结果同样能撑爆上下文。Uber对此有两个应对方案。
第一个是响应投影(response projection)。智能体在收到结果前就声明自己想要哪些字段。在前面的订单例子里,智能体只请求status字段,而不是整条订单记录。网关在模型读取之前就剔除其他字段。
第二个是针对shell智能体的代码模式(code mode)。shell智能体通过终端工作,用命令行工具aifx调用MCP工具,其命令包括list、search和call。智能体可以在一条命令里链式调用,把输出写入文件,再用grep(文本搜索工具)搜索这些文件,只把需要的部分加载进上下文。

假设一次调用返回一长串订单,输出先落盘成文件,grep找出智能体想要的那一条,只有这一条进入上下文。文件保留完整结果,上下文只保留匹配项。需要注意的是,Uber只针对代码模式描述了文件方案,对Omni MCP如何处理超大结果——是截断、限制大小还是写入文件——文章并未明说。
响应投影(response projection)在概念上与GraphQL的字段选择机制相似:调用方在请求时声明只需要响应体中的哪些字段,服务端或中间层在返回前裁剪掉其余内容。这种做法将"减少噪声"的职责从模型端前移到网关端,避免了大体积JSON先进入上下文再被忽略的浪费。实现上,网关需要在转发调用结果时执行一次结构化过滤,这要求工具的返回格式可预测(通常是JSON对象),对于返回非结构化文本或二进制内容的工具则难以直接应用。值得注意的是,投影字段由智能体在调用时动态声明,这意味着智能体必须在获取schema阶段就对返回结构有足够了解,才能准确指定所需字段——这进一步强调了第三步"get tool schema"中schema描述质量的重要性。
到底省了多少?一个诚实的空白
这里有个值得警惕的地方:Uber没有公布任何实测的token节省数据、延迟数字或百分比。 任何关于Uber节省量的数字都只是猜测。
作为对比,Anthropic在2025年11月4日描述了一个类似思路——按需加载工具定义、在代码中过滤结果。其示例把150,000个token压缩到2,000个,节省98.7%。但这是另一个系统的示例,并非对Uber网关的测量。它展示了某个例子能达到的程度,但对Uber的实际效果什么都没说明。
什么时候该用这套设计
整个循环可以概括为:发现、列举、获取、调用。网关在请求路径上执行权限,投影和文件机制让大结果留在上下文之外。
如果你运行着许多MCP服务器,值得尝试这套设计。但第一步是测量你的工具清单:数一数在第一个任务开始前,你的工具清单消耗了多少token,再和模型的上下文大小对比,这就能看出Uber式设计能给客户端腾出多少空间。
反过来,如果你只运行一个服务器、只有少量工具,那就保留标准的列举方式——四个步骤意味着更多的往返调用,这笔额外成本未必划算。
动手之前,先做三个决定:发现阶段是否隐藏调用方无权使用的工具?权限在哪一步执行?网关如何处理超大结果?想清楚这三点,再去搭建。
相关推荐

食品加工程度如何影响代谢与大脑活动
食品加工程度不仅影响营养吸收,还可能改变人体代谢节奏并影响大脑活动。本文解析加工食品如何干扰血糖、代谢路径与大脑奖赏机制,以及它对日常饮食选择的启示。

Windows-MCP详解:UIA如何让AI智能体掌控本地桌面
深入解析开源项目 Windows-MCP 如何借助 UIA 框架,把桌面界面翻译成语义文本树,让 AI 智能体通过本地 STDIO 管道直接操控 Windows,并剖析其特权继承带来的安全风险与防护实践。

Grokbot实测:5分钟搭建8个董事会AI助手
Grokbot演示如何在五分钟内搭建8个AI智能体加1个协调者,为董事会成员处理财务审阅、战略规划与风险评估。本文解析其配置流程、协调机制与模板化设计思路,并给出实用注意事项。