UltraFast体验:快到飞起,贵到离谱的AI编程模式

花500美元实测AI编程极速模式:UltraFast重塑心流体验,但成本高到几乎无人该用。
一位开发者自费超500美元,测试了OpenAI Codex的UltraFast模式——该模式搭载Astra模型,吞吐量达320-340 TPS,是常规速度的10倍。极速推理将代码生成等待从10分钟压缩至30秒,使开发者能以18-38秒每轮的节奏持续迭代,重新激活了久违的"心流状态",并催生出原本不会产生的UI创意。然而代价极其高昂:输出token高达300美元/百万,同等任务成本是Sol 6.1的40倍,500美元套餐额度仅需2.1小时即可烧光。作者结论明确:UltraFast目前几乎无人应该使用,它更像是面向未来的实验品。真正的希望在于即将推出的Sol 6.1 UltraFast——若沿用相同价格倍率,成本可能比当前Astra标准版还低,届时才是性价比真正成立的时刻。
一位开发者花了超过500美元,只为验证一件事:当AI模型生成代码的速度从每秒30 token飙升到300 token时,整个编程体验会发生什么样的质变。结论很矛盾——UltraFast好用到让人上瘾,却也贵到几乎没人该用它。
当推理速度不再是瓶颈
UltraFast搭载的是真实的Astra模型(作者原以为跑在Cerebras上,后来确认是基于NVIDIA的优化方案),实测吞吐量在320到340 TPS之间,而常规速度只有30 TPS,Fast模式约60 TPS。这意味着一次原本需要10分钟的代码生成,现在30多秒就能完成。
这种速度差带来的不只是"等待时间缩短",而是工作模式的根本改变。作者描述了一个场景:他让模型把应用改成浅色模式并"更有趣一点",然后实时看着页面在开发服务器里逐步更新。整个过程无需剪辑、无需跳过等待——这是传统AI编程里从未有过的体验。
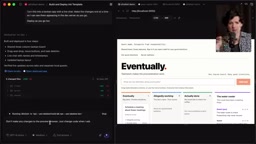
一个值得玩味的技术细节:当推理从10分钟降到30秒,那些原本可以忽略的git命令、构建操作、工具调用,占总运行时长的比例突然变得显著。作者因此专门调整了系统提示词,让模型避免调用那些"耗费数秒"的工具(比如自动更新预览浏览器),因为这些操作现在可能直接让运行时间翻倍。
**TPS(Tokens Per Second)**是衡量大语言模型推理速度的核心指标,表示模型每秒能生成多少个token。一个token大致对应0.75个英文单词或约1.5个汉字。主流托管模型的典型输出速度在30-80 TPS之间,而人类阅读速度约对应10-15 TPS——这意味着即便是"普通"速度的模型,输出速度已远超人类阅读,但对于代码生成这类需要等待完整可运行结果的场景,总体延迟仍可高达数分钟。320-340 TPS意味着模型输出速度比人眼能跟上的速度快出20倍以上,使得"看着代码实时刷新"成为可能,而非等待一个静态的最终结果。Cerebras是一家专注于晶圆级芯片(Wafer Scale Engine)的AI硬件公司,其架构特别擅长低延迟、高吞吐的推理任务,是目前少数能在商业服务中实现数百TPS的硬件方案之一。NVIDIA的优化方案则通常基于TensorRT-LLM等推理框架,通过量化、算子融合等手段在传统GPU上压榨极限吞吐。
价格:令人窒息的6倍溢价
Astra本身在API上就不便宜,输出每百万token收费50美元。而切换到UltraFast后,这个数字直接跳到300美元/百万token——如果是长上下文项目,还会进一步涨到450美元。缓存读取成本也水涨船高:普通缓存读取涨到6美元/百万,比其他模型的常规读取还贵,而75美元的缓存读取价格则"高得难以置信"。
作者给出了几组真实数据来量化这种疯狂:
- 审查两个各不到100行代码的PR,花费约600美元
- 用UltraFast构建一个应用,实际花费46.32美元;如果按标准API价跑Astra,只需7.72美元;而用Sol 6.1常规速度完成同样的工作,仅需1.10美元
- 换算下来,UltraFast的成本是Sol 6.1的40倍以上
在500美元/月的UltraFast套餐里,每周给约1000美元的额度,但在UltraFast模式下只需2.1小时就能烧光。作者实测:发两个提示词(一个构建用38秒,一个改浅色模式用16秒),额度就从38%掉到37%——不到一分钟的工作消耗了1%。连OpenAI内部员工现在都要"按任务申请审批"才能用UltraFast,因为连他们的算力也顶不住。
理解这些价格数字需要一点上下文。大语言模型的API定价通常分为输入token和输出token两类,代码生成场景的成本主要由输出token驱动,因为生成比读取计算量大得多。**缓存读取(Cache Read)**是指当同一段上下文(如系统提示词、长文件)在多次调用中重复出现时,服务商将其缓存以降低重复计算成本,通常价格仅为普通输入的10%-25%。UltraFast将缓存读取从廉价操作变成昂贵操作(6美元/百万,甚至75美元/百万),意味着长上下文项目——恰恰是最能体现速度价值的场景——反而面临成本的指数级膨胀。PR审查花费600美元这一数字之所以触目惊心,正是因为代码审查需要反复读取大量上下文,缓存命中率越高,在UltraFast下反而越贵。
为什么它仍然让人着迷
尽管成本离谱,作者却坦言"一旦习惯了UltraFast,其他一切都变得慢得难受"。真正的价值不在于省时间,而在于它重新激活了那种久违的心流状态。
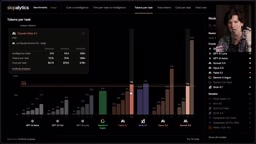
作者用自己构建的应用Slopalytics举例。他同时用Opus 5.5和Astra UltraFast做同一个任务:Opus花了约15分钟才出第一版可用草稿,UltraFast只用了不到两分钟。Opus的首版设计明显更好看——但等作者看到Opus版本时,Astra那版经过几轮实时反馈已经反超了。
关键在于交互方式的转变。用Opus时,他的习惯是"看输出、列20条修改意见、发出去、然后等5分钟到2小时"。而用UltraFast,他在一个线程里发了50多条消息,时间戳显示有时四分钟内发五个提示,每个回复都在一分钟内、有的只要18到20秒。这种"你根本没时间分心"的节奏,让他想出了很多原本不会想到的UI交互模式——比如模型对比视图、悬停显示差异的图表,全都是在盯着实时更新的界面时临场迸发的灵感。
他甚至说:"如果没有UltraFast,我可能根本不会完成Slopalytics。"因为Astra的设计能力客观上比Opus和Fable差,但因为能实时在环中迭代,反而做出了更好的UI——设计的本质是用户感知,而他能把更多时间花在"感知"上。
心流状态(Flow State)是心理学家米哈里·契克森米哈伊提出的概念,指人在完全投入某项活动时进入的高度专注、忘却时间流逝的最佳体验状态。进入心流的关键条件之一是即时反馈——任务执行与结果呈现之间的延迟越短,越容易维持注意力连续性。传统AI辅助编程中,5到15分钟的等待足以让开发者切换到其他标签页、打断思路,导致每次重新看到输出时都要重新"加载上下文"。UltraFast将这个延迟压缩到18-38秒,接近人类自然的思考节奏,使开发者能在同一认知状态下持续迭代——这正是作者在一个线程里能发出50多条消息、并临场迸发出意想不到的UI创意的底层原因。这种体验与游戏设计中的"响应性"原则异曲同工:系统响应延迟超过100ms用户会感知到"卡顿",而编程工具的"认知卡顿"阈值大约就在几分钟量级。
到底该不该用?真正的希望在后面
作者的态度非常明确:现在几乎没有人应该碰UltraFast。它太贵、烧额度快得荒唐、让500美元套餐变得毫无意义。他认为OpenAI以这个价格发布它本身就很疯狂,而且不该做成"点一下就能用"的样子——就像最高推理档位一样,给用户一个旋钮,用户就会拧到底,结果酿成一堆糟糕决策(Primeagen买了500套餐,一小时就烧掉一半额度)。
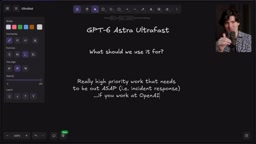
那它存在的意义是什么?作者的观点是:UltraFast不是用来用的,而是用来做实验的。它让少数愿意烧token的人提前体验这种流畅感,为一个更美好的未来铺路——在那个未来里,你能以不让人恶心的价格获得这种速度。
这个希望并非空想。视频中提到,Tebow已经公开确认Sol 6.1 UltraFast即将推出(可能基于Cerebras,也可能是NVIDIA的优化方案)。作者算了一笔账:如果6.1 Sol的UltraFast沿用同样的6倍价格倍率,那它不仅比Astra UltraFast便宜10倍,甚至可能比Astra标准速度还便宜。到那时,这个500美元套餐就可能从"溢价虚高"变成"物超所值"。
至于当下的使用建议:
- 只在"不用白不用"时使用——比如账号即将重置、还有大量额度待消耗
- 理论上可用于高优先级事故响应,但即便如此,除非"钱不是真金白银",否则也很难justify
- 不要为了UltraFast升级到500美元套餐,至少现在不值
- 作者本人日常严肃工作仍用Opus,把Codex账号清零也不影响他
作者还预告将单独做一期视频,讨论不含UltraFast但包含Sol 6.1、Astra、Fast模式的200美元套餐是否值得。对于普通开发者来说,这或许才是更现实的选择。
相关推荐

beacon.sh:为AI编程助手装上自我进化记忆
beacon.sh 是一款开源、可自我进化的 AI 编程代理记忆层,支持 Claude Code、Cursor、Codex 等 20 多个 harness,把代理会话转化为复利式知识层,解决跨工具记忆断层问题。

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。