Unsloth 新版发布:内置浏览器、语音克隆与低显存训练全面升级

Unsloth v0.1.903-beta 将内置浏览器、语音克隆工具链和多模态嵌入模型整合进本地AI工作台,并大幅优化训练显存与推理速度。
Unsloth 最新 beta 版本在功能广度和底层性能两个维度同时发力。应用层面,聊天界面新增了功能完整的内置浏览器面板,支持多标签页、高亮提问和即将到来的浏览器自动化;音频工具链覆盖语音克隆、人声转换、音轨分离、音乐生成和带说话人识别的转录,配套 70 余个 GGUF 模型;同时第一时间支持 Google EmbeddingGemma 2 多模态嵌入模型,可将文本、代码、图像、视频和音频统一向量化,代码检索任务较上代提升约 14%。性能层面,层卸载功能将 Llama-3.1-8B 的 4-bit 训练显存上限压至 7 GiB,无填充训练在 Colab 上步速提升 5 到 8 倍,Apple Silicon 和 AMD 平台也获得针对性加速。这一版本标志着 Unsloth 正从专注微调效率的工具库向更完整的本地 AI 集成工作台演进。
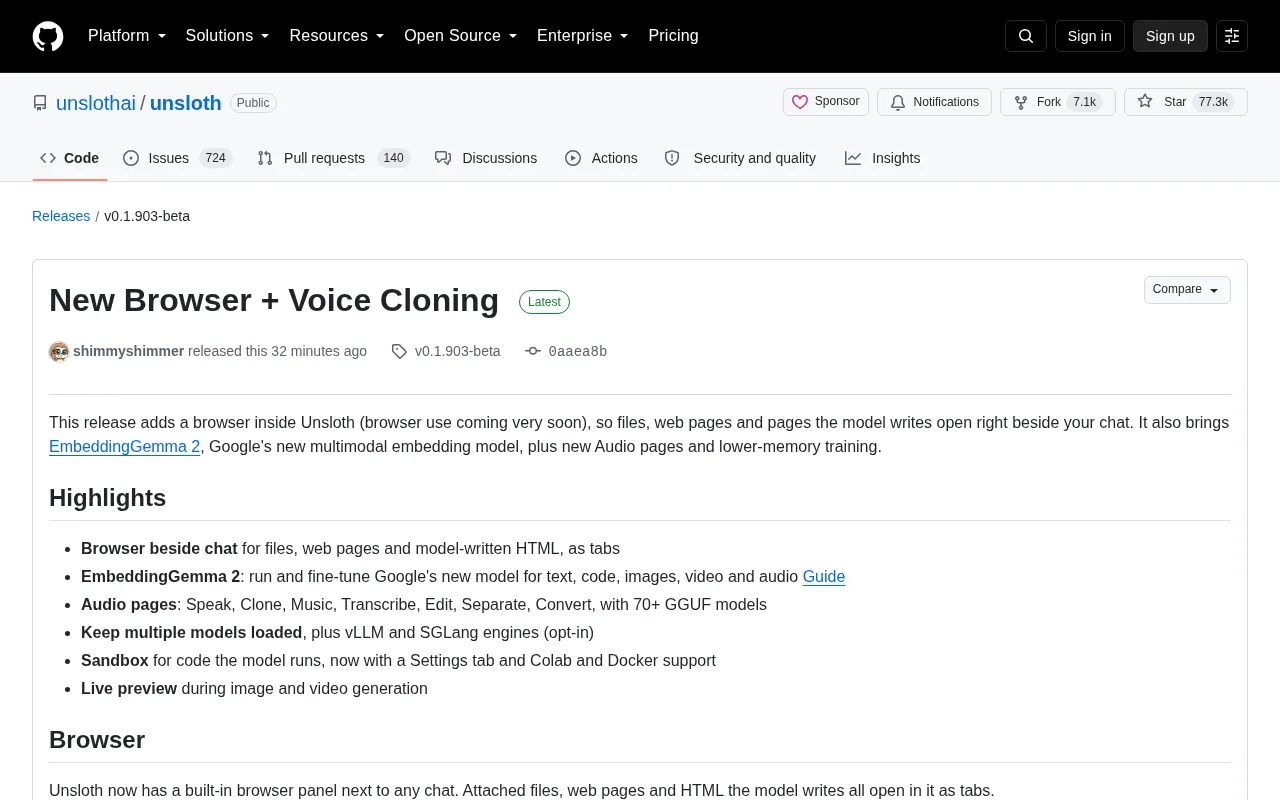
开源 AI 训练工具 Unsloth 发布了 v0.1.903-beta 版本,这次更新把一个完整的浏览器、语音克隆套件和 Google 全新的多模态嵌入模型 EmbeddingGemma 2 塞进了本地工作流,同时在训练显存和推理速度上做了大幅优化。对本地部署和微调模型的开发者来说,这是一次功能密度相当高的迭代。
聊天旁边多了一个真正的浏览器
最抢眼的变化是 Unsloth 现在在聊天界面旁内置了一个浏览器面板。模型生成的文件、网页以及它自己写出的 HTML,都会以标签页的形式直接在旁边打开,不再需要来回切换窗口。
这个浏览器并不是简单的预览器,而是一个功能完整的真实浏览环境:有地址栏、搜索、多标签页、页内查找、缩放、书签、历史记录和下载功能。PDF、Office 文档、HTML、Markdown、代码和纯文本都能作为标签页打开。
模型写出的 HTML 和代码会带着预览、控制台和「Request edits」入口打开,官方明确表示这一功能将取代原有的 Canvas。此外还有一个值得关注的交互设计——「Ask about this page」:用户可以高亮页面的某部分内容,然后直接向模型提问;右键点击标签页还能将其固定或分叉成一个新的聊天。
在设置里,用户可以选择搜索引擎、设定默认缩放,并从 Chrome、Safari、Firefox 或 Edge 导入书签。安全方面,Unsloth 强调网页环境与账户、聊天记录和 API 是隔离的,网页无法访问这些敏感数据。官方也预告了「browser use」(浏览器自动化操作)功能即将到来。
语音克隆与完整音频工具链
这次更新新增了专门的音频页面,功能覆盖面相当广,配套提供了 70 多个 GGUF 模型。核心能力包括:
- Clone(克隆):从一段简短的样本中克隆声音并保存。
- Edit(编辑):直接修改录音中的词句,同时保持说话者原本的音色。
- Separate(分离):把一首歌拆分成人声、鼓和其他音轨。
- Convert(转换):把一个人的声音转换成另一个人的声音。
- Music(音乐):生成歌曲和音效,并能编辑片段中的某些部分。
- Transcribe(转录):带时间戳和说话人识别,可导出字幕。
从 Speak、Clone、Music 到 Transcribe、Edit、Separate、Convert,这套音频工具基本把语音生成、识别、编辑和分离的常见场景都覆盖了。背后由新增的 audio.cpp 原生引擎驱动,专门处理语音、音乐和听写任务。对需要本地化、注重隐私的音频处理用户来说,这是一个不小的补充。
EmbeddingGemma 2:Google 的新多模态嵌入模型
这次 Unsloth 第一时间支持了 Google DeepMind 的新嵌入模型 EmbeddingGemma 2。它能把文本、代码、图像、视频和音频转成向量,用于搜索、RAG(检索增强生成)、分类和聚类等任务。
模型规格上,完整版有 7.4 亿参数,纯文本版本则是 2.7 亿参数,并可选配视觉和音频编码器。它支持 100 多种语言,上下文窗口为 8K。性能方面,官方给出的数据是在代码任务上比第一代 EmbeddingGemma 提升了约 14%(MTEB code 得分 78.68 对比 68.76)。
在使用方式上,用户可以把 GGUF 或 safetensors 格式导入 Unsloth 本地运行,或者用 llama.cpp 提供文本嵌入服务。文本模型可以通过 FastSentenceTransformer 微调,支持 4-bit QLoRA 或 BF16 LoRA。一个容易被忽视但很实用的细节是:EmbeddingGemma 和 Qwen3-Embedding 的微调现在会保存模型内置的 query 和 document 提示词,而不是空提示——这对嵌入质量有直接影响。
嵌入模型(Embedding Model)与常见的文本生成模型在用途上有本质区别:它不输出自然语言,而是把输入内容压缩成一个固定维度的稠密向量(即"嵌入")。语义相近的内容在向量空间中距离更近,这一特性使其成为语义搜索、RAG 系统和推荐引擎的基础组件。RAG(Retrieval-Augmented Generation,检索增强生成)是目前主流的大模型落地范式之一:先用嵌入模型把知识库文档向量化存入数据库,用户提问时同样向量化后检索最相关的片段,再交给生成模型作答——这样可以在不重新训练模型的情况下注入私有知识。EmbeddingGemma 2 支持文本、代码、图像、视频和音频的统一向量化,意味着可以跨模态检索,例如用文字描述查找匹配的图片或视频片段,这在纯文本嵌入模型中是无法实现的。MTEB(Massive Text Embedding Benchmark)是评估嵌入模型的标准化基准测试集,涵盖检索、分类、聚类等多个任务类别,code 子集专门衡量代码理解与检索能力。
训练显存与速度的实打实优化
如果说前面的功能偏向应用层,这部分则是 Unsloth 的老本行——让训练更省显存、跑得更快。
层卸载(Layer offload) 是本次重点,这是一个针对 LoRA、NVIDIA 和 AMD 显卡的可选功能。通过 offload_layers 把冻结的层保留在系统内存中,Llama-3.1-8B 的 4-bit 训练可以把显存上限压到 7 GiB。
在 Colab 这类常见场景下,无需 flash-attn 的无填充训练(padding-free training)也更快了:Qwen3-0.6B 的显存占用从 5.45 GB 降到 1.87 GB,每步速度提升 5 到 8 倍。此外,gpt-oss-20b 的 QLoRA 在 NVIDIA 上快了 2 到 3 倍。
图像和视频生成同样受益:NVIDIA 上支持渲染时实时预览,老 GPU 上的 Z-Image-Turbo 最高快 20 倍,且相同种子在重启后能复现相同图像。AMD 方面可以导出微调模型给 Ryzen AI NPU 使用。Apple Silicon(MLX)上,Qwen3.6-35B-A3B 回复快约 10%,长提示启动也更快,M5 芯片还新增了实验性的 Int8 Prefill,长提示读取最高快 1.5 倍。
LoRA(Low-Rank Adaptation)是当前最主流的大模型微调方法之一,核心思路是在原有预训练权重旁边注入少量可训练的低秩矩阵,训练时只更新这部分参数,从而大幅降低显存和计算开销。QLoRA 在此基础上进一步将基础模型权重量化为 4-bit 精度存储,可将显存需求压缩至全精度微调的 1/4 左右,使消费级显卡也能微调数十亿参数的模型。层卸载(Layer Offload)则是另一种互补的节省显存策略:LoRA 微调时基础模型的冻结层不需要参与梯度计算,因此可以暂时移出 GPU 显存、存入系统内存(RAM),只在前向传播需要时再加载回来,代价是会引入一定的 CPU-GPU 数据传输延迟。无填充训练(Padding-free Training)针对的是批处理时序列长度不一致的问题——传统做法需要用填充符将短序列补齐到批次内最长序列的长度,这些填充位的计算完全是浪费;无填充训练将所有序列拼接后直接处理,从根本上消除了这部分冗余计算,在序列长度差异较大的数据集上效果尤为显著。
更灵活的模型管理与沙箱
除了上述大块功能,这个版本在工程细节上也做了很多打磨。模型管理方面,现在可以同时加载多个模型(默认关闭,在设置中开启),每个请求由它指定的模型来回答;还新增了对 vLLM 和 SGLang 引擎的可选支持(Linux + NVIDIA GPU,实验性)。
安全上,模型用 Python 和 Terminal 工具运行的代码被限制在沙箱内,对电脑的访问受限。Linux 和 macOS 有操作系统级沙箱,Windows 11 预览版也可选开启,并且现在能在 Colab 和 Docker 中工作。
生态整合方面同样下了功夫:用户可以把 Cursor、Claude Code 和 Codex 的聊天记录导入项目;unsloth start --app 能让 Codex、OpenCode、OpenClaw广告 和 Hermes 等桌面应用调用本地模型。Auto-compact 现在也支持 Claude、OpenAI 这类 API 模型和 MLX 聊天。
小结
从更新内容的广度看,Unsloth 正在从一个「高效微调工具」向一个更完整的本地 AI 工作台演进。内置浏览器、音频工具链和多模型加载让它越来越像一个集成环境,而层卸载、无填充训练这些底层优化则延续了它一贯的省显存传统。对于显卡资源有限、又希望在本地完成微调、推理、嵌入和多媒体处理的开发者来说,这个版本提供了相当实在的升级价值。考虑到仍是 beta 版本(部分引擎标注为实验性),生产环境使用前建议先做充分验证。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。