UvA-MT的WMT26机器翻译方案:LLM推理时优化策略

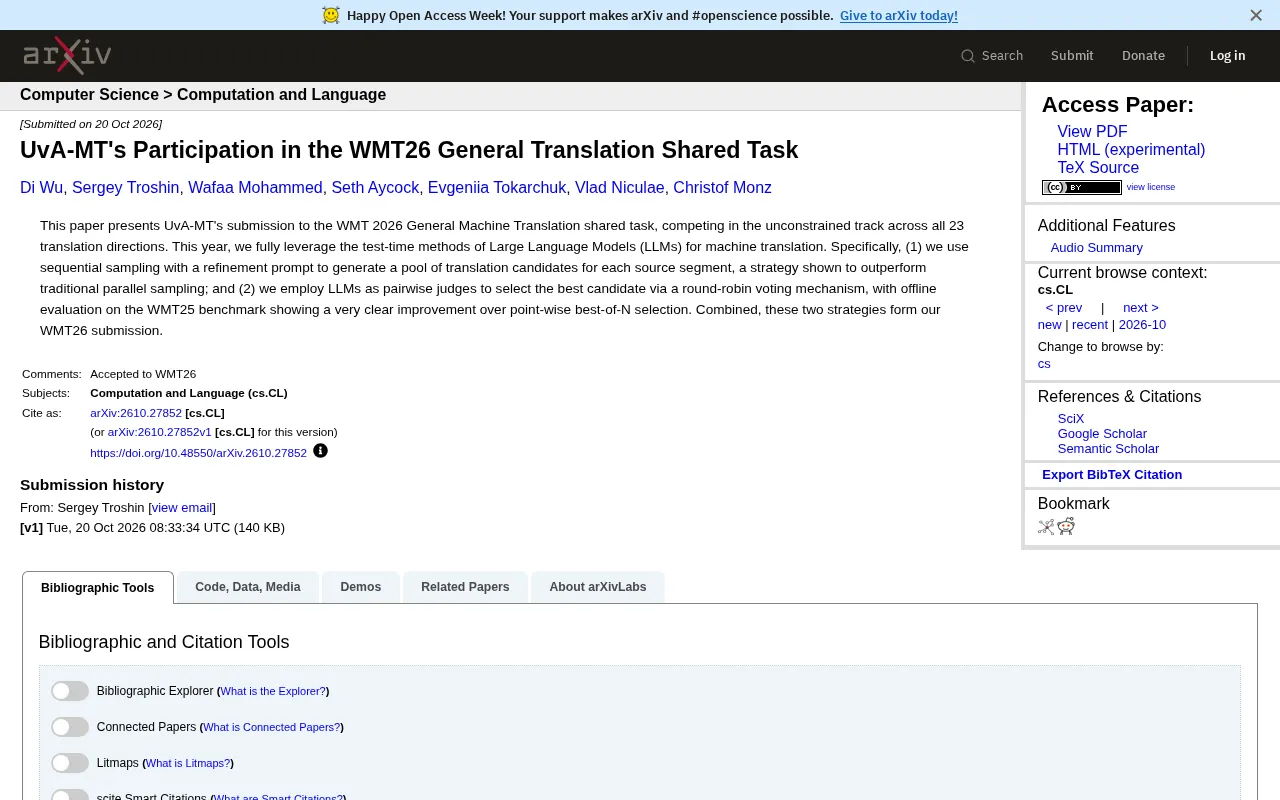
UvA-MT在WMT26全部23个翻译方向采用纯推理时优化,顺序采样加精炼提示生成候选,LLM成对评判循环投票选最佳。
阿姆斯特丹大学机器翻译团队在WMT26通用机器翻译共享任务中,提交了一套完全基于LLM推理时优化的方案,覆盖全部23个翻译方向的无约束赛道。该方法不额外训练模型,核心包含两个组件:一是带精炼提示的顺序采样,让模型参考前序候选逐步改进译文,效果优于并行采样;二是LLM成对评判配合循环投票,从候选池中选出最佳译文。在WMT25基准上的离线评估显示,成对投票明显优于逐点最优N选。该工作表明推理时计算正成为与模型规模同等重要的质量杠杆,但推理成本显著上升,实际部署需权衡延迟与质量。
阿姆斯特丹大学(UvA)机器翻译团队在WMT26通用机器翻译共享任务中提交了一套基于大语言模型(LLM)推理时优化的方案,覆盖全部23个翻译方向的无约束赛道。与往年侧重模型架构或训练数据不同,今年他们完全押注于测试时方法——即在不额外训练模型的前提下,通过巧妙的解码与选择策略释放LLM的翻译潜力。
方法拆解:从生成候选到投票择优
UvA-MT的方案包含两个核心组件,形成一条完整的“生成-选择”流水线。
顺序采样与精炼提示
第一个组件是带精炼提示的顺序采样(sequential sampling with a refinement prompt)。传统做法通常采用并行采样,即独立生成多个翻译候选,彼此之间没有信息交互。UvA-MT则让模型在生成过程中参考前序候选,通过精炼提示引导模型逐步改进翻译质量。论文指出,这种顺序采样策略在效果上优于传统的并行采样。
从工程角度看,这一设计利用了LLM的上下文学习能力:每次采样不仅生成一个候选,还为后续采样提供了可借鉴的“草稿”。对于机器翻译这种输出空间相对受限的任务,逐步精炼比独立采样更容易收敛到高质量译文。
上下文学习(in-context learning) 指LLM无需更新参数,仅通过提示中提供的示例或先前生成的文本就能调整输出行为的能力。在顺序采样中,模型生成的每个候选都会作为后续生成的上下文,使后续候选能够参考并改进前序草稿。这种机制依赖LLM的强上下文建模能力,但也带来一个风险:如果前序候选质量较差,错误可能被后续采样继承甚至放大。因此精炼提示的设计至关重要,需要明确引导模型识别并修正前序译文中的问题,而非简单模仿。
成对评判与循环投票
第二个组件解决的是“从候选池中选哪个”的问题。UvA-MT没有采用常见的逐点最优N选(point-wise best-of-N),而是让LLM充当成对评判者(pairwise judge),通过循环投票机制(round-robin voting)选出最佳候选。
具体来说,候选译文两两配对,由LLM判断哪一版更好,最终统计胜场选出冠军。研究团队在WMT25基准上进行了离线评估,结果显示该方法相比逐点最优N选有“非常明显的提升”。这一发现与近期LLM评估研究的趋势一致:成对比较比绝对打分更稳定,因为模型更擅长判断相对优劣而非给出绝对分数。
逐点最优N选(point-wise best-of-N) 是LLM推理时常用的候选选择策略:给定一个源句和N个独立生成的候选译文,让模型或奖励模型对每个候选单独打分(如流畅度、忠实度),然后选取分数最高的一个。其优点是实现简单、计算开销线性增长;缺点在于绝对评分受提示词、评分尺度校准和模型偏见影响较大,不同候选之间的分数差异可能不稳定。成对比较则只要求模型判断两个候选的相对优劣,避开了绝对分数校准问题,通常更鲁棒,但需要O(n²)次比较,计算成本更高。
为什么值得关注:推理时优化的信号
UvA-MT的提交传递出一个清晰信号:在翻译质量竞赛中,推理时计算正在成为与模型规模同等重要的杠杆。不微调、不蒸馏,仅靠采样策略和选择机制就能在WMT这样的顶级评测中竞争全部23个方向,说明LLM的翻译能力可能被低估了——瓶颈往往在于如何用好它,而非模型本身不够强。
另一个值得玩味的细节是顺序采样与成对投票的组合。前者增加候选多样性并引入迭代改进,后者用相对判断替代绝对评分,两者都指向同一个原则:用更多推理计算换取更可靠的输出。这套思路完全可以迁移到其他生成任务,比如摘要、润色甚至代码生成。
当然,这套方法的代价是推理成本显著上升。为每个源句生成候选池并进行O(n²)量级的成对比较,在实际部署中需要权衡延迟与质量。论文未在摘要中披露具体计算开销,这可能是后续需要关注的实践问题。
推理时计算(inference-time compute) 指在模型训练完成后,通过增加解码阶段的计算量(如生成更多候选、进行多步推理、自我评估与选择)来提升输出质量,而非依赖更大的模型或更多训练数据。这一概念在LLM研究中日益受到重视,代表性工作包括思维链(CoT)、自洽性采样(self-consistency)和树搜索等。在机器翻译中,推理时优化表现为候选生成与重排序策略。其优势是无需标注数据或微调,可即插即用;代价是延迟和算力成本随候选数量与比较次数增长,需在质量与效率间权衡。
快速了解
- 竞赛:WMT26通用机器翻译共享任务,无约束赛道,全部23个翻译方向
- 核心方法:顺序采样+精炼提示生成候选池;LLM成对评判+循环投票选最佳
- 关键证据:WMT25基准离线评估显示成对投票明显优于逐点最优N选
- 趋势判断:推理时优化正成为机器翻译质量提升的重要方向
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。