VGDL编译为因果模型:游戏AI如何理解真实规则
游戏AI的困境:相关性≠因果性
强化学习和大语言模型在游戏环境中常陷入一个根本性难题:它们往往无法准确捕捉游戏的因果机制。标准强化学习智能体倾向于依赖虚假相关性(spurious correlations),而大语言模型则容易"幻想"出并不存在的游戏规则。
虚假相关性是统计学和机器学习中的经典陷阱。举例来说,一个在特定游戏中训练的强化学习智能体可能发现"画面左侧出现红色物体时按跳跃键会得高分",但实际的因果机制是"红色物体是敌人,跳跃可以躲避敌人攻击"。如果游戏场景变化,红色物体出现在右侧,依赖虚假相关性的智能体就会失效,而理解因果机制的智能体则能正确应对。这一问题的本质与分布偏移(distribution shift)密切相关:分布偏移是指训练环境与部署环境之间的统计分布差异,它是虚假相关性导致性能崩溃的直接机制。在强化学习中,分布偏移不仅来自环境变化,还来自策略本身的改变——当智能体采用新策略时,它访问的状态分布也会改变,形成所谓的"协变量偏移"(covariate shift)。依赖虚假相关性的智能体本质上是过拟合于训练时的状态分布,一旦分布改变便束手无策。
这一问题在游戏AI中尤为突出,因为游戏环境往往包含大量视觉和时序上的巧合模式。例如在Atari游戏的基准测试中,DeepMind的DQN智能体虽然在多款游戏中达到超人表现,但研究表明其策略高度依赖特定像素模式,微小的视觉扰动就能导致性能崩溃——这正是因为智能体学习的是关联而非因果。Judea Pearl在其因果推理层级理论中将认知分为三层:关联(seeing)、干预(doing)和反事实(imagining),传统强化学习主要停留在第一层,而因果模型能达到第三层。值得进一步说明的是,"干预"层的核心概念是Pearl提出的do-算子(do-operator):干预是指主动改变系统中某个变量的值并观察结果,区别于被动观察自然发生的数据。形式上,P(Y|do(X=x))与P(Y|X=x)可能截然不同——前者消除了X的所有因果前驱的影响,后者则保留了这些混杂因素。在游戏AI中,干预对应于智能体主动执行某个动作并追踪其后果,而非仅仅从录像数据中学习他人的游戏行为。从信息处理角度看,这三层之间存在不可逾越的鸿沟——仅靠观察数据无法回答干预问题,仅靠干预实验无法回答反事实问题,这解释了为什么单纯增加训练数据量无法从根本上解决虚假相关性问题。
尽管因果强化学习(Causal Reinforcement Learning, CRL)提升了可解释性,但一直缺乏将复杂游戏机制直接映射到因果模型的形式化方法。CRL是近年来兴起的交叉领域,其发展可追溯至2015年前后,当时研究者开始意识到标准RL框架的因果盲区。代表性工作包括Elias Bareinboim等人提出的因果MDP框架(将do-calculus引入策略优化),其中Bareinboim和Pearl在2016年提出的因果迁移学习框架利用因果图中的不变机制识别哪些知识可以跨环境迁移;Zhang和Bareinboim随后将do-calculus引入离线策略评估,解决了混杂因素导致的策略评估偏差问题。此外还有基于因果图的迁移学习方法(利用因果不变性实现跨环境泛化),以及利用因果发现算法从交互数据中自动推断环境的因果结构。在因果发现方面,PC算法、FCI算法等经典方法被改造用于从智能体的交互数据中推断环境因果结构,但这些方法在高维状态空间中面临组合爆炸和样本不足的双重挑战。现有CRL方法的共同瓶颈是因果结构的获取——要么需要从数据中学习(容易出错),要么需要专家手动指定(成本高昂)。
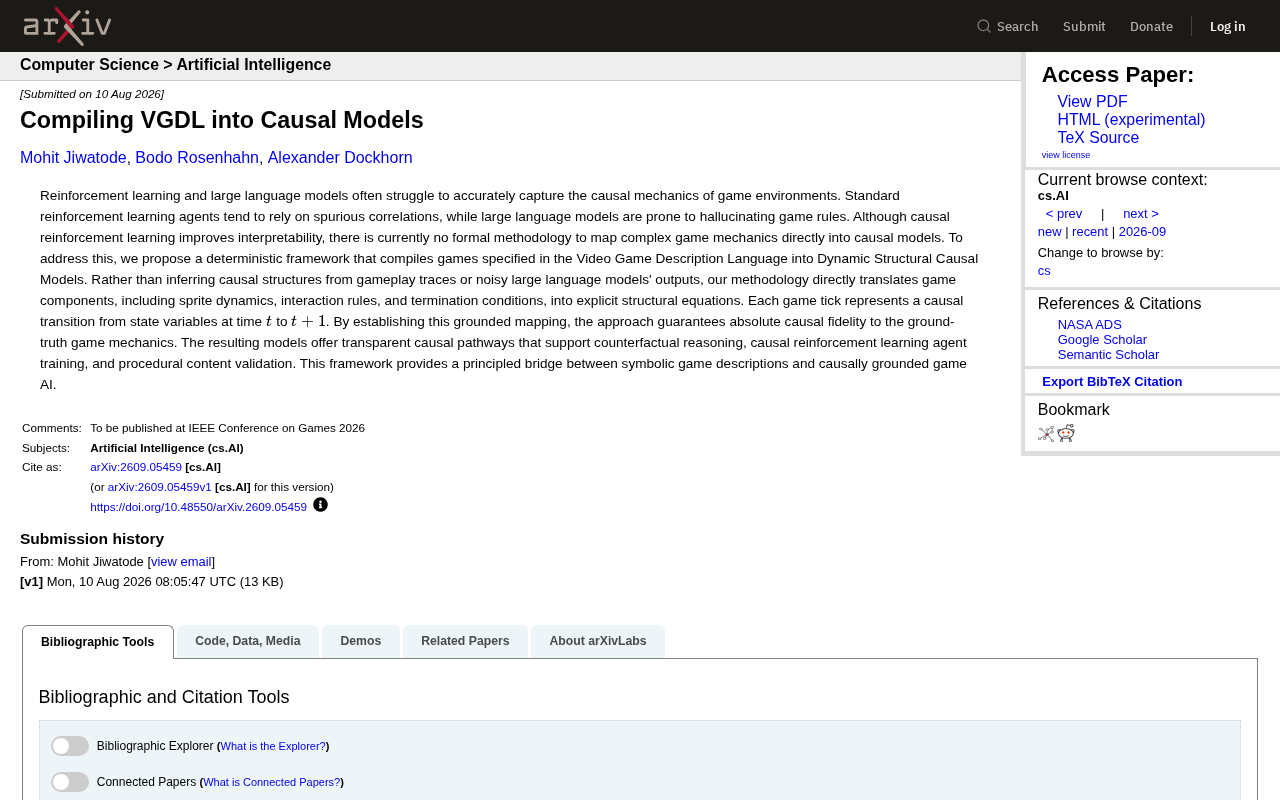
一项最新的arXiv预印本论文(arXiv:2609.05459v1)提出了创新性解决方案:通过确定性框架将视频游戏描述语言(VGDL)编写的游戏直接编译为动态结构因果模型(Dynamic Structural Causal Models)。这种方法不依赖从游戏轨迹推断因果结构,也不依赖噪声较大的大语言模型输出,而是直接将游戏组件转化为显式的结构方程。
从符号描述到因果结构
该框架的核心创新在于建立了符号游戏描述与因果基础游戏AI之间的原则性桥梁。具体而言,它将游戏的三大核心组件系统性地转换为因果表达。
VGDL(Video Game Description Language)是由Tom Schaul于2013年提出的一种领域特定语言,旨在用简洁的文本格式描述2D街机风格游戏的完整规则。VGDL的设计深受通用游戏博弈(General Game Playing, GGP)传统的影响——GGP由斯坦福大学Michael Genesereth于2005年发起,使用游戏描述语言GDL(Game Description Language)描述棋盘类和回合制游戏。VGDL可以看作GDL向实时视频游戏领域的扩展,两者共享"规则可机器解析"的核心理念,但VGDL额外引入了连续空间运动(在离散网格上模拟)、实时决策压力和视觉渲染层,从而能够描述更广泛的游戏类型。不过VGDL也有明确的技术局限性:它不支持不完全信息(所有精灵状态对玩家完全可见)、多玩家复杂交互受限(后续的Two-Player VGDL有所扩展但仍有限),且其物理模型是高度简化的网格运动而非连续物理模拟。
VGDL是通用视频游戏AI竞赛(GVG-AI Competition)的核心组件,该竞赛自2014年起在IEEE计算智能与游戏会议上举办,其核心理念是挑战AI的通用游戏能力——智能体必须在没有事先训练的情况下玩好从未见过的游戏。竞赛使用的游戏全部以VGDL编写,涵盖了从Pac-Man变体到推箱子等数十种风格各异的游戏,分为单玩家规划、学习、关卡生成和规则生成等多个赛道。GVG-AI推动了蒙特卡洛树搜索(MCTS)、进化算法和滚动地平线算法在游戏AI中的应用,并揭示了当前AI系统在通用性方面的显著不足——表现最好的算法在某些游戏类型上仍远逊于人类。
一个典型的VGDL描述包含四部分:精灵集(SpriteSet)定义游戏对象及其物理行为,交互集(InteractionSet)定义对象碰撞时的后果,关卡映射(LevelMapping)将字符映射为游戏对象,终止集(TerminationSet)定义胜负条件。VGDL的重要价值在于它将游戏规则从代码实现中抽象出来,形成可机器解析的符号化表达,这为因果模型编译提供了天然的输入格式。
精灵动态(Sprite Dynamics)
游戏中每个对象的运动和状态变化被建模为因果变量之间的函数关系。例如,角色的位置变化不再是黑箱操作,而是明确的因果转换。在VGDL中,精灵的行为由其类型(如MovingAvatar、Chaser、RandomNPC等)决定,每种类型对应一组确定性的状态更新规则。编译过程将这些规则逐一映射为结构方程:例如一个Chaser类型的敌人,其下一时刻的位置由当前位置和追踪目标的位置共同决定,这种依赖关系被精确编码为因果图中的有向边。
从数学形式来看,每个结构方程可以表示为 $X_i(t+1) = f_i(PA_i(t), A(t))$,其中$X_i$是变量(如精灵位置),$PA_i$是其因果父节点集合(如当前位置和追踪目标位置),$A(t)$是玩家动作。因果图中的有向边精确编码了这种父子依赖关系。这种图结构支持d-分离(d-separation)判定——通过图的拓扑结构可以读出哪些变量在给定条件下条件独立,从而识别混杂因素和中介变量。在游戏上下文中,d-分离可以回答诸如"玩家的跳跃动作是否与敌人的生成位置存在因果关联"这类问题,这对于理解游戏机制的因果结构至关重要。
交互规则(Interaction Rules)
当两个游戏对象发生碰撞或交互时,触发的后果被编码为因果路径。这确保了"如果玩家碰到怪物会发生什么"这类规则有精确的因果表达。VGDL的交互集支持丰富的交互类型,包括KillSprite(销毁对象)、ScoreChange(改变分数)、TransformTo(对象变形)、PullWithIt(拖拽移动)等。每种交互类型都有明确的前提条件和后果,编译器将其转化为条件结构方程——当且仅当两个特定类型的精灵在同一位置时,相应的因果效应才被激活。
终止条件(Termination Conditions)
游戏胜负判定逻辑被转化为因果链的终点,使得智能体能够理解"为什么游戏结束"的真实原因。典型的终止条件包括MultiSpriteCounter(某类精灵数量归零时触发)和Timeout(达到时间限制时触发),这些条件被编译为对游戏状态变量的布尔函数,其因果前驱可以沿因果图追溯到具体的玩家动作和交互事件。
每个游戏tick代表从时间t到t+1的因果转换,状态变量之间的依赖关系完全透明。从形式化角度看,这里构建的是动态结构因果模型(Dynamic SCM)。结构因果模型(SCM)是Judea Pearl因果推理框架的核心数学工具,由一组内生变量、外生变量、结构方程和噪声分布组成。结构方程明确定义了每个变量如何由其父节点(直接原因)决定,例如Y = f(X, U)表示Y由X和噪声U共同决定。动态SCM将时间维度引入这一框架,类似于动态贝叶斯网络,但具有更强的因果语义:它不仅描述变量之间的条件依赖,还精确刻画干预和反事实的效果。
本文的关键创新在于提出了确定性框架——在游戏这一完全确定性的环境中,外生噪声为零,结构方程变为纯函数映射,从而使因果模型能够完美复现游戏行为。确定性结构因果模型在因果推理理论中占据特殊地位:在Pearl的一般框架中,外生变量U代表未观测的背景因素和随机性,使得因果模型能够处理概率性现象。但在确定性系统中,所有变量之间的关系都是完全确定的函数映射,这带来了独特的理论优势——反事实查询可以通过简单的函数计算精确求解,无需进行概率推断;因果效应的识别不需要考虑未观测混杂因素;结构方程的验证可以通过穷举比对来实现。视频游戏作为完全由代码定义的系统,天然满足确定性条件(即使包含伪随机数,给定随机种子后也是确定的),这使得本文的编译方法在理论上是完备的。
绝对因果保真度的价值
与传统方法相比,这种编译式方法的最大优势在于因果保真度的绝对保证。由于直接从游戏规范转换而来,生成的因果模型与真实游戏机制保持100%一致,不存在学习误差或推断偏差。
这种保真度带来三大实际应用价值:
反事实推理:研究者可以精确回答"如果当时玩家向左而非向右移动会怎样"这类问题,因为因果路径完全可追溯。反事实推理是因果推理层级的最高层,在游戏AI中具有多重实用价值。在调试和复盘层面,开发者可以回溯某个失败场景,精确计算如果智能体在某个关键帧做出不同动作,后续状态序列会如何变化。在策略改进层面,反事实推理可以评估"后悔值"(regret),即当前策略与理论最优策略之间的差距,这是许多高级强化学习算法(如反事实后悔最小化CFR)的核心。CFR由Zinkevich等人在2007年提出,最初用于求解大规模不完全信息博弈的纳什均衡,其核心思想是在每个信息集上独立最小化反事实后悔值——即如果在该决策点选择了最优动作能够多获得多少收益。
CFR在计算博弈论中占据核心地位,其数学基础是在线学习理论中的遗憾界(regret bound)。核心定理表明:在自我博弈过程中,如果双方都使用CFR更新策略,其平均策略会以$O(1/\sqrt{T})$的速率收敛到纳什均衡,其中$T$是迭代次数。这一收敛保证使CFR成为求解大规模博弈的首选算法。该算法及其变体(如CFR+、Deep CFR)是DeepMind的Libratus和Pluribus等扑克AI的理论基础。其中Deep CFR由Brown等人在2019年提出,用深度神经网络替代了表格存储,使其能够处理连续状态空间的博弈。而CFR的有效性完全依赖于反事实值的准确计算,精确的因果模型正是实现这一计算的基础设施——在游戏AI中,精确的因果模型使CFR的反事实值计算从近似变为精确,这在理论上可以加速收敛并提高解的质量。在程序验证层面,游戏设计师可以提出假设性问题,如"如果玩家同时获得两个加速道具会怎样",反事实推理能给出精确答案而无需实际运行游戏。没有精确的因果模型,这些反事实查询都只能给出近似答案。
因果强化学习训练:智能体在训练时能够访问真实的因果结构,而非仅仅观察表面的状态-动作-奖励序列,这有助于学习更泛化的策略。传统强化学习通过试错法在马尔可夫决策过程(MDP)中学习策略,但MDP本质上只捕捉了状态转移的统计规律,无法区分因果关系与相关性。具体而言,MDP的转移概率P(s'|s,a)描述的是条件概率分布,它混合了因果效应和虚假相关——例如,如果训练数据中智能体每次在某个位置获得奖励前恰好都面朝北方,MDP会将"面朝北方"编码为高奖励状态的特征,即使朝向与奖励之间没有因果关系。本文提出的编译方法恰好解决了因果结构获取这一瓶颈,提供了自动且精确的因果结构获取途径,使智能体能够基于真实因果机制进行决策而非依赖统计捷径。在实践中,这意味着智能体可以利用因果图进行有针对性的探索(只探索因果相关的状态维度)、实现更高效的信用分配(沿因果路径回溯奖励归因),以及在环境发生分布偏移时保持策略的有效性。
程序内容验证:游戏设计师可以利用因果模型检查生成内容的合理性,例如验证某个关卡是否真的可通关,或者某种交互组合是否会产生意外后果。在程序化内容生成(Procedural Content Generation, PCG)日益普及的今天,这一能力尤为重要。PCG算法可能生成数以万计的关卡变体,人工逐一测试不现实。
当前PCG领域的质量保证(QA)面临系统性挑战。主流PCG方法包括基于约束的生成(如Wave Function Collapse算法,通过局部约束传播生成全局一致的内容)、基于搜索的生成(如进化算法优化关卡参数以满足设计目标)和基于机器学习的生成(如GAN生成关卡布局或VAE学习关卡潜空间)。这些方法面临的共同问题是生成内容的"可玩性验证"——确保生成的关卡有解、难度适当、不存在exploit(可被玩家利用的设计漏洞)。当前的验证方法主要依赖模拟运行(让AI agent试玩)或启发式约束检查,前者计算昂贵且不完备(无法穷尽所有可能策略),后者难以捕捉复杂的交互效应。因果模型提供了第三条路径:通过在因果图上进行可达性分析,可以判断从初始状态是否存在一条因果路径到达胜利终止条件;通过干预分析,可以检测某些对象组合是否会触发未预期的交互链反应,从而在关卡发布前发现设计缺陷。这种分析是符号化的,不需要实际运行游戏模拟,因而在效率上具有显著优势。
迈向可解释的游戏AI
这项研究代表了游戏AI领域的重要进展。长期以来,AI在游戏中的成功往往建立在"黑箱优化"基础上——只要赢就行,不管为什么赢。从AlphaGo到OpenAI Five,这些里程碑式的成就虽然令人瞩目,但其内部决策过程对人类而言几乎不可理解。这种不透明性在竞技场景中或许可以接受,但在需要可解释性、可迁移性和可调试性的场景中暴露出严重局限——例如在游戏测试自动化中,测试工程师需要理解AI为什么选择某条路径;在教育游戏中,AI教师需要能够解释其决策逻辑;在游戏平衡性调试中,设计师需要追溯某个策略为什么过于强势。
通过将VGDL编译为因果模型,研究者提供了一种将符号知识(游戏规则)与因果推理(为什么发生)有机结合的途径。这不仅适用于VGDL描述的简单游戏,其思路也可扩展到更复杂的游戏引擎和环境描述语言。
不过值得注意的是,从VGDL到更复杂游戏引擎的扩展面临显著挑战。VGDL描述的游戏通常是确定性的、离散时间步的、有限状态空间的2D游戏,这些特性使得向因果模型的编译相对直接。然而,现代商业游戏引擎(如Unity、Unreal Engine)涉及连续物理模拟、随机事件、并行系统交互、复杂的AI行为树等特性。连续状态空间需要对结构方程进行离散化或函数逼近;随机性意味着外生噪声不再为零,需要处理概率因果模型;并行交互可能导致因果图中出现环路,需要引入均衡概念。
此外,游戏描述语言家族近年来持续扩展,一些现代语言也可能成为未来的编译目标。PuzzleScript是由Stephen Lavelle于2013年创建的开源语言,专注于基于规则的推箱子类解谜游戏,其规则以模式匹配的形式表达(形如"如果[玩家][箱子]相邻且玩家向箱子方向移动,则箱子向同方向移动一格"),这种模式匹配天然接近因果描述中的条件结构方程。Ludii是由Maastricht大学Digital Ludeme Project开发的通用棋盘游戏描述语言,覆盖了超过1000种传统棋盘游戏,其形式化程度极高。此外,OpenAI的Procgen和MiniHack等环境虽然不是严格的描述语言,但也提供了程序化生成的游戏环境。游戏设计模式(Game Design Patterns)和Machinations框架则从更高抽象层次描述游戏经济和反馈循环。这些不同层次的形式化描述都可能成为因果模型编译的输入来源。尽管挑战显著,本文的框架提供了一个可验证的概念证明和方法论基础,其核心思想——将形式化规则描述自动转换为因果模型——在原则上是可推广的。
未来,这类方法可能成为构建真正"理解"游戏规则的AI系统的基石,而不仅仅是记忆获胜模式的模式匹配器。当AI能够推理因果关系时,它们将在面对新情境时表现出更强的适应性和创造性。更长远地看,这一研究方向与AI安全和AI对齐领域产生了有趣的交汇——如果我们能够确保AI系统基于正确的因果模型进行决策,而非依赖脆弱的统计相关性,那么AI的行为将更加可预测和可控。
具体而言,在AI安全领域,目标错误指定(goal misgeneralization)是核心挑战之一——智能体在训练环境中表现出期望行为,但在部署环境中因依赖虚假特征而追求了错误目标。2022年DeepMind团队的研究系统展示了这一现象:在CoinRun等游戏环境中,智能体学会了"走到关卡右端"而非"收集金币",因为在训练关卡中金币恰好总在最右端。因果模型可以检测这类目标错误指定——如果智能体的策略依赖的因果路径不经过奖励的真正因果前驱(金币的存在状态),就表明存在目标错误指定的风险。此外,可解释因果模型还与"机械可解释性"(mechanistic interpretability)研究产生共鸣——后者试图理解神经网络内部学到的算法和因果机制,而本文提供的因果真值模型可以作为评估网络是否学到正确因果结构的基准。游戏环境作为复杂性可控的沙盒,为验证这些理念提供了理想的试验场。
核心要点
- 核心问题:传统游戏AI依赖虚假相关性而非因果理解,导致泛化能力差、可解释性低
- 创新方案:将VGDL游戏描述直接编译为动态结构因果模型,绕过了因果结构学习的难题
- 关键突破:利用游戏环境的确定性特点,实现了100%因果保真度的模型构建
- 三大应用:精确反事实推理、因果强化学习训练、程序化内容验证
- 理论定位:将Pearl因果推理层级的最高层(反事实推理)引入游戏AI领域
- 扩展前景:框架思想可推广至PuzzleScript、Ludii等其他形式化游戏描述语言,向商业引擎扩展仍面临连续性、随机性和并行性等挑战
相关推荐
Boox Palma 3发布:新增手写笔支持与全新设计
Boox Palma 3正式发布,新增手写笔支持并采用全新简洁设计。作为口袋尺寸的黑白电子墨水屏阅读器,它在功能升级的同时价格明显上涨。本文解析Palma 3的核心变化与升级价值。
Cursor 3.0 完整入门指南:从零上手 AI 编程 IDE
Cursor 3.0 完整入门教程:从下载安装、创建项目到并行子代理、云端开发、技能与自动化等高级功能。零基础也能上手这款 AI 编程 IDE,掌握模型选择、设计模式与 Git 版本控制的实用技巧。
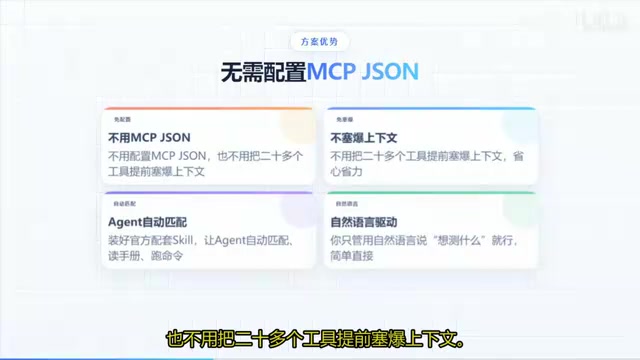
Codex+Playwright封装测试Skill:UI自动化不再手敲命令
把 Playwright 封装成 Codex Skill,让 AI Agent 通过自然语言完成 UI 自动化测试。本文详解安装加载、Sauce Demo 实战、PO 分层模板,以及 MCP 与 CLI+Skill 的选型对照。