vLLM v0.28.0发布:584次提交带来全栈推理优化
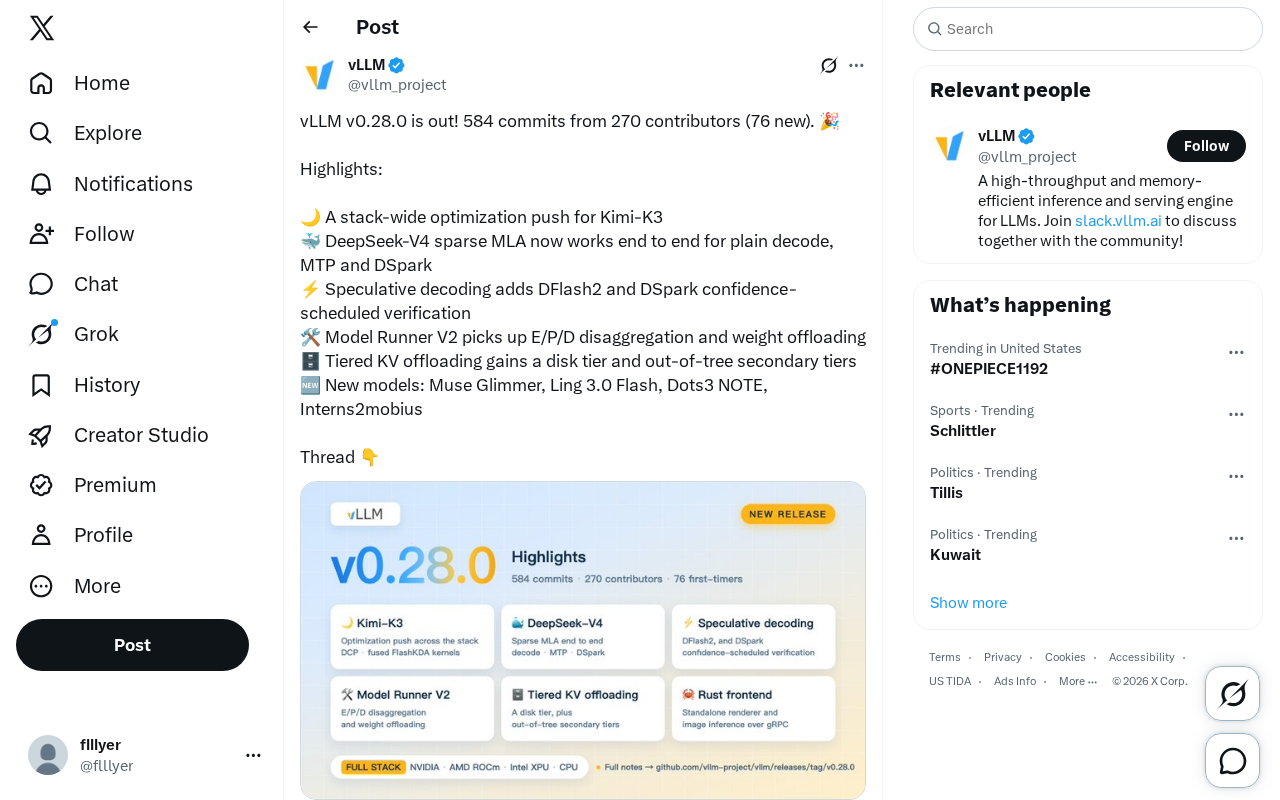
vLLM v0.28.0 以稀疏MLA落地、置信度推测解码、E/P/D分离及磁盘级KV卸载为核心,全面提升生产环境推理效率。
vLLM v0.28.0 由 270 位贡献者合并 584 次提交完成,是一次围绕推理效率的系统性升级。核心亮点包括:DeepSeek-V4 稀疏 MLA 实现端到端可用,覆盖普通解码、MTP 与 DSpark 三种场景;推测解码引入置信度调度验证,在保证输出质量的前提下减少无效验证开销;Model Runner V2 新增 E/P/D 分离部署与权重卸载能力,使 Prefill 与 Decode 阶段可独立调度到不同硬件资源;分层 KV 卸载体系新增磁盘层,并开放树外二级缓存扩展接口,为超长上下文与多轮对话场景提供更灵活的成本控制手段。此外,Muse Glimmer、Ling 3.0 Flash 等新模型被纳入支持范围。整体而言,本版本直指显存瓶颈、吞吐上限与部署成本三大生产痛点,对计划大规模部署大模型的团队具有较高的评估价值。
vLLM v0.28.0 重磅发布
作为当前最主流的大语言模型推理与服务引擎之一,vLLM 近日正式发布了 v0.28.0 版本。据官方在 Twitter 上公布的数据,本次更新累计合并了 584 次提交(commits),由 270 位贡献者共同完成,其中包含 76 位首次参与的新贡献者。这一数字不仅体现了 vLLM 项目的活跃度,也从侧面反映出开源社区在大模型推理基础设施领域的持续投入。
对于依赖 vLLM 部署大模型的开发者和企业而言,这一版本的核心价值在于其"全栈优化"(stack-wide optimization)的思路——不再是单点功能的补丁式更新,而是围绕最新一代大模型架构进行系统性的性能打磨。
面向新一代模型的深度优化
全栈优化与稀疏 MLA 支持
本次更新的一大亮点是针对 Kimi-K3 进行的全栈级优化推进。所谓全栈优化,意味着从算子调度、内存管理到推理流水线的多个层次协同改进,这通常能带来比孤立优化更显著的端到端性能提升。
话说回来,**DeepSeek-V4 的稀疏 MLA(Multi-head Latent Attention)**现已实现端到端可用。有意思的是,其支持范围覆盖了三种关键场景:
- 普通解码(plain decode):标准的自回归生成过程;
- MTP(Multi-Token Prediction):一次预测多个 token,提升生成吞吐;
- DSpark:DeepSeek 生态相关的加速机制。
稀疏注意力机制是近年来降低长上下文推理成本的重要方向,MLA 通过压缩 KV 缓存显著减少显存占用,而 vLLM 将其完整落地,意味着开发者可以更低成本地在生产环境部署这类模型。
推测解码与运行时的演进
更智能的推测解码
推测解码(Speculative Decoding)是提升大模型推理速度的关键技术,其核心思路是用一个小模型"草拟"多个候选 token,再由主模型批量验证,从而摊薄单 token 的生成成本。
v0.28.0 在这一领域引入了 DFlash2 以及 DSpark 置信度调度验证(confidence-scheduled verification)。后者尤其值得关注:传统推测解码往往对所有草拟 token 采用统一验证策略,而基于置信度调度的验证能够根据候选 token 的可信程度动态调整验证力度,理论上可以在保证输出质量的前提下进一步减少不必要的计算,提高接受率。
Model Runner V2 的能力扩展
新一代运行时 Model Runner V2 在本版本中获得了两项重要能力:
- E/P/D 分离(disaggregation):即 Encode/Prefill/Decode 阶段的解耦部署。将预填充(Prefill)与解码(Decode)分离到不同资源上运行,是当前大规模推理服务优化资源利用率的主流架构,能够有效缓解两个阶段计算特征差异带来的资源浪费。
- 权重卸载(weight offloading):允许将部分模型权重卸载到显存之外,为在有限显存条件下运行更大模型提供了可能。
分层 KV 缓存与新模型生态
磁盘层加入 KV 卸载体系
KV 缓存管理一直是 vLLM 的核心竞争力(其 PagedAttention 技术即为此而生)。本次更新中,分层 KV 卸载(Tiered KV offloading)新增了磁盘层(disk tier),并支持树外(out-of-tree)二级缓存层。
这意味着 KV 缓存不再局限于显存与主机内存,还可以进一步下沉到磁盘存储。对于超长上下文、多轮对话等 KV 缓存占用巨大的场景,这种分层设计能够在成本与性能之间提供更灵活的取舍空间,同时开放的树外扩展机制也便于企业接入自定义的存储后端。
新增模型支持
vLLM 一贯以对新模型的快速适配著称。本版本新增支持的模型包括:
- Muse Glimmer
- Ling 3.0 Flash
- Dots3 NOTE
- Interns2mobius
模型覆盖面的持续扩大,使 vLLM 能够作为统一的推理底座服务于多样化的模型生态,降低开发者在不同模型间切换的迁移成本。
总结与展望
综合来看,vLLM v0.28.0 并非一次简单的功能堆叠,而是围绕推理效率这一核心目标进行的系统性升级。从稀疏 MLA 的端到端落地、推测解码的置信度调度,到 E/P/D 分离架构与磁盘级 KV 卸载,每一项改进都直指大模型推理在生产环境中的真实痛点——显存瓶颈、吞吐上限与部署成本。
对于正在或计划将大模型投入生产的团队而言,本次更新中的分离式部署与分层缓存能力尤其值得评估。随着开源社区 270 余位贡献者的持续推动,vLLM 正在巩固其作为大模型推理事实标准的地位。建议感兴趣的读者关注官方发布说明,结合自身的模型与硬件条件测试相关新特性的实际收益。
相关推荐
Jev前沿模型问世:成本降40-400倍,速度提升20-200倍
新前沿模型Jev宣称成本降低40-400倍、速度提升20-200倍,引发Hacker News热议。本文解析其性价比卖点、效率突破的可能路径,以及如何理性看待这组惊人数字。

同款模型三大AI Agent横评:DeepSeek Harness、ZCode与Hermes谁更强
同一个GLM Flash模型、相同提示词,分别放进DeepSeek Harness、ZCode和Hermes三大AI Agent中横评对比。实测显示Agent框架差异显著,速度、代码量与最终效果各有高低,DeepSeek Harness综合表现最佳。

DeepSeek扒谱时喊"困了"?聊聊LLM思维链里的拟人化现象
B站UP主发现DeepSeek在扒谱、BPM识别任务的思维链中出现"困了""想睡觉"等拟人化表达。本文解析LLM为何会模仿疲劳、思维链如何放大拟人化现象,以及如何应对模型输出跑偏。