vLLM v0.29.0rc2发布:多模态共享内存缓存修复详解
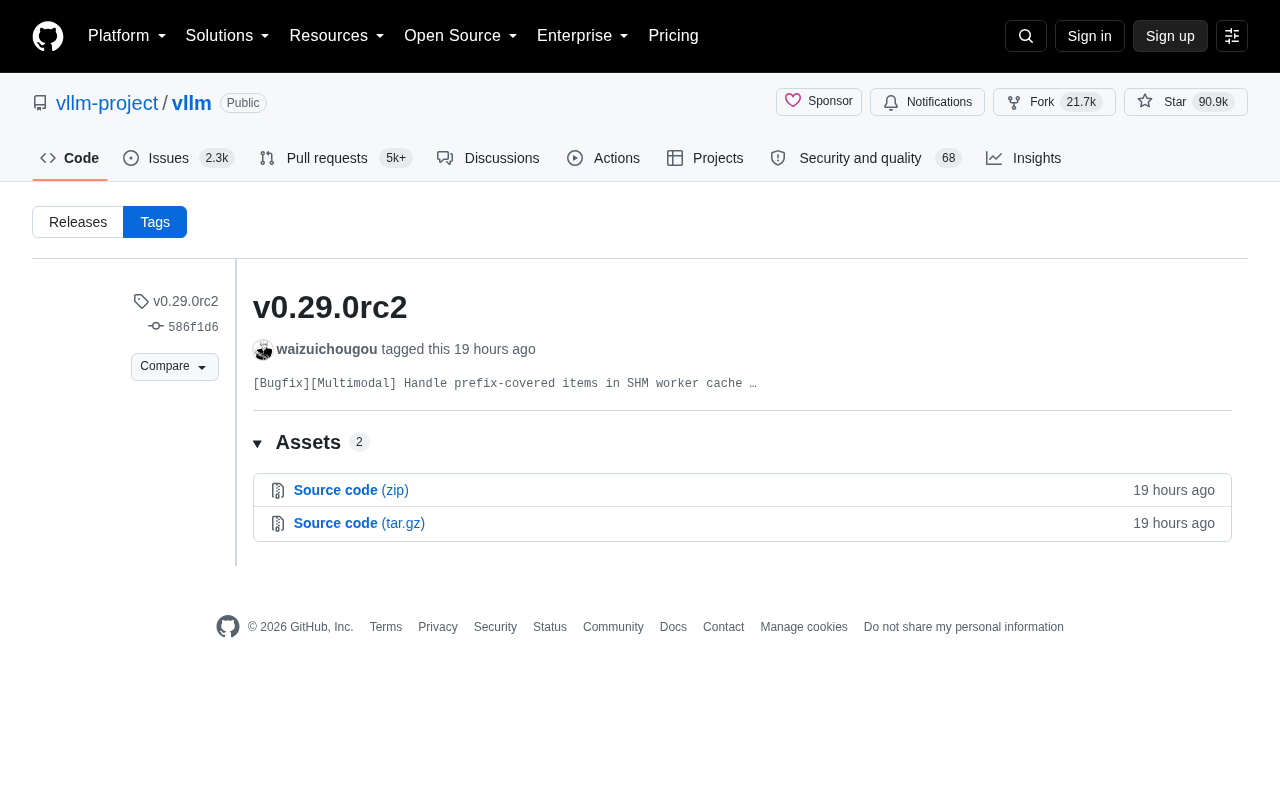
vLLM发布v0.29.0rc2,修复多模态共享内存缓存与前缀缓存交叉时的一致性缺陷。
vLLM v0.29.0rc2 是一个以单点缺陷修复为核心的候选发布版本,修复内容聚焦于多模态推理场景中共享内存(SHM)Worker 缓存与前缀缓存(Prefix Caching)机制相互作用时产生的边界问题。当图像等多模态输入的缓存项被请求前缀部分覆盖时,原有逻辑可能导致数据引用错乱或状态不一致,进而在并发场景下引发推理错误乃至服务崩溃。此次修复直击多模态生产部署的稳定性痛点,对正在使用 VLM(视觉语言模型)提供线上服务的团队具有实际价值。文章同时指出,vLLM 坚持 RC 流程和规范化提交标签的工程习惯,是其赢得社区信任、向企业级基础设施演进的重要体现。对于生产环境用户,建议在测试集群验证后等待即将到来的正式版 v0.29.0。", "paragraph": "vLLM v0.29.0rc2 是一个以单点缺陷修复为核心的候选发布版本,修复内容聚焦于多模态推理场景中共享内存(SHM)Worker 缓存与前缀缓存(Prefix Caching)机制相互作用时产生的边界问题。当图像等多模态输入的缓存项被请求前缀覆盖时,原有逻辑可能导致数据引用错乱,进而在并发场景下引发推理错误乃至服务崩溃。此次修复直击多模态生产部署的稳定性痛点,对正在使用视觉语言模型提供线上服务的团队具有实际价值。vLLM 坚持 RC 流程与规范化提交标签的工程习惯,体现了其向企业级基础设施演进的成熟度。生产环境用户建议在测试集群验证后等待正式版 v0.29.0 发布。
vLLM持续迭代:v0.29.0rc2候选版本发布
作为当前最受欢迎的大语言模型推理与服务框架之一,vLLM 项目近日发布了 v0.29.0rc2 版本。这是一个候选发布版本(Release Candidate),意味着该版本已进入正式发布前的最后测试阶段,主要用于收集社区反馈、验证稳定性,为最终的正式版本铺路。
从项目的社区热度来看,vLLM 目前在 GitHub 上已累积超过 90,900 颗星标(Star) 以及 21,700 次分叉(Fork),稳居开源推理框架第一梯队。这一数据也从侧面反映出,随着大模型部署需求的爆发式增长,围绕高效推理引擎的生态建设正变得愈发重要。
核心修复:多模态场景下的共享内存缓存问题
本次 rc2 版本的核心变更聚焦于一个具体的缺陷修复:
[Bugfix][Multimodal] Handle prefix-covered items in SHM worker cache
这条提交信息虽然简短,但透露出几个关键技术信号。
SHM Worker Cache 是什么?
SHM 即 Shared Memory(共享内存)。在 vLLM 的分布式推理架构中,多个 worker 进程需要协同处理请求。对于多模态模型(如支持图像、视频输入的视觉语言模型 VLM),输入数据往往体积庞大,如果在进程间反复拷贝,会带来显著的性能开销。
因此,vLLM 引入了基于共享内存的 worker 缓存机制,让不同进程能够高效地共享多模态数据(如图像特征、编码后的 token 等),避免重复计算和传输,从而提升整体吞吐量。
prefix-covered items 指的是什么
本次修复所针对的 "prefix-covered items"(前缀覆盖项),指向的是缓存复用中的边界情况。在实际推理中,vLLM 依赖 Prefix Caching(前缀缓存) 技术来复用相同前缀请求的 KV Cache,这是提升多轮对话、批量相似请求处理效率的关键优化。
当多模态内容与前缀缓存机制交叉时,可能出现缓存项被前缀部分覆盖、导致数据引用错乱或状态不一致的情况。此次 Bugfix 正是为了正确处理这类被前缀覆盖的缓存项,避免多模态推理在特定并发场景下产生错误或崩溃。
这个修复为什么值得关注
多模态推理正成为主战场
随着 GPT-4o、Qwen-VL、LLaVA 等多模态模型的普及,推理框架对图像、视频等非文本输入的支持能力日益成为竞争焦点。相比纯文本推理,多模态场景在内存管理、数据传输、缓存一致性上有着更高的复杂度。
vLLM 在这一版本中针对多模态与共享内存缓存的协同问题进行修复,说明项目正在持续打磨其在生产级多模态部署中的稳定性。对于正在或计划将 VLM 投入线上服务的团队而言,这类边界情况的修复往往比新特性更具实际价值——因为它直接关系到服务的可靠性。
RC 版本的正确使用方式
需要提醒的是,rc2 属于候选发布版本,并非最终稳定版。对于生产环境用户,建议:
- 测试环境优先验证:在灰度或测试集群中评估该版本对现有工作负载的影响,尤其是涉及多模态和前缀缓存的场景;
- 关注后续正式版:rc 版本通常会在短期内收敛为正式的 v0.29.0,生产部署可等待稳定版发布;
- 回归测试关键路径:由于本次修复触及缓存一致性逻辑,升级后应重点验证缓存命中率与推理正确性。
从版本节奏看 vLLM 的工程实践
从 v0.29.0rc2 这样的命名可以看出,vLLM 采用了相对规范的候选版本发布流程:先发布多个 rc 版本进行充分验证,再冻结为正式版。这种做法在快速迭代的 AI 基础设施项目中并不总是被严格执行——许多项目为追求速度直接发布主版本,容易将不稳定因素带入生产。
vLLM 坚持 rc 流程,配合每次提交清晰的分类标签(如 [Bugfix]、[Multimodal]),体现了其向企业级、生产级基础设施演进的工程成熟度。这也是它能够赢得广泛社区信任、维持高活跃度的重要原因之一。
小结
vLLM v0.29.0rc2 虽然是一个以单点 Bugfix 为主的候选版本,但其修复的多模态共享内存缓存问题,恰恰命中了当下大模型部署的核心痛点——多模态推理的稳定性与效率。
对于关注推理性能与生产可靠性的开发者和团队来说,持续跟踪 vLLM 的版本演进,理解这些看似细微的修复背后的技术逻辑,有助于更好地把握高性能推理框架的发展方向。建议密切留意即将到来的 v0.29.0 正式版本,以获得经过完整验证的稳定能力。
相关推荐
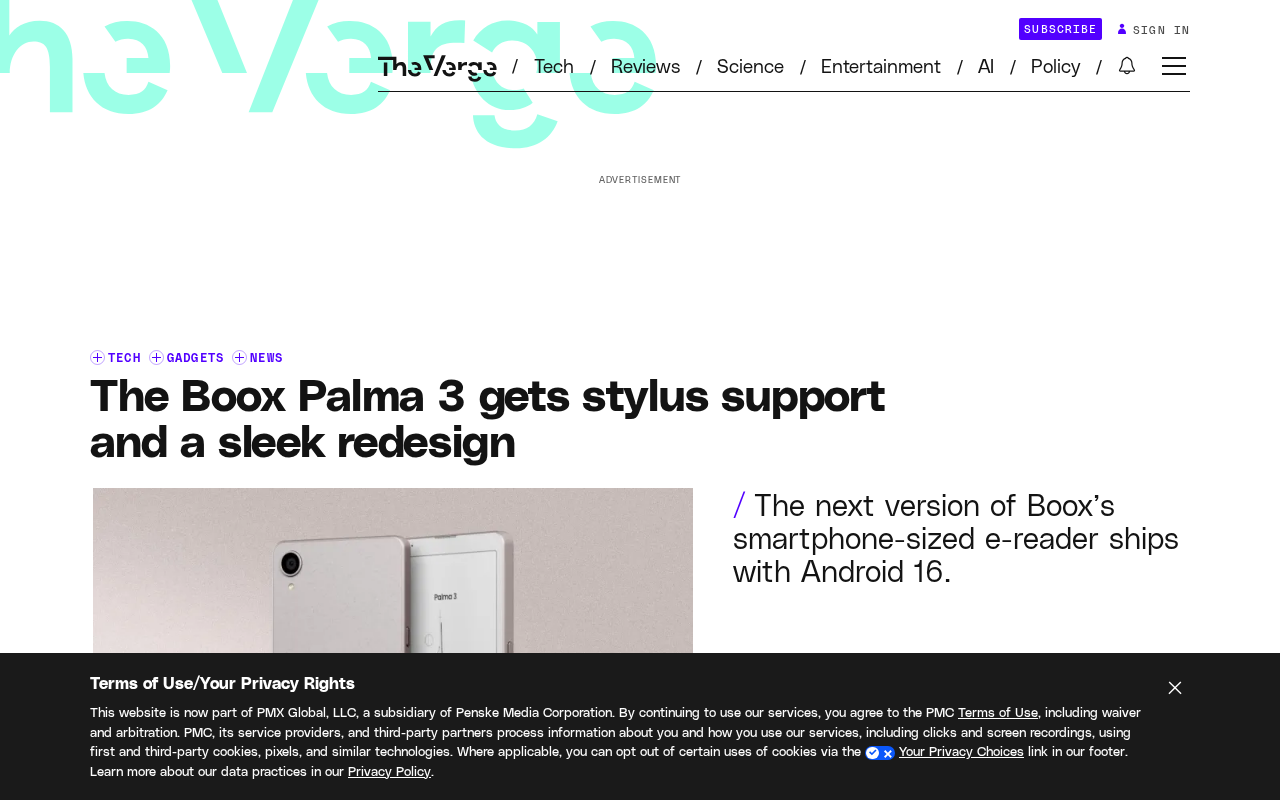
Boox Palma 3发布:新增手写笔支持与全新设计
Boox Palma 3正式发布,新增手写笔支持并采用全新简洁设计。作为口袋尺寸的黑白电子墨水屏阅读器,它在功能升级的同时价格明显上涨。本文解析Palma 3的核心变化与升级价值。
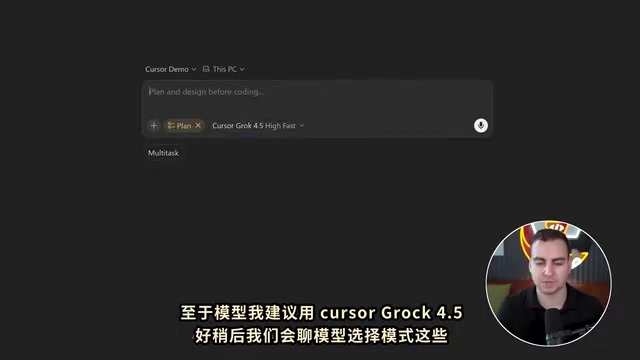
Cursor 3.0 完整入门指南:从零上手 AI 编程 IDE
Cursor 3.0 完整入门教程:从下载安装、创建项目到并行子代理、云端开发、技能与自动化等高级功能。零基础也能上手这款 AI 编程 IDE,掌握模型选择、设计模式与 Git 版本控制的实用技巧。
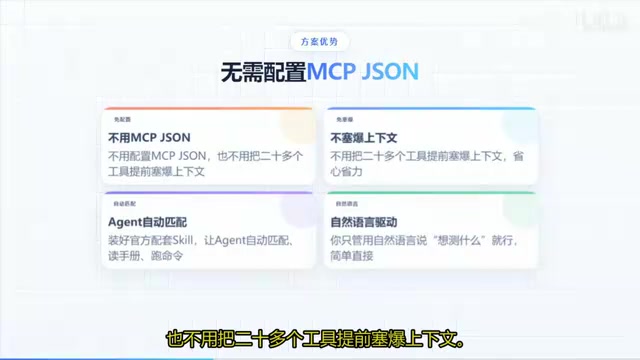
Codex+Playwright封装测试Skill:UI自动化不再手敲命令
把 Playwright 封装成 Codex Skill,让 AI Agent 通过自然语言完成 UI 自动化测试。本文详解安装加载、Sauce Demo 实战、PO 分层模板,以及 MCP 与 CLI+Skill 的选型对照。