vLLM v0.31.1rc0发布:按缓存层级暴露缓存Prompt Token指标

vLLM v0.31.1rc0 新增按缓存层级统计命中 prompt token 的细粒度指标,助力推理成本优化与性能监控。
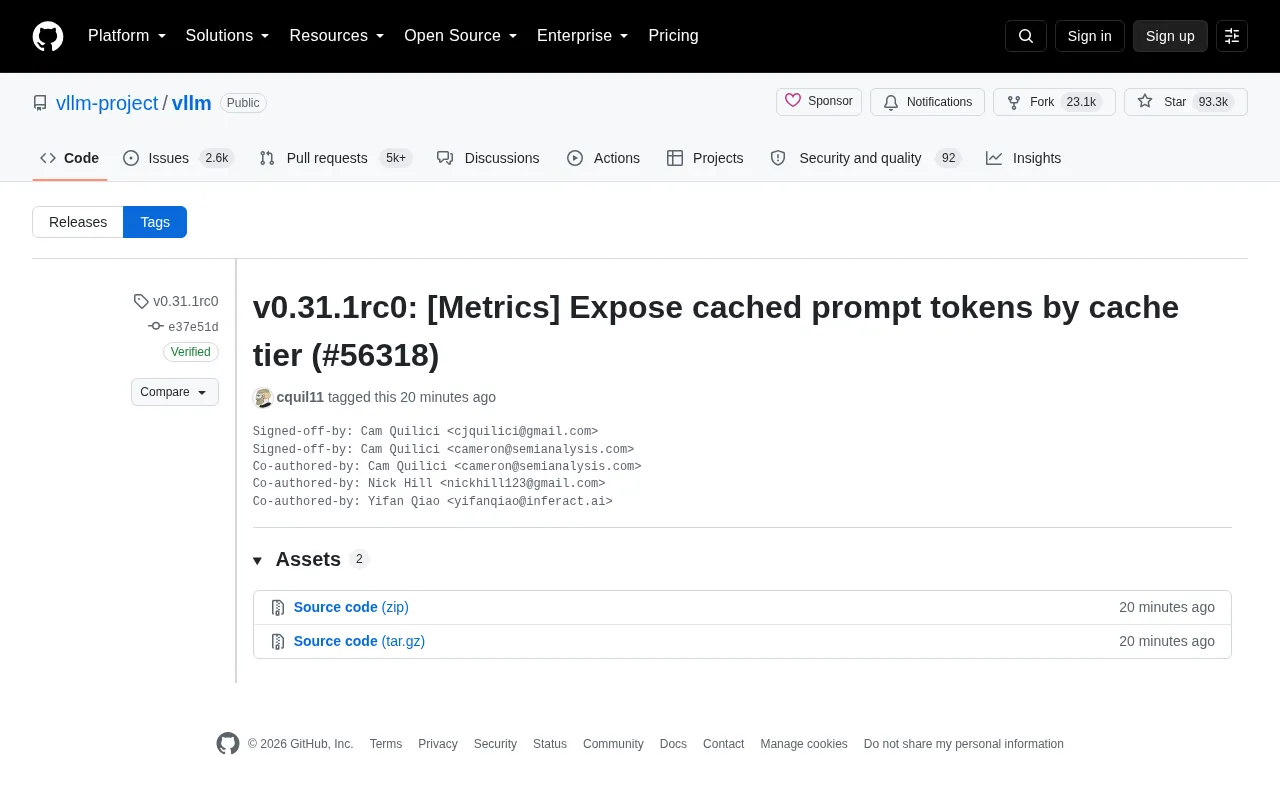
vLLM v0.31.1rc0 候选版本的核心变化是在指标系统中新增了按缓存层级(cache tier)暴露缓存 prompt token 命中数量的能力(PR #56318)。现代推理系统的 KV Cache 通常是分层的,GPU 显存、CPU 内存等不同层级的命中带来的性能收益和成本差异悬殊。此前的指标体系只能看到整体缓存命中情况,新功能使工程师能够精确区分高速与低速缓存的命中量,从而更准确地评估分层缓存策略是否合理、推理成本是否可优化。这类指标通过 Prometheus 端点暴露,可直接接入 Grafana 监控体系。该版本为 rc0 候选版本,建议先在测试环境验证后再考虑生产升级。
vLLM 作为当下最热门的大语言模型推理引擎之一,近日发布了 v0.31.1rc0 候选版本。本次更新的核心变化是在指标(Metrics)系统中新增了按缓存层级(cache tier)暴露缓存 prompt token 的能力(PR #56318),这对关注推理成本与性能监控的工程团队具有实际意义。
本次更新的核心变化
这个候选版本的主要亮点集中在可观测性(Observability)层面。新增功能允许 vLLM 按照不同的缓存层级,分别统计并暴露被命中的缓存 prompt token 数量。
在实际的推理服务中,Prefix Caching(前缀缓存)是提升吞吐、降低延迟的关键机制。当多个请求共享相同的系统提示词或上下文前缀时,这部分 token 的计算结果可以被缓存复用,从而避免重复计算。此前的指标体系往往只能看到整体的缓存命中情况,而无法区分缓存命中究竟发生在哪一层。
为什么要区分缓存层级
现代推理系统的缓存通常是分层的——例如 GPU 显存中的高速缓存层,与 CPU 内存或更慢的存储介质构成的二级缓存层。不同层级的命中带来的性能收益和成本差异巨大:命中显存缓存几乎零成本,而从较慢层级加载则需要额外的数据搬运开销。
将缓存 prompt token 按层级拆分暴露后,运维与性能工程师能够更精确地回答几个关键问题:有多少 token 真正享受到了高速缓存加速?缓存的分层策略是否合理?是否存在大量请求只命中了低速缓存从而拖累整体表现?这些细粒度数据是优化缓存配置和评估降本效果的基础。
vLLM 中的分层缓存体系通常称为 Tiered KV Cache。KV Cache(Key-Value Cache)是 Transformer 推理的基础优化——模型在处理每个 token 时产生的 Key 和 Value 矩阵可以被保存下来,避免后续步骤重复计算。Prefix Caching 则在此基础上更进一步:将多个请求共享的前缀部分的 KV 结果持久化,跨请求复用。
在 vLLM 的实际部署中,这套缓存可以跨越多个存储层级:第一层是 GPU HBM(高带宽显存),访问延迟最低,但容量有限且成本最高;第二层可以是 CPU DRAM,容量更大但访问需要经过 PCIe 总线,延迟显著增加;更长远的方案还包括 NVMe SSD 或远程分布式缓存。不同层级之间的带宽差距往往达到一个数量级以上,因此"命中了缓存"这一笼统描述掩盖了实际的性能差异——命中 GPU 显存缓存与命中 CPU 内存缓存,对请求延迟的影响可能相差数倍。
对推理服务监控的意义
对于大规模部署 vLLM 的团队来说,指标的颗粒度直接决定了优化空间的可见性。
缓存 prompt token 的命中率往往与推理成本直接挂钩。在按 token 计费的服务场景中,缓存命中的 token 意味着更低的实际计算量。能够按层级统计这些数据,有助于团队建立更精细的成本模型,并据此调整缓存容量分配、请求调度和前缀复用策略。
从监控角度看,这类指标通常会通过 Prometheus 等标准接口暴露,方便接入现有的 Grafana 看板和告警系统。工程团队无需额外改造即可将缓存分层数据纳入日常的 SLO 观测体系。
Prometheus 是云原生领域最主流的时序指标采集系统,采用拉取(pull)模式定期从服务端点抓取指标数据,并以标签(label)维度支持多维聚合查询。vLLM 内置了 /metrics HTTP 端点,以 Prometheus 文本格式暴露运行时指标,涵盖吞吐量、队列长度、Token 生成速度等维度。新增的缓存层级指标同样通过这一端点输出,用户可以通过为不同缓存层级添加对应的 label(如 cache_tier="gpu" 或 cache_tier="cpu")来区分各层命中量,并在 Grafana 中通过 PromQL 查询语句直接绘制分层命中率趋势图,无需修改任何现有采集配置。
关于候选版本(rc)的说明
需要留意的是,v0.31.1rc0 中的 rc0 标识其为发布候选版本(Release Candidate)。这意味着它主要面向希望提前验证新特性、进行兼容性测试的用户,而非生产环境的稳定发布版。
该版本在 GitHub 上由贡献者 Cam Quilici 发起,并经过多位协作者共同完成,commit 带有 GitHub 的 verified 验证签名。参与者来自 SemiAnalysis、Inferact 等机构背景,反映出 vLLM 社区活跃的跨组织协作生态。
对于生产用户,建议在正式稳定版发布前,先在测试环境中评估该指标功能是否满足自身监控需求,再决定升级节奏。
小结
vLLM 持续在推理引擎的可观测性上加码。本次按缓存层级暴露缓存 prompt token 的改动虽然是一个相对聚焦的功能点,却直击大规模推理部署中成本优化与性能调优的实际痛点。随着 LLM 推理服务规模不断扩大,这类精细化指标正变得越来越重要。
相关推荐

Reddit帖子被删引发AI内容审核争议
Reddit一则帖子被平台以违反内容政策为由删除,页面仅显示移除提示。事件折射出AI内容审核系统在透明度、误判风险和申诉机制方面的普遍困境,值得内容平台与创作者关注。

DSH+Ollama本地部署大模型实战:免费对话大肥鱼
B站UP主实测DSH+Ollama本地部署大模型全流程:从Ollama安装、迅雷加速下载、魔搭GGUF模型导入,到DSH自定义API地址配置,并对比千问3.5 4B、8B、Gemma等模型在8G显存下的表现,给出本地部署与API调用的选择建议。

899元Mac Mini实测:能替代200美元AI订阅吗?
实测M4 Mac mini能否替代200美元AI订阅:16GB内存装不下大模型,速度与质量均有差距,但隐私、无上限和近零运行成本让它成为常驻智能体的理想宿主。附各配置选购建议与省钱策略。