vLLM 硬件无关模型架构:性能与兼容性的取舍
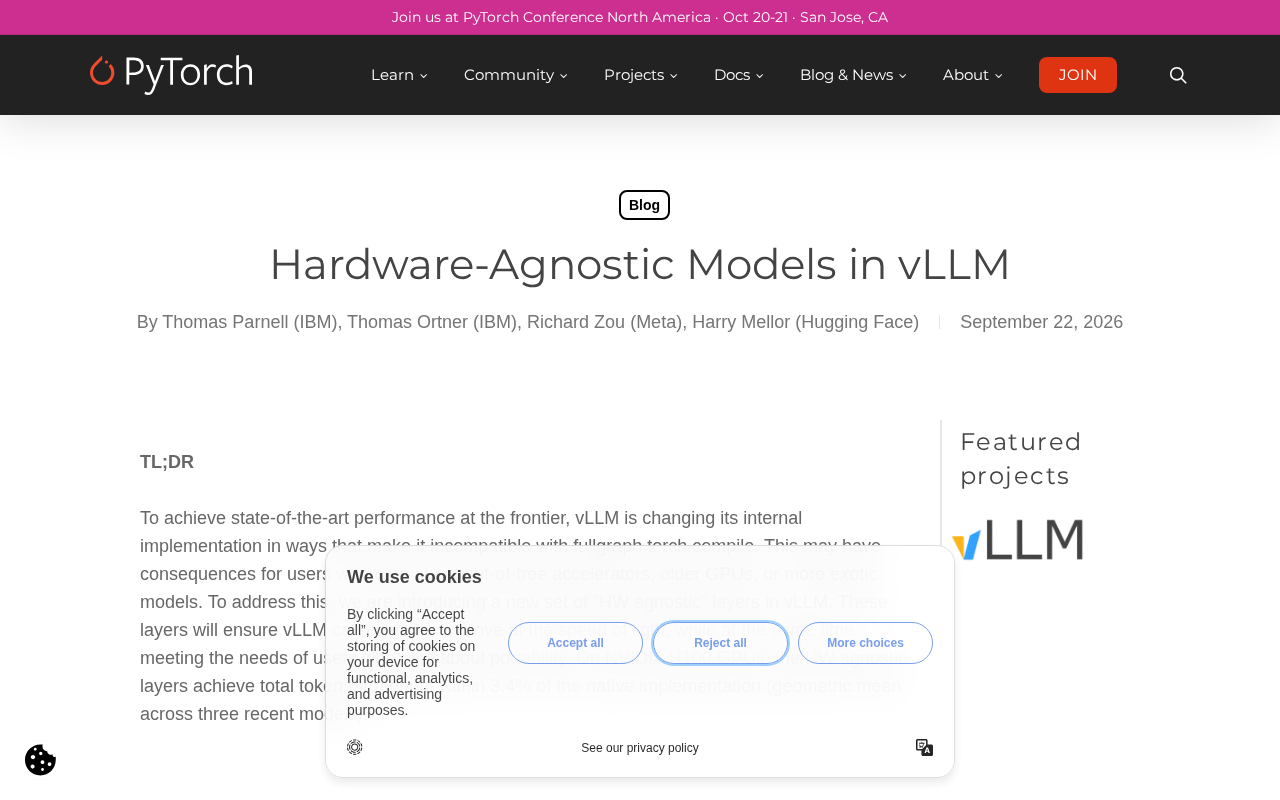
vLLM为突破性能天花板,放弃fullgraph torch.compile兼容性,转向硬件无关架构
vLLM正在对内部实现进行关键性架构调整:为追求前沿推理场景下的最优性能,官方明确宣布将不再与fullgraph模式的torch.compile保持兼容。这一决策源于fullgraph编译对代码结构的严格约束,与vLLM在极致性能优化中所需的动态逻辑、自定义硬件内核之间存在根本矛盾。新的方向是向"硬件无关模型"架构演进,增强对多种硬件后端的可移植性,将优化主动权更多掌握在框架自身而非编译器手中。对用户而言,依赖fullgraph编译的自定义部署需重新评估配置,而追求极致吞吐的生产环境长期将受益,非主流硬件适配者则迎来利好。这次调整折射出深度学习基础设施领域"编译器通用抽象"与"手工极致性能"之间长期存在的经典博弈。
vLLM 的架构转向
vLLM 作为当前最流行的大语言模型推理引擎之一,正在对其内部实现进行一次关键性调整。官方在最新博文中给出了明确的 TL;DR:为了在前沿场景中实现最先进(state-of-the-art)的推理性能,vLLM 正在改变其内部实现方式,而这种改变将使其与 fullgraph 模式下的 torch.compile 不再兼容。
这一调整看似技术细节,实则触及了推理框架设计中一个长期存在的核心矛盾——极致性能与工程通用性之间的平衡。对于依赖 vLLM 部署生产环境的团队而言,理解这一变化背后的逻辑,比单纯知道"不兼容"这个结论更为重要。
为什么要放弃 fullgraph torch.compile
torch.compile 是 PyTorch 2.0 引入的编译加速能力,其中 fullgraph 模式会将整个模型计算图作为一个完整单元进行捕获和优化。理论上,fullgraph 能够带来最彻底的图级优化,减少 Python 层的开销,让计算更接近硬件的理论峰值。
然而,fullgraph 模式对代码结构有严格约束——它要求模型前向过程中不能出现无法被图捕获的控制流、动态分支或某些依赖运行时状态的操作。而当 vLLM 要在"前沿"场景中榨取最后一点性能时,往往需要引入更灵活、更贴近具体硬件特性的实现路径。这些实现方式很可能包含 fullgraph 无法优雅处理的动态逻辑。
换句话说,vLLM 团队在做一个权衡取舍:与其被 fullgraph 的约束绑住手脚,不如放开限制以换取更高的天花板。这也解释了标题中"Hardware-Agnostic Models"(硬件无关模型)的含义——目标是让模型实现能够适配更广泛的硬件后端,而不被单一编译路径所限制。
torch.compile 底层依赖 TorchDynamo 字节码拦截机制与 TorchInductor 代码生成后端。在 fullgraph 模式下,Dynamo 会尝试将整个模型前向传播编译成一张静态计算图,再交由 Inductor 生成针对目标硬件的优化内核(如 CUDA triton kernel)。这一流程的优势在于可以跨算子做全局融合,消除 Python GIL 带来的调度开销。但其代价是对"图可捕获性"(graph-capturable)的严格要求:任何依赖 Python 动态控制流(如根据序列长度动态决定走哪条分支)、或调用外部 C++ 扩展而未做 FakeTensor 注册的操作,都会导致 graph break,使 fullgraph 编译直接失败。vLLM 中常见的 PagedAttention 内存管理、动态批处理调度、以及针对不同硬件的 custom CUDA kernel 调用,恰好都属于此类难以被 fullgraph 捕获的操作,这是两者产生根本性张力的原因。
对使用者意味着什么
官方在博文中明确提示,这一变化"可能对用户产生影响"(may have consequences for users who...)。虽然原文在此处并未完整展开,但从技术推理可以预判几类受影响的场景:
依赖 fullgraph 编译的自定义部署
如果你的部署流程中显式启用了 fullgraph 模式的 torch.compile,或者你的工具链假设整个模型是一个可捕获的完整图,那么升级到新版 vLLM 后可能会遇到编译失败或行为变化。这类用户需要重新评估自己的编译配置。
硬件适配层的开发者
"硬件无关"这个方向对于希望将 vLLM 移植到非主流加速器(如各类国产 AI 芯片、TPU 或其他定制硬件)的开发者而言,实际上是一个利好。放弃对单一编译路径的强依赖,意味着框架在不同硬件后端上的可移植性会更强。
"硬件无关"(Hardware-Agnostic)架构在实现层面通常意味着框架会抽象出一套与具体加速器解耦的算子接口层(类似 PyTorch 的 DispatchKey 机制或 JAX 的 XLA 后端抽象),让不同硬件厂商只需实现该接口即可接入,而无需修改上层模型逻辑。对于国内 AI 芯片厂商(如华为昇腾、寒武纪 MLU、燧原等)以及 Google TPU 的适配团队而言,过去基于 fullgraph torch.compile 的路径意味着必须完整支持 TorchInductor 的代码生成目标,门槛较高。转向硬件无关架构后,这些后端只需对接 vLLM 自身的算子抽象层,适配成本理论上会显著降低,这也是为什么该变化在硬件生态多元化的当下具有较强的战略意义。
追求极致吞吐的生产环境
对于运行在主流 GPU 上、且核心诉求是最大吞吐和最低延迟的团队,这次架构调整的方向是正向的——它旨在提升前沿模型的推理性能。短期内可能需要适配,长期看则是性能收益。
性能与通用性的经典博弈
这次调整折射出深度学习基础设施领域一个反复出现的主题:编译器优化的通用抽象,与手工优化的极致性能,二者难以兼得。
torch.compile 代表的是一种"自动化、通用化"的优化哲学,它希望开发者用标准的 PyTorch 代码即可获得接近手工优化的性能。这在大多数场景下工作得很好。但在推理引擎这种对性能极度敏感、且需要频繁引入新硬件特性和新模型结构的领域,通用编译路径的约束有时反而成为瓶颈。
vLLM 选择向"硬件无关"架构演进,本质上是把优化的主动权更多地掌握在框架自身手里,而不是完全交给编译器。这种设计决策在追求前沿性能的项目中并不罕见,但代价是与某些标准工具链的兼容性会有所削弱。
结语
vLLM 这次向硬件无关模型的架构转向,是一次典型的"以兼容性换性能上限"的工程决策。对于大多数普通用户,影响可能有限;但对于深度定制部署、或依赖 fullgraph 编译的团队,则需要提前关注官方文档、评估升级路径。
随着大模型推理需求持续爆发、硬件生态日益多元,推理引擎在"通用抽象"与"极致性能"之间的取舍还将继续。vLLM 的这一步,或许正是这个行业方向性变化的一个缩影。建议相关用户密切关注 vLLM 官方后续的迁移指南与详细说明。
相关推荐
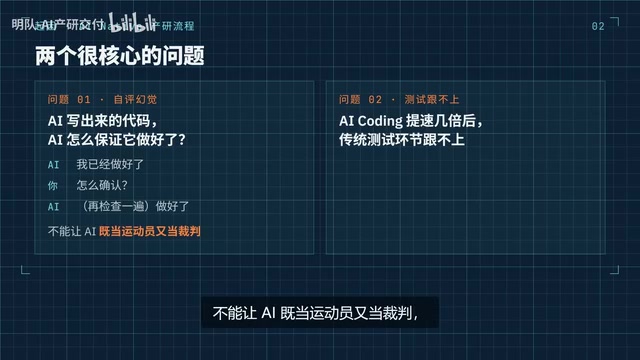
开源QA Agent实测:用测试工作流终结AI幻觉与测试瓶颈
B站UP主明队开源QA Agent,一套由8个Skill组成的端到端测试工作流,专治AI自评幻觉与AI Coding提速后的测试瓶颈。本文解析其风险分析、用例库沉淀机制及适用边界。
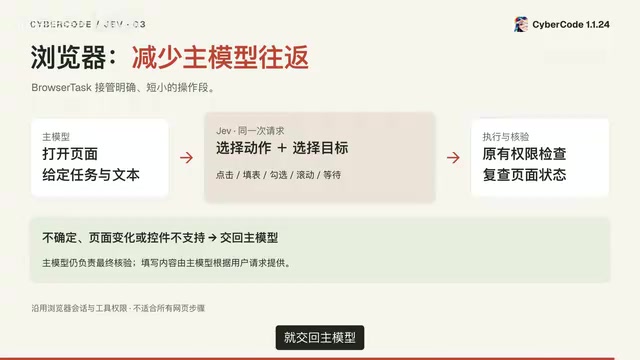
国产开源Agent CyberCode接入JEF:编码+浏览器自动化提速实测
国产开源智能体 CyberCode 1.1.24 版本接入 JEF 快速判断器,通过上下文智能裁剪和浏览器自动化减少延迟。本文详解编码与浏览器提速原理、配置步骤及真实收益条件。
Hermes AI员工搭建全指南:从Claude Code部署到自动运营社媒
手把手教你搭建 Hermes AI 智能体:从 Claude Code 部署、Hetzner 服务器配置,到 Composio 工具集成、Unipile 社交私信自动回复,实现 35 个定时任务全天候运行的 AI 员工。