vLLM携手XGrammar:DeepSeek-v4.1工具调用能力优化解析

vLLM联合XGrammar,通过约束解码技术为DeepSeek-v4.1实现可靠且高性能的工具调用支持。
vLLM团队近日公开致谢XGrammar,双方合作解决了在vLLM上部署DeepSeek-v4.1时工具调用的可靠性与性能问题。工具调用要求模型稳定输出符合JSON schema的结构化内容,这依赖约束解码技术在推理阶段对合法token进行筛选。XGrammar专注于高效结构化生成,能够在保证输出格式合法的同时将性能开销降到最低。此次整合意味着开发者可以直接基于成熟的开源推理栈构建具备函数调用能力的智能体应用,无需自行处理底层约束解码逻辑,降低了生产级部署的门槛。这一协作折射出推理框架与结构化生成引擎深度整合的行业趋势。
事件概览
近日,vLLM团队公开致谢XGrammar团队,双方就在vLLM上部署DeepSeek广告-v4.1时实现**可靠且高性能的工具调用(tool calling)**展开了合作。这条简短的社交媒体消息背后,反映出大模型推理服务栈正在向结构化输出与函数调用能力持续演进的趋势。
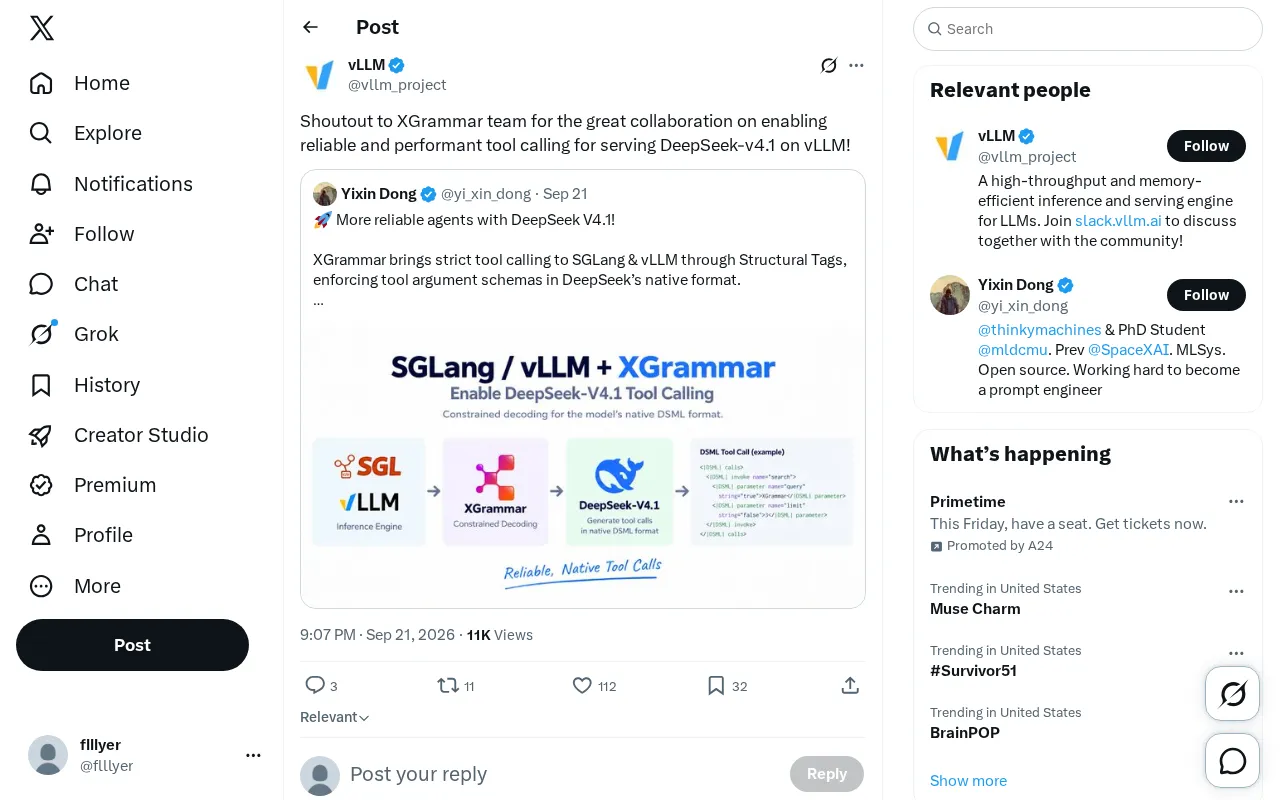
对于关注大模型工程化落地的开发者而言,这一协作值得关注:它意味着开源推理框架在支持复杂智能体(Agent)场景所需的工具调用时,性能和稳定性都得到了进一步强化。
什么是工具调用与结构化生成
工具调用(tool calling / function calling)是现代大语言模型进入实际应用的关键能力。它允许模型在推理过程中输出符合特定 schema 的结构化结果(通常是 JSON),从而调用外部函数、API 或工具,完成检索、计算、执行等超出纯文本生成的任务。
要让模型稳定输出合法的结构化内容,通常需要**约束解码(constrained decoding)**技术。这正是XGrammar所擅长的领域——它是一个专注于结构化生成的高效引擎,通过在解码阶段对输出 token 施加语法约束,确保生成结果始终符合预定义的格式规范,避免出现无法解析的非法输出。
约束解码的实现原理通常基于有限状态机(FSM)或上下文无关文法(CFG)。在每个解码步骤中,引擎会根据当前已生成的内容和目标 schema,计算出一个合法 token 的掩码(mask),只允许模型从合法候选中采样。这样无论模型的概率分布如何,最终输出都能满足格式要求。XGrammar 的创新之处在于将部分掩码计算提前到 CPU 上异步完成,并对常见 JSON 结构进行缓存,从而在 GPU 执行解码时几乎不引入额外等待,解决了早期约束解码方案吞吐损耗较大的痛点。
XGrammar 与 vLLM 的协作价值
vLLM 是当前最流行的开源大模型推理与服务框架之一,以其 PagedAttention 等高性能特性著称。而工具调用场景对推理引擎提出了两个核心诉求:
可靠性
模型输出必须严格符合工具调用所需的 JSON schema,任何格式错误都会导致下游解析失败。通过集成 XGrammar 的语法约束能力,vLLM 能够保证 DeepSeek-v4.1 在生成工具调用时输出结构合法,显著降低出错率。
JSON schema 合规性验证在工具调用链路中尤为关键。一个典型的工具调用请求会包含 name(函数名)、arguments(参数字典)等固定字段,参数值还可能嵌套枚举、数字范围等约束。若模型自由生成,即使只有一个多余的逗号或缺失的引号,都会导致 json.loads() 抛出异常,进而触发整个 Agent 流程的错误处理分支甚至崩溃。在高并发推理服务中,这类低概率但真实存在的格式错误会随请求量放大,成为影响服务可用性的长尾问题。
性能
约束解码若实现不当,会引入额外延迟,拖累整体吞吐。XGrammar 的设计目标之一就是在保证约束正确性的同时,将性能开销降到最低。此次协作强调了 "performant"(高性能),说明双方在工程层面对约束解码的速度进行了针对性优化。
对 DeepSeek-v4.1 部署的意义
DeepSeek 系列模型在开源社区拥有广泛影响力,而 DeepSeek-v4.1 能够在 vLLM 上获得可靠的工具调用支持,意味着基于该模型构建智能体应用的门槛进一步降低。开发者可以直接利用成熟的开源栈,部署具备函数调用能力的服务,而无需自行处理复杂的约束解码逻辑。
这类框架层面的能力增强,往往比单纯的模型能力提升更能加速产业落地,因为它直接改善了生产环境中的稳定性与可维护性。
DeepSeek-v4.1 是一个采用混合专家(MoE)架构的大规模模型,其激活参数量远小于总参数量,推理效率较同量级稠密模型更高。然而 MoE 模型在 vLLM 等批处理推理框架中的调度本身已有一定复杂性,叠加约束解码后对显存管理和 batch 动态性的要求更高。此次 vLLM 与 XGrammar 的协作能够覆盖这一模型,说明双方的集成方案具备一定的架构通用性,而不仅限于标准稠密 Transformer 的工具调用场景。
小结
尽管这只是一条简短的致谢消息,但它折射出开源推理生态的一个重要方向:推理框架与结构化生成引擎的深度整合。vLLM 与 XGrammar 的合作,让 DeepSeek-v4.1 的工具调用兼具可靠性与性能,为构建生产级智能体应用提供了更坚实的基础设施支撑。
注:本文基于单一社交媒体来源整理,具体技术细节与性能数据有待官方进一步披露。
相关推荐

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

Mistral Large 4开源权重发布:1万亿参数,激活49亿
Mistral Large 4开源权重发布:约1万亿参数、激活约49亿,支持图文与百万级上下文。解析厂商自测的编码与网络安全数据、修改版宽松许可、数据中心级硬件门槛,以及权重公开后不可回收的安全风险。

AgentScope 2.0实战:Java企业级AI Agent开发指南
AgentScope 2.0是阿里巴巴推出的Java企业级分布式智能体框架。本文解析它为何适合服务端AI应用,对比客户端AI应用在权限、状态管理、并发上的差异,并梳理从环境配置到项目联调的实战学习路线。