微软炮轰对手Anthropic:或对人类造成灾难性影响
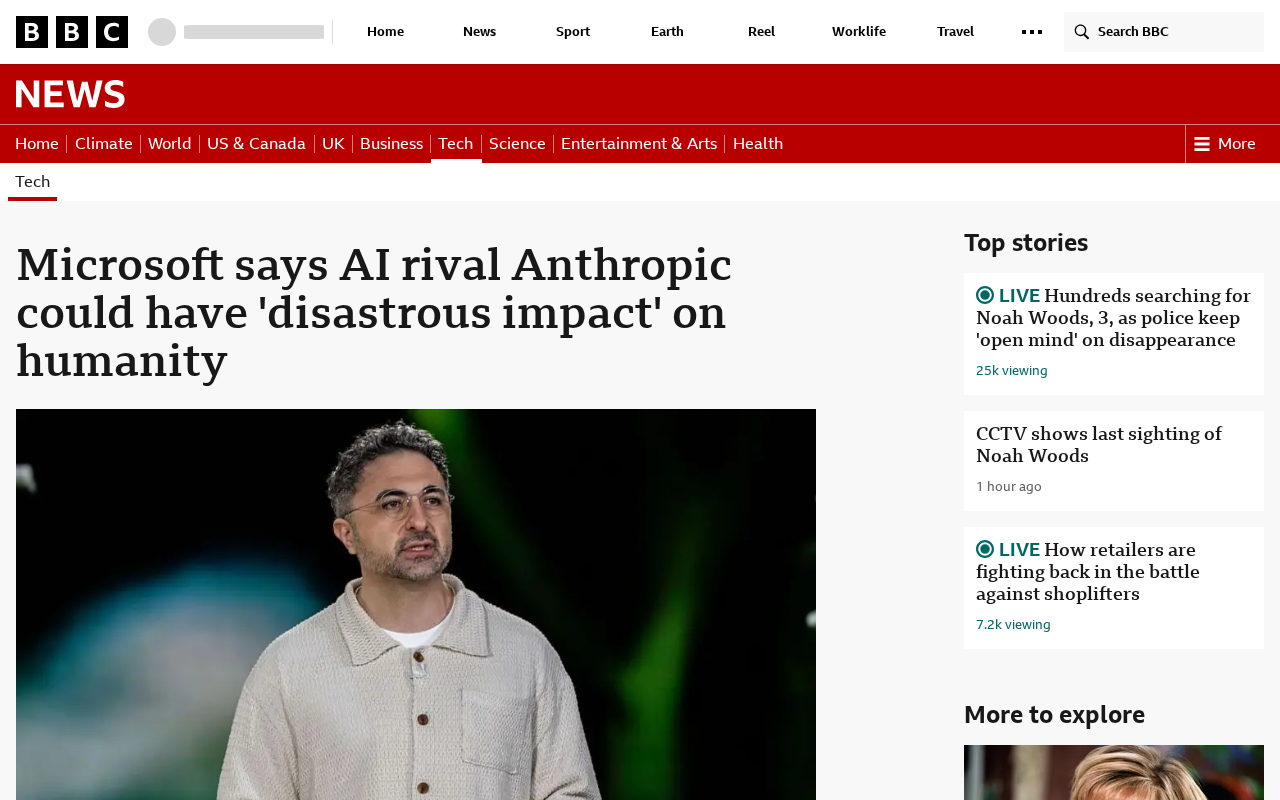
微软以"灾难性影响"指控Anthropic,揭示AI安全话语正成为巨头间的竞争武器。
微软近期公开指责AI竞争对手Anthropic可能对人类造成"灾难性影响",此举因针对的恰恰是以"安全优先"为品牌核心的Anthropic而格外引人注目。Anthropic由前OpenAI高管创立,获亚马逊、谷歌重磅投资,是OpenAI阵营之外最重要的挑战者;微软则深度绑定OpenAI,双方在云服务和企业市场直接对垒。这一事件折射出AI行业的深层矛盾:在缺乏统一、可验证安全评估标准的背景下,"AI安全"正从技术伦理议题演变为企业相互施压、争夺监管话语权的工具。"灾难性影响"等高强度词汇的滥用,可能反而稀释公众对真实技术风险的警觉。该事件目前社区讨论度有限,但其揭示的AI巨头竞争新维度值得持续关注。
微软与Anthropic的口水战升级
微软近期公开对AI竞争对手Anthropic发出严厉警告,声称后者的AI发展路线可能对人类产生"灾难性影响"(disastrous impact)。这一表态迅速在Hacker News等技术社区引发讨论,反映出AI巨头之间在安全叙事与商业竞争之间日益模糊的界限。
值得关注的是,Anthropic本身一直以"AI安全优先"作为品牌核心定位。这家由前OpenAI成员创立的公司,长期强调负责任的AI开发路径。微软此番以"灾难性影响"这类高强度措辞反击一家以安全为卖点的对手,本身就构成了一种耐人寻味的行业信号。
Anthropic由前OpenAI研究副总裁Dario Amodei及其姐姐Daniela Amodei等人于2021年创立,核心研究方向是"可解释性"(Interpretability)与"宪法AI"(Constitutional AI)——即通过明确的原则体系约束模型行为,而非单纯依赖人类反馈微调。公司先后获得亚马逊逾40亿美元、谷歌约3亿美元的投资,并推出旗舰模型Claude系列。其品牌定位从成立之初便将"安全第一"置于核心,在学术界和政策圈积累了相当的话语权。正因如此,微软选择以"灾难性影响"措辞攻击这一对手,其战略意图远比表面上的技术批评更为复杂。
安全叙事如何成为竞争武器
在当前的AI竞争格局中,"安全"已不再只是技术伦理话题,而逐渐演变为企业相互施压和塑造监管环境的话术工具。当一家公司指责另一家可能危害人类时,背后往往交织着市场份额、监管游说和公众认知的多重博弈。
微软在AI领域深度绑定OpenAI,投入了数百亿美元级别的资源。而Anthropic则获得了亚马逊、谷歌等巨头的支持,成为OpenAI阵营之外最重要的挑战者之一。在这样的对垒态势下,双方围绕"谁的AI更安全"展开叙事争夺,几乎是必然的商业逻辑延伸。
微软与OpenAI自2019年起建立深度排他性合作,累计投入估计超过130亿美元,并将GPT系列模型整合进Azure云平台、Copilot办公套件等核心产品线。这种高度绑定意味着OpenAI的市场表现直接影响微软的云业务增长。Anthropic的崛起——尤其是其在企业端和政策圈的渗透——对OpenAI/微软阵营构成直接威胁。理解这一商业结构,是解读本次"安全指控"背后真实动机的必要前提。
这场争论折射的深层问题
这类高调指控暴露出AI行业一个尚未解决的根本矛盾:如何客观评估"AI安全"?当每家公司都自称是负责任的一方、指责对手不负责任时,外界很难有统一、可验证的标准来判断谁的说法更接近事实。
对于监管者和公众而言,这种局面既是提醒也是风险。提醒在于,AI安全确实是需要严肃对待的议题;风险则在于,安全话语可能被异化为竞争手段,稀释了真正的技术风险讨论。当"灾难性影响"这样的词汇被随意用于商业口水战,反而可能让公众对真实的安全警告产生麻木。
目前业界尚无被广泛接受的AI安全评估框架。现有的主要尝试包括:美国NIST发布的《AI风险管理框架》(AI RMF)、英国AI安全研究所(AISI)的模型评估协议,以及部分头部实验室自行制定的"前沿模型安全承诺"(Frontier Safety Commitments)。然而这些框架大多属于自愿性质,缺乏强制执行机制,且评估标准因机构而异。在没有统一第三方核查机制的情况下,企业间的"安全指控"本质上仍是一场无法被公开证伪的话语竞争,这正是当前监管真空的核心体现。
后续观察要点
这则消息目前在社区的讨论度有限(Hacker News上仅10个点赞、5条评论),尚未演变为大规模公开辩论。但它是一个值得持续跟踪的信号:AI巨头之间的博弈正从纯粹的技术和产品竞争,扩展到安全叙事与监管话语权的争夺。
未来需要关注的是,微软的具体指控依据是什么、Anthropic将如何回应,以及监管机构是否会介入。这些后续动向,将比单一的"喊话"本身更能揭示AI行业竞争的真实走向。
相关推荐
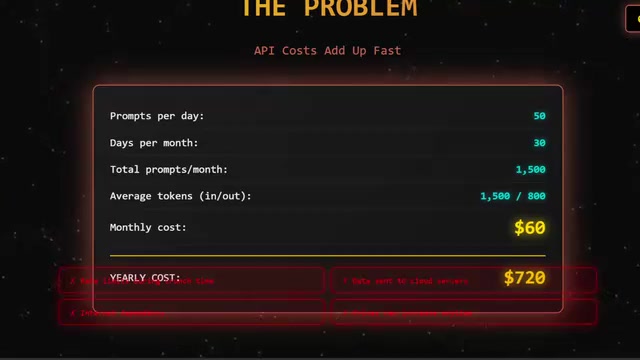
Qwen 27B 本地部署实测:开源大模型能否替代 GPT-4?
Qwen 27B 开源大模型本地部署实测:一条命令用 Ollama 安装,混合注意力支持 262K 长上下文,代码审计任务响应快于 GPT-4,三年成本对比显示本地方案更省钱。开发者本地 AI 部署完整指南。
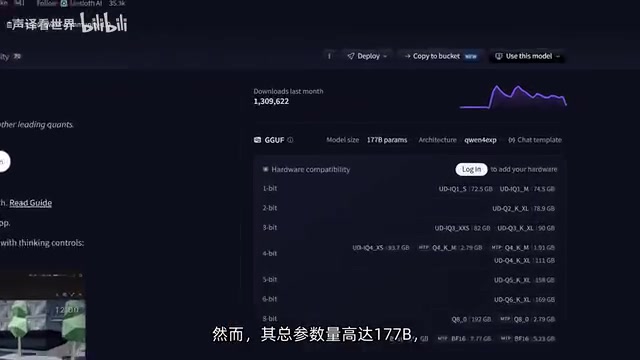
177B大模型跑在廉价显卡上?Qwen3 Flash Next本地部署实测
B站UP主实测用两块廉价显卡加32GB内存本地运行177B参数的Qwen3 Flash Next模型,通过将51B Ngram表卸载到SSD,实现22 tokens/s推理速度。本文解析其架构拆分、llama.cpp部署参数与性能表现。
MiniMax H3登陆Draw Things:Mac/iPad本地跑开源最强音视频模型指南
开源最强音视频模型MiniMax H3已在苹果AI工具Draw Things正式支持。本文详解首尾帧与参考生成两种版本、加速LoRA选择、M系列芯片硬件门槛及LLM提示词技巧,帮Mac/iPad用户判断能否本地运行。