WikiFix for Confluence:用AI自动修复知识库的矛盾与冗余
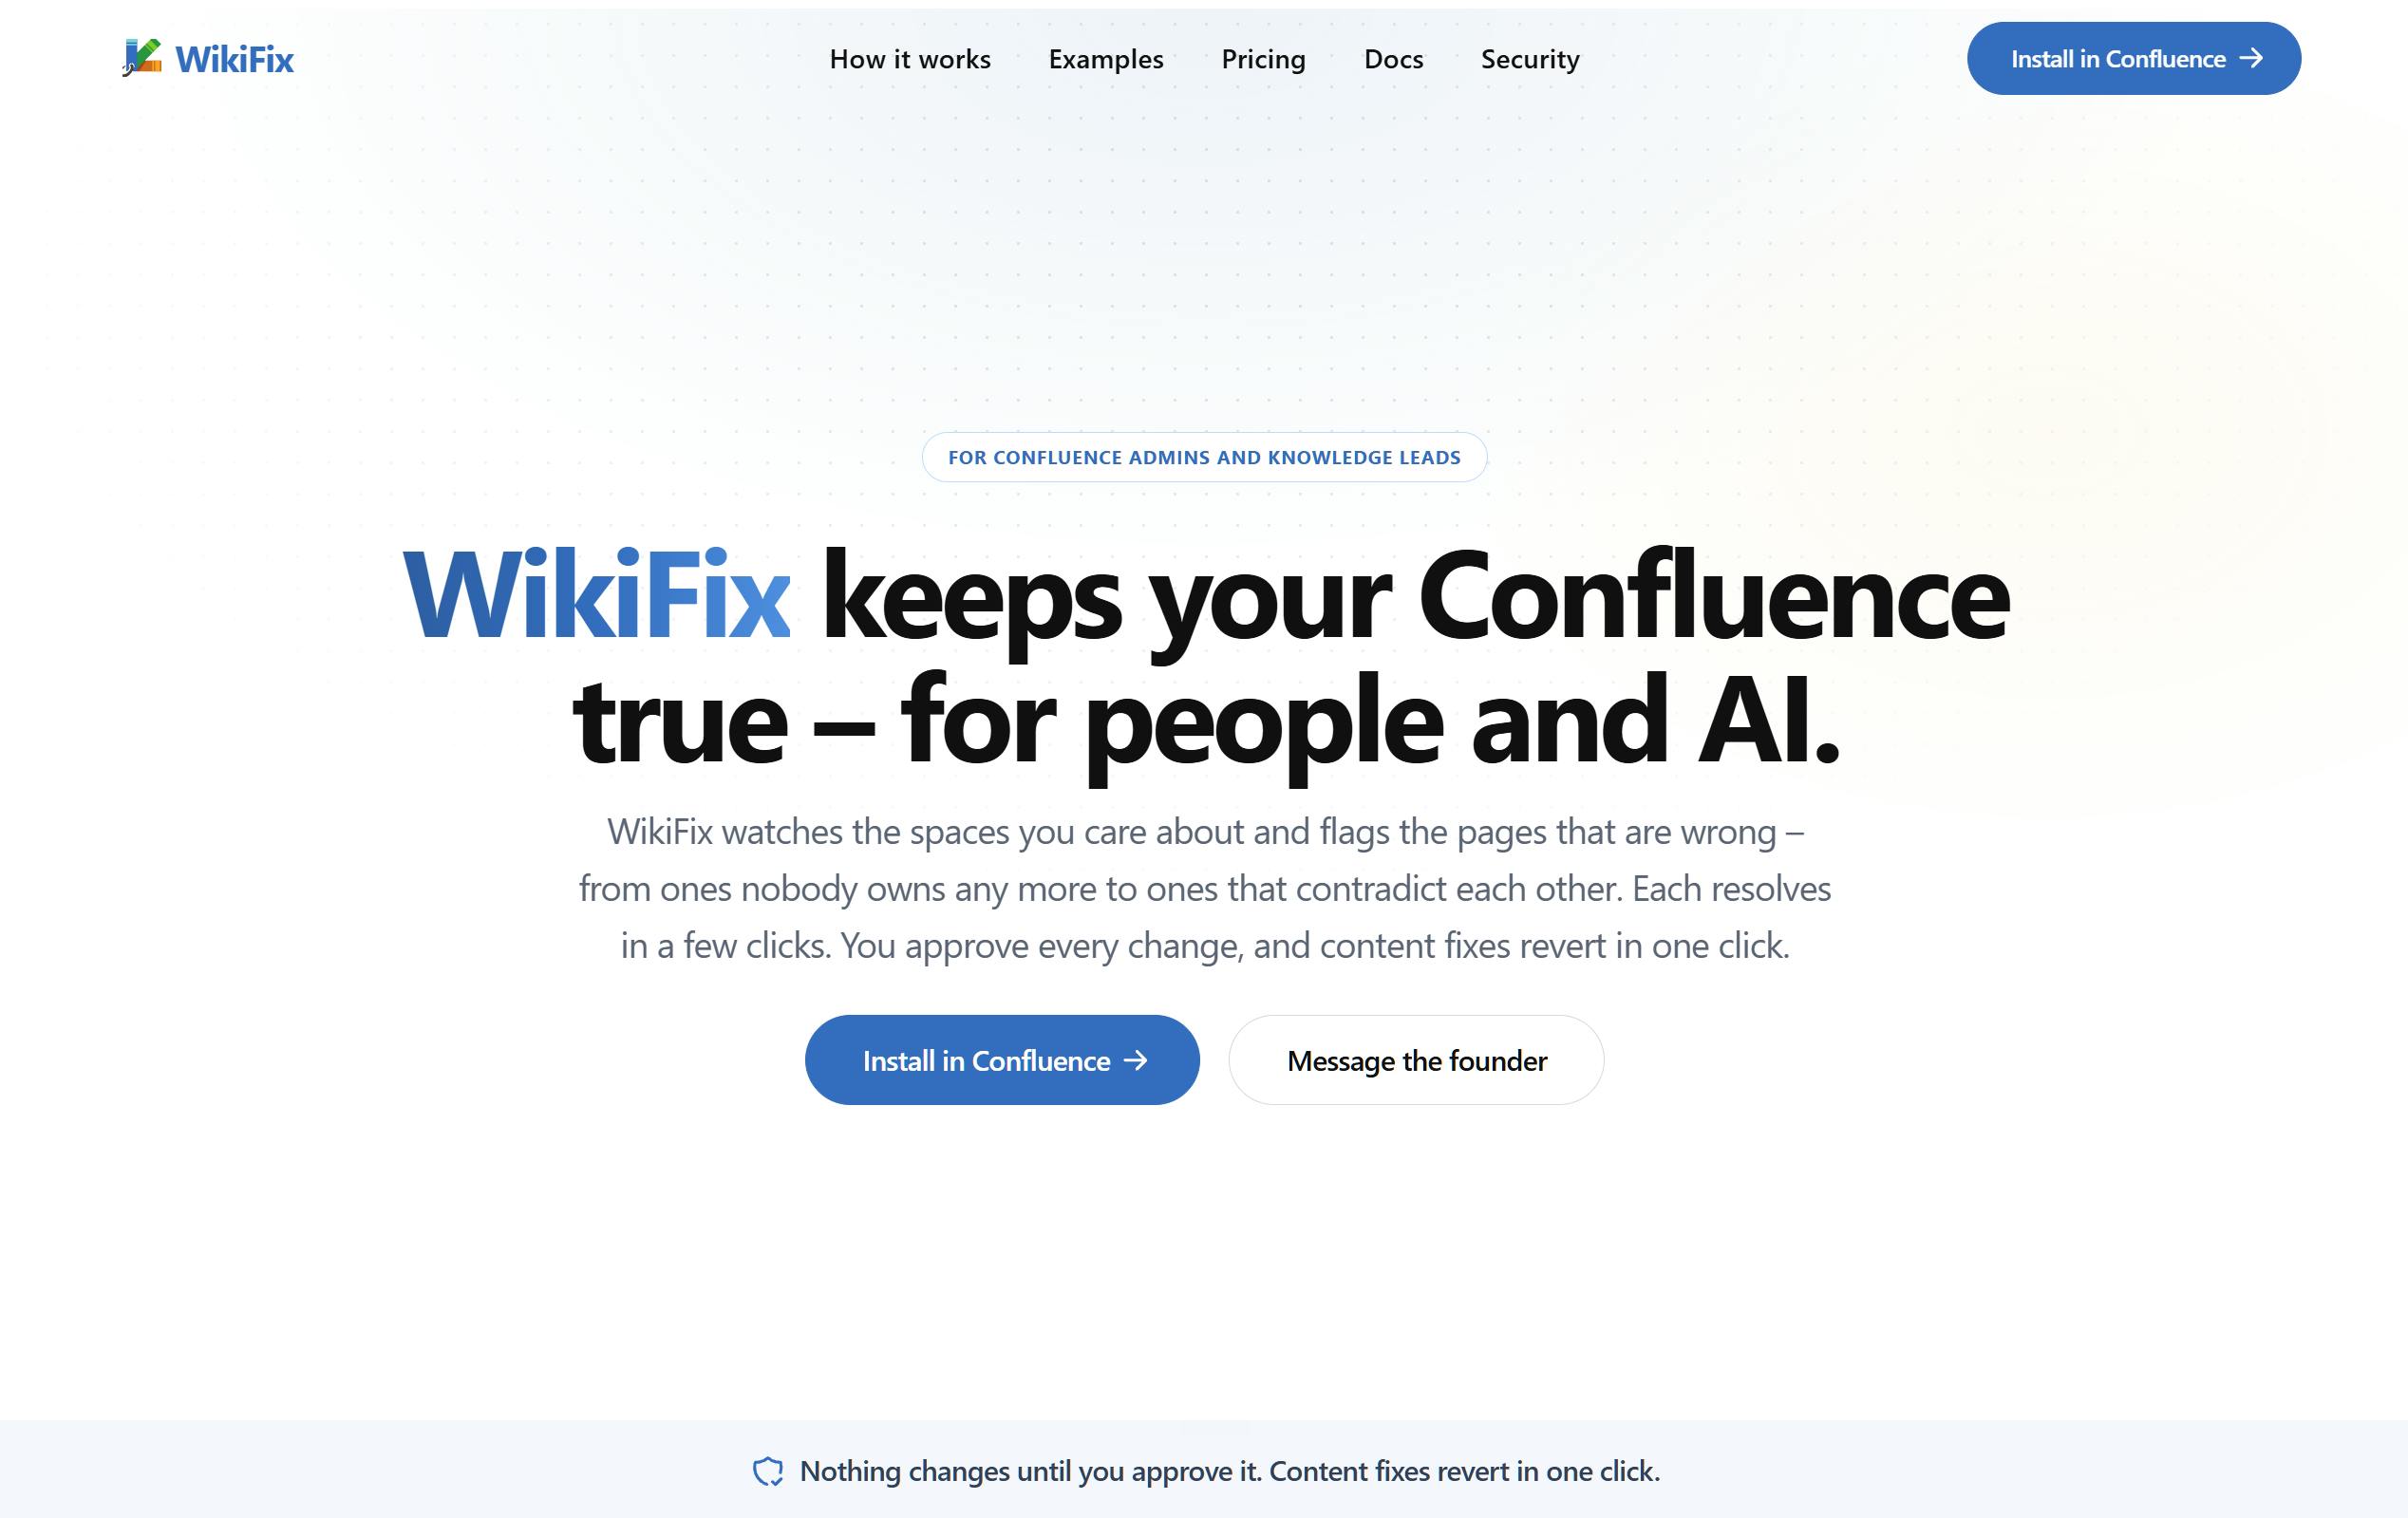
WikiFix用AI持续监控Confluence知识库中的矛盾、重复与孤儿页面,人工确认后一键修复,提升AI时代的知识库数据质量。
WikiFix for Confluence 是一款专为企业知识库数据治理设计的 AI 工具,瞄准 Confluence 中长期累积的三类顽疾:互相矛盾的页面、冗余重复的内容,以及无人维护的孤儿页面。产品的核心设计是"人在回路"模式——AI 持续监控并提出修复建议,由人工审批后一键执行,在自动化效率与操作安全之间取得平衡。其深层逻辑切合当下企业将 Confluence 接入 RAG 系统的趋势:知识库数据质量直接决定 AI 助手的输出可信度,WikiFix 本质上是在为 AI 应用夯实数据底座。产品在 Product Hunt 上线获 84 票、位列当日第 7,验证了需求的真实性,但识别准确率、大规模适用性和修复可控性仍有待实际场景检验。
当知识库成为AI的"数据地雷"
企业把文档沉淀在 Confluence 这类知识库里,本意是让团队有一个可信的信息来源。但现实往往相反:同一个流程有两份互相矛盾的说明、重复的页面散落在不同空间、还有大量没人维护的"孤儿页面"挂在角落。人读起来已经够费劲,当这些内容被喂给 AI 助手时,问题被进一步放大——AI 会把陈旧或冲突的信息当成事实复述出来,团队反而更难分辨真伪。
WikiFix for Confluence 瞄准的正是这个痛点。它在 Product Hunt 上线后拿到 84 票、位列当日排行榜第 7 名,归类于 Productivity、SaaS 和 Artificial Intelligence 三个领域。核心定位可以用一句话概括:持续监控知识库中的问题,并在你确认后一键修复。
它到底解决哪些问题
根据官方描述,WikiFix 聚焦三类典型的知识库顽疾:
矛盾页面(Contradicting pages)
两份文档对同一问题给出不同答案,是知识库最隐蔽也最危险的问题。比如一份文档说报销上限是 500 元,另一份写着 800 元。人工很难发现这类跨页面的逻辑冲突,而 AI 检索时可能随机命中其中一个版本,输出误导性回答。WikiFix 的价值在于主动识别这种语义层面的不一致。
重复内容(Duplicates)
随着团队扩张和空间增多,相同主题被反复创建、复制粘贴,造成信息冗余。重复页面不仅浪费维护精力,也会稀释搜索和 AI 检索的准确性。
孤儿页面(Orphans)
没有任何链接指向、也不在导航结构中的页面,往往是被遗忘的历史遗留。它们可能包含过时信息,却仍然会被全文检索或 AI 索引抓取到。
"审批后一键修复"的设计思路
WikiFix 的产品逻辑中,有一个关键词值得关注:approve(确认)。它并不是让 AI 擅自改动你的文档,而是先监控、发现问题、提出修复建议,再由人工审批后执行。
这种"人在回路"(human-in-the-loop)的设计在企业场景里相当重要。知识库是组织的记忆,自动化工具若直接改写内容,风险极高——一旦误删或错误合并,损失难以挽回。通过保留人工确认环节,WikiFix 把 AI 定位为"发现者和建议者",而把最终决策权交还给团队。一键执行则解决了传统人工清理效率低下的问题,在安全与效率之间取得平衡。
"人在回路"(Human-in-the-Loop,HITL)是 AI 系统设计中的一种安全范式,指在自动化流程的关键决策节点保留人类审核与干预的能力。它与"全自动"模式的核心区别在于:AI 负责处理规模化的感知与建议工作,而人类保留对高风险操作的最终否决权。在企业知识管理场景中,HITL 尤为必要——因为文档内容的"正确性"往往需要业务上下文才能判断,纯粹的语义相似不等于内容可以合并,AI 也可能将故意保留的"历史版本对比"误识别为重复。WikiFix 的审批流程本质上是在为 AI 的不确定性兜底,确保自动化带来的效率增益不以数据安全为代价。
为什么现在是这个产品的时机
WikiFix 的宣传语里反复强调一点:让团队能够信任他们"读到或从 AI 那里听到"的内容。这句话点出了当下的真实需求背景。
越来越多企业把 Confluence 接入内部 AI 助手或 RAG(检索增强生成)系统,知识库从"给人看的文档"变成了"给 AI 读的数据源"。而 AI 的输出质量高度依赖底层数据质量——所谓"垃圾进,垃圾出"。当知识库里充斥矛盾、重复和过时信息,再强大的大模型也无法给出可靠答案。
从这个角度看,WikiFix 本质上是一个数据质量治理工具,服务于 AI 时代的知识库可信度。它不直接做问答,而是确保问答系统所依赖的"原料"是干净的。随着企业级 AI 应用普及,这类面向数据底座的治理产品会有越来越明确的市场空间。
RAG(检索增强生成,Retrieval-Augmented Generation)是当前企业落地大语言模型的主流架构。它的工作方式是:当用户提问时,系统先在知识库中检索相关文档片段,再将这些片段作为上下文"塞给"大模型,由模型基于这些内容生成回答。这与让模型单纯依赖预训练知识不同——RAG 的答案质量直接取决于检索到的文档质量。如果知识库中有两份矛盾的文档同时被检索到,模型可能会"综合"出一个两边都不准确的答案,或者不一致地在不同会话中给出截然相反的结论。这正是 WikiFix 所针对的核心场景:RAG 架构把知识库数据质量的问题从"员工读错文档"升级为"AI 系统性地输出错误信息",治理优先级因此大幅提升。
冷静看待:仍需验证的几点
作为一款刚登上 Product Hunt 的早期产品,WikiFix 目前公开的信息还相当有限。几个关键问题值得潜在用户关注:
- 识别准确率:语义矛盾的检测难度远高于重复页面的查找,AI 判断是否足够精准、误报率如何,是产品成败的核心。
- 适用规模:对于拥有数万页面的大型知识库,监控和分析的性能表现尚不明确。
- 修复的可控性:"一键修复"的具体颗粒度,以及是否支持回滚,直接关系到企业的使用安全感。
84 票的热度说明这个方向击中了真实痛点,但产品的实际效果还需要更多真实场景的使用反馈来验证。对于深度依赖 Confluence 并计划接入 AI 的团队来说,它至少提供了一个值得试用的思路:在让 AI 读你的知识库之前,先把知识库本身理清楚。
相关推荐

LangChain的商业模式还能走多远?LangSmith面临的生存挑战
LangChain的核心营收依赖LangSmith,但AWS Omni等云厂商原生可观测性工具的崛起正在挤压其增长空间。本文分析独立AI开发工具与云原生方案的护城河之争,以及LangChain面临的商业化挑战。

用强化学习在UE5中训练AI钢铁侠:PPO算法救援13名乘客实验
一位开发者在虚幻引擎5中用PPO强化学习算法训练AI钢铁侠,让其学会飞行救援13名下坠乘客。本文解析该体素风格项目的技术思路、PPO选型逻辑与UE5仿真训练的价值与局限。

传奇设计师Richard Garriott重掌《创世纪》系列版权
游戏传奇设计师Richard Garriott正式重新获得经典RPG系列《创世纪》(Ultima)的控制权。本文解读这一版权回归对玩家与游戏行业的潜在意义。