我给自己造了个可对话的数字分身:AI克隆的喜与忧
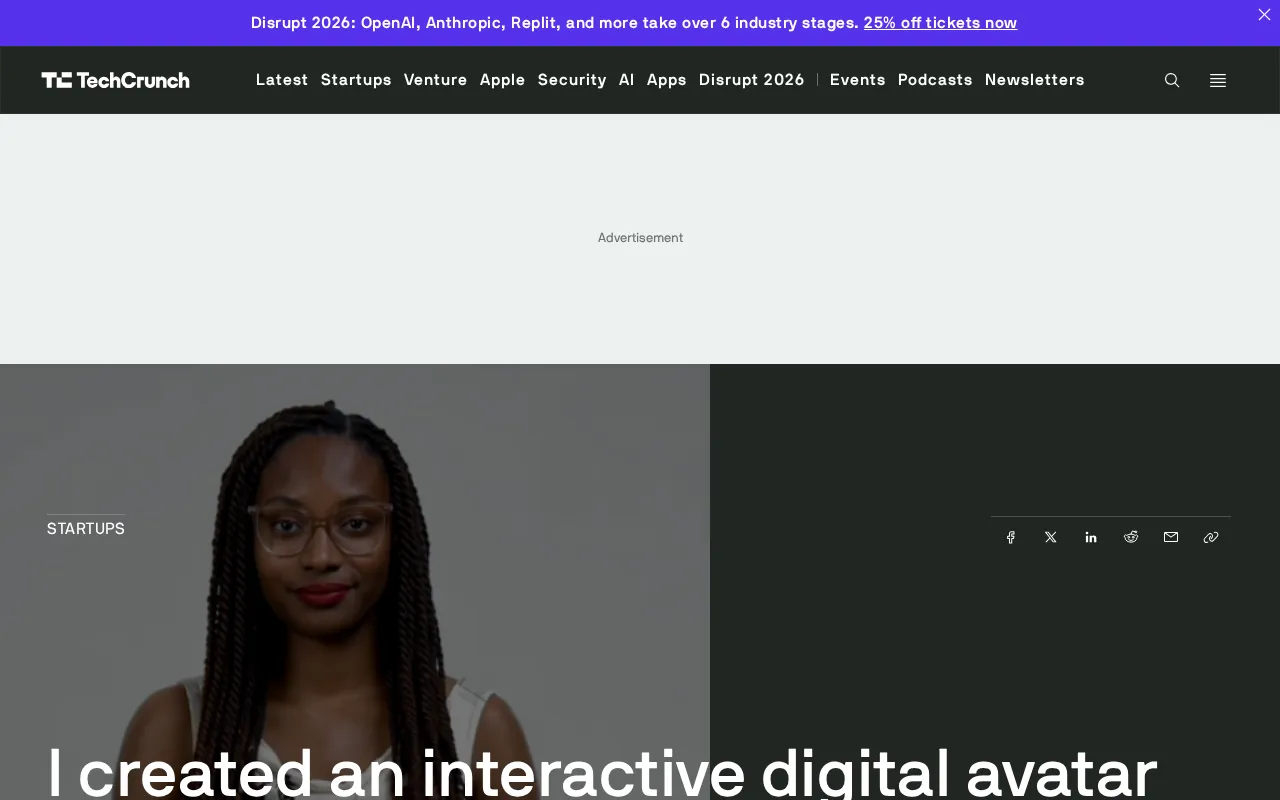
作者亲身制作AI数字分身并训练其讨论风险投资欺诈,体验后对这项技术抱有复杂矛盾的感受。
一位科技作者亲手打造了可实时对话的交互式AI数字分身,并专门训练其讨论风险投资欺诈这一专业垂直话题。该技术融合语音克隆、面部动画驱动与大语言模型问答,正逐步走向普通人可及的产品化阶段。作者的实验揭示了这项技术的双面性:一方面,数字分身能够7×24小时代替本人传递知识、扩大个人影响力,在教育、客服与内容创作等场景具有广阔潜力;另一方面,当AI以本人面孔和声音发言,随之而来的内容可信度、身份真实性以及深度伪造滥用等伦理问题同样不可忽视。作者最终以"复杂矛盾的感受"作结,折射出整个行业在技术能力与伦理边界之间仍在摸索平衡的现实处境。
当你的AI分身开口说话
把自己变成一个可以随时对话的数字化身,听起来像科幻电影里的桥段,如今却已经成为触手可及的现实。一位科技作者亲自尝试打造了自己的交互式数字分身(interactive avatar),并训练它去讨论一个相当专业的话题——风险投资欺诈(venture fraud)。整个过程结束后,他对"制作自己的AI克隆"这件事,留下了复杂而矛盾的感受。
这类交互式数字分身的核心,是把一个真实的人——包括其外貌、声音、表达方式,甚至知识背景——封装成一个可以实时对话的AI形象。用户不再是面对冷冰冰的文字聊天框,而是与一个"看起来像你、听起来像你"的虚拟形象交流。这背后融合了语音合成、面部动画驱动、大语言模型问答等多项技术。
交互式数字分身的技术实现通常依赖几个关键模块的协同:语音克隆(voice cloning) 通过采集数分钟至数小时的真人音频,训练出能模仿音色、语调和节奏的合成模型;面部动画驱动(talking head generation) 则将语音信号实时映射为口型与面部表情,让虚拟形象"开口说话"看起来自然流畅;底层的 大语言模型(LLM) 负责理解用户提问并生成回答,再经由上述两层渲染为有声有色的视频流。目前市场上已有 HeyGen、Synthesia、D-ID 等商业平台提供一站式服务,用户上传照片或短视频、录制声音样本,即可在数小时内获得可交互的数字分身,无需掌握任何深度学习知识。正是这种"打包即用"的产品化,使得技术门槛从专业实验室降到了普通创作者可负担的水平。
从"造分身"到"训练它谈专业话题"
值得关注的一点是,作者并没有满足于让分身只做简单的寒暄,而是专门训练它去讨论风险投资欺诈这一垂直且严肃的领域。这意味着数字分身不只是一个视觉噱头,而是承载了特定的知识与观点表达能力。
要让AI分身在专业话题上言之有物,需要向模型注入相关的知识语料,并对其回答风格进行约束和调校,使其既能反映本人的立场,又不至于胡言乱语。这种"人格+专业知识"的组合,让数字分身从娱乐工具逐渐靠近生产力和内容传播工具的定位。
让AI分身具备垂直领域知识,通常借助 检索增强生成(RAG, Retrieval-Augmented Generation) 技术来实现。具体做法是将文章、报告、演讲稿等特定领域语料切片后存入向量数据库,当用户提问时系统先从库中检索最相关的片段,再将其作为上下文拼接给语言模型,从而让回答紧扣特定知识体系而非依赖模型的通用预训练记忆。相比直接对模型进行微调(fine-tuning),RAG 成本更低、内容更易更新,也更方便随时追加新素材。在风险投资欺诈这类对准确性要求极高的话题上,RAG 还能通过引用原始文档降低"幻觉"(hallucination)风险,但并不能完全消除——这也是作者产生矛盾感受的技术根源之一。
AI克隆带来的矛盾感受
作者用"mixed feelings"(复杂的感受)来概括这次体验,这恰恰是当下AI克隆技术最真实的写照。一方面,能够创造一个24小时在线、可以代替自己回答问题、传递知识的数字形象,确实充满吸引力——它可以扩展个人影响力,甚至在本人不在场时继续"对话"。
另一方面,这种技术也引出了一系列难以回避的问题:当一个AI分身以你的面孔和声音说话时,它说出的内容是否真正代表你?如果它在讨论像投资欺诈这样敏感的话题时出现偏差,责任又该由谁承担?更进一步,数字分身一旦被制作出来,其形象与声音的使用边界该如何界定,是否存在被滥用或伪造的风险?
数字分身的现实意义与隐忧
从行业视角看,交互式数字分身正在成为AI应用的一个新兴方向。它在教育、客服、内容创作、个人品牌建设等场景都有潜在价值——想象一位专家把自己的知识封装成可对话的分身,让更多人随时"请教",这无疑能放大知识的传播效率。
但技术越逼真,伦理与信任问题就越突出。当"数字的你"和"真实的你"越来越难以区分,身份真实性、内容可信度以及深度伪造(deepfake)滥用等担忧便随之而来。作者亲身实验后的"矛盾感",本质上是对这项技术双刃剑属性的清醒认知:它既能赋能个人表达,也可能模糊真实与虚构的界限。
深度伪造(deepfake)滥用是数字分身技术最受关注的风险之一。与早期需要大量训练数据的换脸技术不同,现代生成式AI已能从数张照片和数十秒音频中重建高度逼真的视听形象,制作成本和时间大幅下降。目前多国已开始立法应对:美国部分州通过了针对选举相关深度伪造的禁令,欧盟《人工智能法案》将操纵性合成内容列为高风险应用,中国也于2022年出台《互联网信息服务深度合成管理规定》,要求对AI生成内容进行显著标识。然而技术迭代速度远快于监管落地速度,"谁能证明这段视频是真实的我说的"这一身份验证难题,目前尚无成熟的通用解决方案,数字水印和内容溯源(content provenance)标准仍在行业内持续讨论中。
写在最后
这次"给自己造一个可对话AI分身"的实验,提供了一个观察AI克隆技术的鲜活样本。技术门槛正在降低,普通人也能创建属于自己的数字化身,但随之而来的关于身份、责任与信任的讨论才刚刚开始。在拥抱便利的同时,如何为AI克隆划定合理边界,将是接下来每个尝试者都需要面对的课题。
(注:本文基于有限的原始素材撰写,具体产品名称与技术细节以官方信息为准。)
相关推荐
AI智能体信任危机:Markdown注入攻击已从实验室走向现实
安全研究者记录到一起在野Markdown注入攻击:恶意文档内容被AI智能体误判为可信指令,以完整凭证执行未经批准的工具调用。本文解析攻击机制、环境信任症结,以及生产环境中信任边界的防御思路。
开源鲁棒性测试框架SIRFEX:失败驱动的PPO重训为何拖累正常性能?
开源框架SIRFEX用失败场景微调PPO,却导致标称性能下降。本文解析其实验数据、负结果原因,并探讨鲁棒性提升与标称性能保持的平衡之道。
AI Gateway推出虚拟模型:集中管理模型配置,无需重新部署
AI Gateway 推出虚拟模型功能,用自定义模型 ID 集中管理模型选择与参数配置,支持编程 Agent 设置注入、供应商路由与零数据保留合规、花费归属标签,修改配置无需重新部署应用。