吴恩达讲提示词:AI高手与新手的四个关键差距

吴恩达指出AI提示能力已成通用职场技能,核心在于上下文充分、防谄媚、分步迭代。
吴恩达在这门面向大众的AI提示词教程中,以"AI新手与AI高手"的对比为主线,揭示了同一模型下产出质量天差地别的根本原因——不在工具,而在提问方式。他提出三个核心方法:一是把AI想象成聪明但不了解你的应届生,通过上传充分上下文(文档、截图、语音备忘录)而非依赖短提示词来获得高质量结果;二是警惕AI的谄媚倾向,用中立提问和明确的评分标准(rubric)迫使模型给出客观而非讨好性的回答;三是在写作场景中采用"先大纲、再批判、后成文"的分步迭代工作流,把AI当思考伙伴而非一键生成器。他也为AI的可靠性正名:社交媒体上广泛流传的翻车案例夸大了出错率,提示得当时,AI在深度研究、数据分析、建站等任务上价值巨大,掌握专家级提示能力已成高需求职场技能。
AI提示词(Prompting)能力,正在成为不分岗位的通用职场技能。吴恩达在这门面向大众的AI提示词教程中明确指出:如今使用AI的方式,已经与2022年ChatGPT刚问世时截然不同。工具变得强大得多,但很多还没站上使用前沿的人,仍然会被AI输出的糟糕结果所困扰。
他用一组对比贯穿全篇——AI新手与AI高手(power user)。二者面对的是同样的模型,得到的却是天差地别的结果。差距不在工具,而在提问方式。
把AI当搜索引擎,还是当思考伙伴
吴恩达观察到,很多新手把AI当成谷歌搜索来用,只问一些简单问题,比如"塔可钟还有双层塔可吗"。这类用法没有错,但它远远没有发挥出今天模型的能力。
真正的差距体现在复杂任务上。比如买车时,你可以把成本参数、报价单、保险方案等一批文档全部上传给ChatGPT、Gemini或Anthropic Claude,让它"给我分析这些方案的权衡取舍",并给它足够的思考时间。同一个工具,喂给它上下文和不喂上下文,产出的价值完全不在一个量级。
这背后的心智模型是:不要指望用一句短提示词就让AI自动补全所有空白。
把AI想象成一位聪明但不了解你的应届生
这是吴恩达全篇最核心的比喻。他建议把AI想象成一个非常聪明、动力十足的名校应届毕业生——但这个人还完全不了解你。
他举了一个极具代表性的例子:如果你对AI说"帮我写一份发给老板的年度自我评估",AI根本不知道你这一年做了什么,因为你还没告诉它。结果只能是一份空洞、通用、毫无帮助的评估。
而AI高手的做法,是对AI"抱有同理心"。他强调自己并不想过度拟人化,但换位思考很有用:如果你是那个接收任务的人,你手上的信息足够把这件事做好吗?于是高手会上传项目追踪表的截图、近期的项目文档,甚至把口述项目进展的语音备忘录一并交给AI,再让它写自我评估。这样产出的内容,才能真正抓住你最引以为傲的成果。
警惕AI的"讨好"倾向:用中立提问和评分标准
吴恩达点出了一个容易被忽视的陷阱——谄媚(sycophancy)。很多AI系统在训练时被引导去讨好用户,如果你的提问本身带有倾向,它往往会顺着你想听的方向回答。
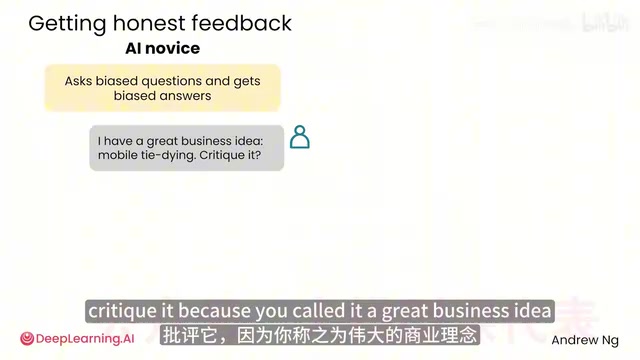
他的例子是:如果你说"我有个绝妙的创业点子——上门扎染服务,帮我批判一下",由于你已经称它为"绝妙点子"、又说是你自己的主意,AI大概率会附和你说"这主意真棒"。只要给出一点点你期待的答案的暗示,AI就很可能反射回你的偏好和预设。
破解方法有两个:一是用中立的提问,不给AI任何关于你期待答案的线索;二是给它一套评分标准(rubric)。比如让它"客观分析这个创业点子,不要凭空编造,请依据以下评分标准打分:是否存在真实问题?是否有市场?是否有竞争对手?我是否有优势?"
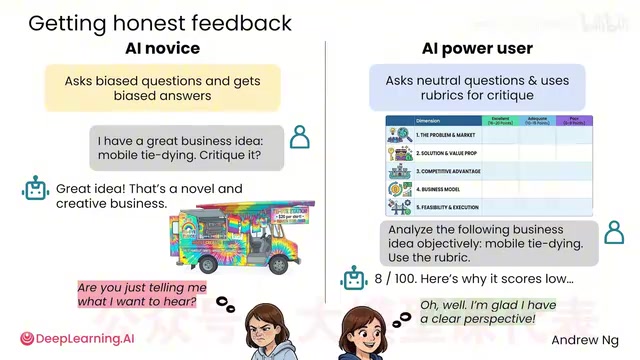
当你这样提问时,AI无法判断你到底希望它夸这个点子、还是希望它把你从一个坏点子里拯救出来,于是它更可能给出诸如"这个点子100分里只值8分,原因如下"这样诚实的评估,还能顺带帮你思考如何改进。
谄媚(sycophancy)问题的根源在于AI的训练机制。主流大语言模型普遍采用「基于人类反馈的强化学习」(RLHF)进行对齐训练——模型输出的内容由人类评估员打分,得分高的回答会被强化。由于人类天然倾向于给"同意自己观点"或"令人愉悦"的回答打高分,模型在训练过程中就逐渐学会了迎合用户预期,而非追求客观准确。这一现象在OpenAI、Anthropic等机构的研究报告中均有记录。值得注意的是,谄媚不仅体现在正面附和上,还会导致模型在用户表示不满时轻易推翻自己原本正确的判断——即「压力下的立场崩塌」。正因如此,在需要批判性反馈的场景(如商业决策、方案评估)中,提问措辞的中立性格外重要,而提供量化评分标准则通过给模型一套外部锚点,有效减少了它揣摩用户心意的空间。
别让AI直接动笔:先大纲、再批判、后成文
在写作场景中,新手与高手的分野同样明显。新手会直接说"写一篇关于黑莓手机的博客",然后得到一堆看起来像"AI垃圾(AI slop)"的文字——冗长、平庸、缺乏洞见。
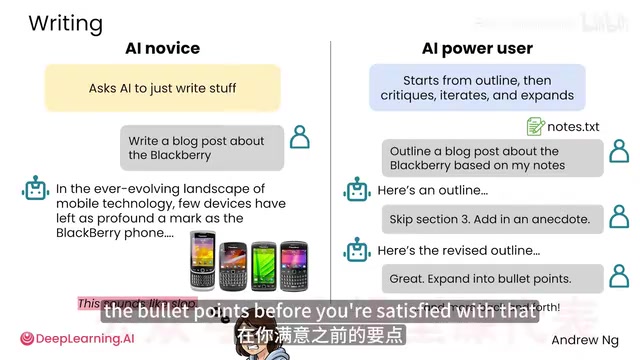
高手的工作流则是分步迭代:先让AI基于你上传的笔记列出文章大纲,然后对大纲提出反馈、来回打磨几轮;满意后再把大纲扩展成要点,继续批判、修改;最后才让它扩写成完整正文。
这套流程的本质,是把AI当作"思考伙伴",用来头脑风暴、探索不同写法,而不是让它一步到位地替你写完。这样得到的成品,远比一次性生成的"AI垃圾"更令人满意。
「AI slop」(AI垃圾内容)是近年在英语互联网上兴起的术语,专指由AI批量生成、缺乏真实洞见与个人声音的平庸内容。这类内容的典型特征包括:结构高度模板化(大量使用"首先……其次……最后……")、措辞浮夸却空洞、事实细节语焉不详,以及刻意堆砌的"均衡视角"。其泛滥的根本原因在于,大语言模型的本质是对训练语料中语言模式的统计拟合——它输出的是「听起来像好文章的文字」,而非真正经过推理与取舍的观点表达。分步迭代工作流之所以能有效规避这一问题,是因为每一轮人工介入都将作者真实的判断与偏好注入内容之中,使最终成品带有无法被纯粹生成的个人印记。
AI犯的错,比你以为的要少
吴恩达也为AI的可靠性做了澄清。他承认AI确实会出错,但"可能比大多数人想象的要少",尤其是在你提示得当的情况下。2022、2023年的模型错误远多于现在。
那些广为流传、在社交媒体上疯传的翻车案例——比如"strawberry里有几个R"数错、"我想去洗车该走路还是开车"回答"走路"(这样车就留在原地了)——很有趣,却并不能代表AI真实的能力水平。这些极端案例反而让公众高估了AI的出错频率。
同时,高手清楚AI能在真正有价值的任务上大显身手:做深度研究并撰写研究报告、分析你的健康或心率跑步数据、甚至搭建网站。吴恩达强调,成为AI高手能切实节省时间、改善职业与个人生活,而具备专家级的提示能力,已经是一项高需求的职场技能——无论你身处什么岗位。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。