无需训练的Prompt压缩:CPU即可运行的确定性词法方案
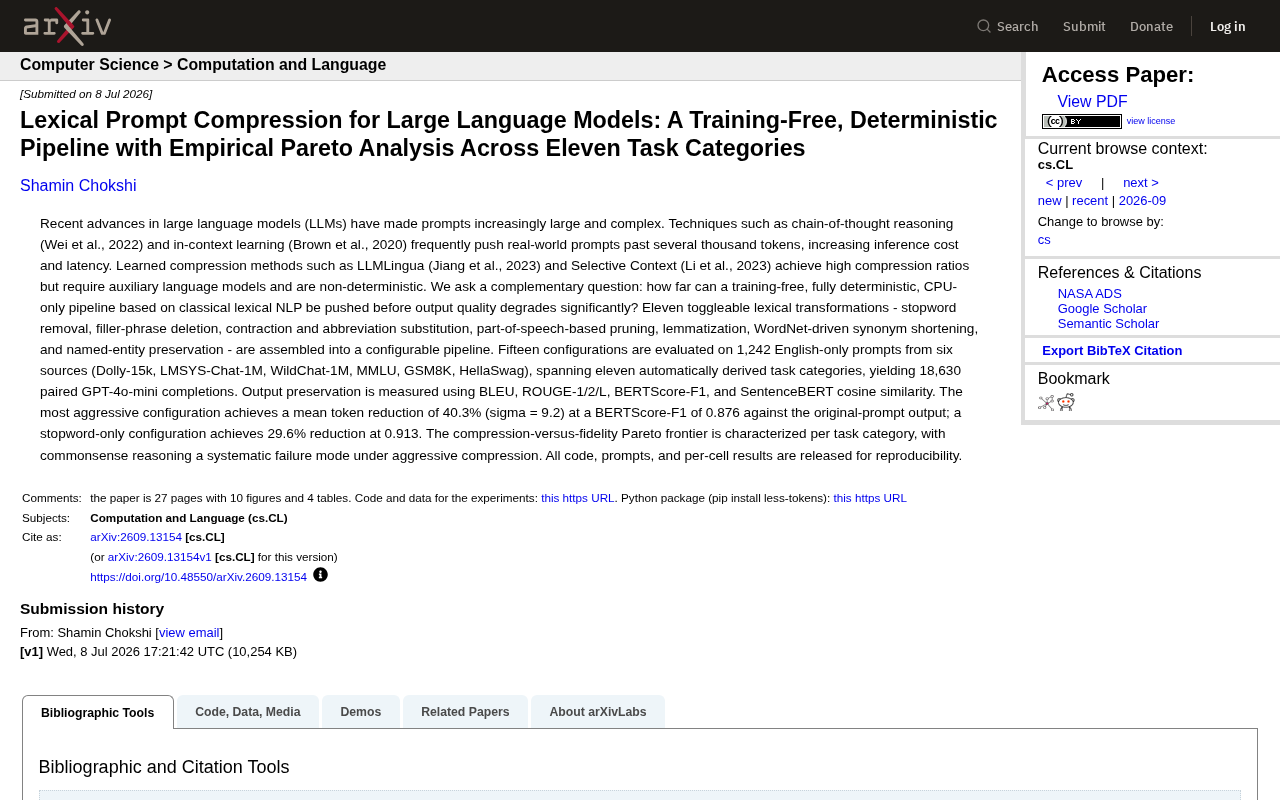
纯CPU词法管线无需训练即可压缩Prompt近40%,但常识推理任务在激进压缩下系统性失效。
本文介绍了一篇arXiv论文,针对大模型Prompt膨胀导致推理成本上升的问题,提出了一套完全不依赖训练和辅助模型的词法级压缩管线。该管线由十一种可独立开关的确定性变换组成(包括停用词移除、词形还原、WordNet同义词替换等),仅需CPU即可运行。研究者在六个数据源的1242条Prompt上评估了15种配置,产生18630对GPT-4o-mini补全结果,综合BLEU、ROUGE、BERTScore等多项指标衡量输出保真度。结果显示,最激进配置可削减40.3%的token(BERTScore-F1为0.876),而仅用停用词移除即可删除29.6%的token且保真度高达0.913。研究还发现常识推理任务在激进压缩下会系统性失效,提示实践者应根据任务类型选择压缩强度,而非一刀切。
大模型Prompt膨胀带来的成本困境
随着思维链推理(Chain-of-Thought)和上下文学习(In-Context Learning)等技术被广泛采用,真实场景下的提示词动辄突破数千token。每一次膨胀都意味着更高的推理成本与延迟——对于按token计费的商业API或本地部署的推理集群而言,这是一笔实实在在的开销。
如何在不牺牲输出质量的前提下压缩Prompt,已经成为一个值得系统研究的工程问题。目前主流的压缩方法如LLMLingua(Jiang et al., 2023)和Selective Context(Li et al., 2023)确实能实现较高的压缩比,但它们有两个明显的代价:一是需要引入辅助语言模型来判断哪些token可以删除,二是压缩结果具有非确定性——同样的输入可能产生不同的压缩输出。
这篇arXiv新论文提出了一个反向思路:完全不依赖训练、不依赖任何辅助模型,仅靠经典的词法级NLP处理,一个纯CPU管线能把Prompt压缩到什么程度而不显著损害输出质量?
十一种可开关的词法变换
论文的核心是一个可配置的处理管线,由十一种可独立开关的词法变换组成:
- 停用词移除(stopword removal)
- 填充短语删除(filler-phrase deletion)
- 缩写与省略形式替换(contraction and abbreviation substitution)
- 基于词性的剪枝(POS-based pruning)
- 词形还原(lemmatization)
- 基于WordNet的同义词缩短(synonym shortening)
- 命名实体保留(named-entity preservation)
这套设计的巧妙之处在于「可组合」与「确定性」。每一种变换都遵循固定的规则逻辑,没有随机性,也不需要GPU算力,任何一台普通CPU机器都能运行。这与依赖大模型打分的学习式压缩方法形成了鲜明对比——后者的黑盒特性和资源需求,恰恰是本文希望规避的。
命名实体保留这一项尤其关键。在压缩过程中,人名、地名、专有名词等承载核心信息的成分被显式保护,避免因激进删词而丢失关键语义。
大规模实证:1242条Prompt与18630对补全
为了验证不同配置的效果,作者构建了相当扎实的评测体系。研究从六个数据源采样了1242条纯英文Prompt,包括Dolly-15k、LMSYS-Chat-1M、WildChat-1M、MMLU、GSM8K和HellaSwag,覆盖了自动推导出的十一个任务类别。
在此基础上评估了十五种管线配置,最终产生了18630对由GPT-4o-mini生成的配对补全结果。输出保真度的衡量并未依赖单一指标,而是综合了BLEU、ROUGE-1/2/L、BERTScore-F1以及SentenceBERT余弦相似度多个维度,从字面重合到语义相似都有覆盖。
这种多指标、多任务、大样本的设计,使得结论不至于流于个案,而是能够刻画出压缩强度与输出质量之间的整体权衡关系。
压缩比与保真度的帕累托前沿
实验结果给出了几个具有参考价值的数字:
- 最激进配置:平均token削减率达到40.3%(标准差9.2),此时相对原始Prompt输出的BERTScore-F1为0.876。
- 仅停用词配置:token削减29.6%,BERTScore-F1保持在0.913的较高水平。
换句话说,仅仅去掉停用词这一最保守的操作,就能砍掉近三成的token,而语义保真度损失极小。若追求更高压缩比,则需要接受一定的质量下降——这正是压缩与保真之间的帕累托前沿(Pareto frontier)。
论文进一步按任务类别刻画了这条前沿曲线,揭示了一个重要的差异化现象:不同任务对压缩的耐受度并不相同。
常识推理是激进压缩下的系统性失效点
最值得警惕的发现是:在激进压缩配置下,常识推理(commonsense reasoning)任务表现出系统性的失效模式。
这一结论具有很强的实践指导意义。停用词、填充短语这类看似「冗余」的成分,在常识推理场景中往往承载着隐含的逻辑关联和语境线索,激进删除会破坏模型对问题的正确理解。相比之下,事实性问答或结构化任务对压缩的容忍度更高。
这提醒工程实践者:Prompt压缩不应采用「一刀切」的策略,而应根据任务类型选择合适的压缩强度。对于推理密集型任务,保守的停用词移除可能就是安全边界;而对于信息检索或格式化输出类任务,则可以更激进。
对工程落地的启示
这项工作的价值不在于刷新压缩比的天花板,而在于重新界定了「无需训练、确定性、CPU可运行」这一约束下的可行边界。对于希望降低推理成本又不愿引入额外模型依赖的团队而言,这套词法压缩管线提供了一个可解释、可复现、零额外算力开销的基线方案。
作者公开了全部代码、Prompt和逐单元格结果以支持复现,这为后续研究和工程改造留下了空间。在学习式压缩方法日益复杂的当下,这种回归经典NLP、强调确定性与透明度的思路,反而为实际部署提供了一个务实的选择。
相关推荐
AI验证系统降本困局:如何少读证据又不漏掉关键信息
AI验证系统的真正成本不在检索而在阅读证据量。本文剖析一个RAG验证流水线的降本实践:提前停止、跳过切片、去重为何收效甚微,以及如何在保持高召回率的同时不漏掉少数派证据这一核心难题。
开发者微调AI模型实现视频字幕与水印去除
一位开发者微调开源模型,实现视频字幕与水印去除功能,支持图片处理,已部署在Hugging Face上开放试用。本文解析其实现思路、性能表现与应用争议。
Salesforce联手英伟达推Koa模型:企业AI的开源突围
Salesforce与英伟达联合推出基于开放权重模型Nemotron的推理模型Koa,专注销售、营销和客服场景。本文分析这一垂直化AI策略为何值得通用大模型实验室警惕,以及它对行业格局的启示。