向量数据库入门全解:从嵌入到ChromaDB语义搜索

从向量、相似度、分词到嵌入模型,系统讲解向量数据库原理与ChromaDB语义搜索实战。
文章系统梳理了向量数据库的完整知识链路:它专为存储和检索嵌入模型生成的高维向量而设计,核心能力是语义搜索,与传统数据库是配合而非替代关系。文章从向量与相似度度量讲起,说明余弦相似度只看方向、适合语义检索,欧氏距离衡量直线距离、适合物理空间场景;接着解析分词与嵌入机制,指出子词分词控制 token 数量、语义在嵌入阶段被编码进向量空间;并将嵌入模型分为词嵌入、文本嵌入、多模态嵌入三代。内部架构上,向量数据库由 API 网关、索引层、存储层、查询处理层构成,IVF 与 HNSW 是两类关键 ANN 索引。实战部分用 Gemini 生成 768 维嵌入并存入 ChromaDB,验证了关键词不出现也能命中的语义匹配,并强调查询与写入必须使用同一模型和维度。
向量数据库入门全解:从嵌入到ChromaDB语义搜索
当一个用户搜索「如何提升专注力」,系统返回的却是包含「专注」二字的文档,而真正讲「注意力训练」的文章却被漏掉——这种关键词搜索的窘境,正是向量数据库要解决的核心问题。一位拥有十年软件工程经验、四年AI工程经验的讲师,在一门面向初学者的完整课程中,从向量、相似度、分词、嵌入模型一路讲到ChromaDB实战,把这条链路拆得足够细。本文提炼其中关键脉络,并补充一些实践视角的解读。
向量数据库到底解决什么问题
课程给出的定义是:向量数据库是专为存储、索引和搜索由嵌入模型生成的高维向量嵌入而设计的数据库,核心能力是语义搜索。这个定义里藏着三个需要展开的概念:高维向量嵌入、嵌入模型、语义搜索。
传统关系型数据库擅长结构化数据——行、列、固定模式,查询靠 WHERE 子句做精确匹配或范围过滤。但今天大量数据是非结构化的:文本、PDF、音频、视频、图片。这些数据维度高、以意义为核心,传统数据库能存,却很难在规模上做基于含义的检索。
关键分歧在于「关键词」与「语义」。关键词搜索要求查询词出现在文档里;语义搜索则比较向量空间中的距离。课程中的演示很能说明问题:在存入若干句子后,用「programming」去查询,命中的是「如何写一个Python函数」和「如何在Java中创建类」——这两句话里都没有「programming」这个词,但语义上高度相关。换成「electronics」查询,返回的是「苹果发布新iPhone」和「哪款智能手机拍照最好」。
需要强调的一点是,向量数据库并不取代传统数据库。课程明确指出,真实系统里两者是配合关系:传统数据库作为记录系统(system of record),向量数据库在其上构建语义检索层。这一判断与业界主流架构一致。
从向量到相似度:理解搜索的数学基础
要理解向量数据库,先要理解向量。在机器学习语境下,向量是一维数字数组,每个数字代表对象的一个特征。课程用汽车举例:只用「速度」一个特征,是一维向量,可以画在数轴上;加上「油耗」变成二维,可以画在平面上;再加上「价格」变成三维,可以画在三维空间。到了真实嵌入模型,维度可以到约3000维,超出人类可视范围,但「相似的在空间中靠得近、不同的离得远」这一直觉始终成立。
课程特别澄清了一个常见误解:所有向量不都是向量嵌入。向量是更宽泛的数学对象,嵌入是嵌入模型产出的、携带语义的向量。
衡量相似度有两种主要度量。余弦相似度只看方向、不看大小,取值在-1到1之间:结果为1表示两向量同向,0表示正交(无直接关系),-1表示方向相反。课程用向量A=[2,0,1]和B=[4,0,2]演示:点积为10,模长分别为2.23和4.47,余弦相似度约为1——尽管B的模长几乎是A的两倍,方向一致就判定为高度相似。这正是余弦相似度适合向量嵌入的原因:嵌入的语义由方向承载,而非模长。
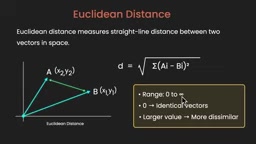
欧氏距离则衡量空间中两点间的直线距离,取值从0到无穷,为0表示完全相同。它关心「有多远」,不关心方向,因此更适合GPS、机器人、空间计算等物理距离有意义的场景。课程的建议是:在向量数据库和语义检索场景中,余弦相似度是更常用的选择。
分词与嵌入:语义是如何被「算」出来的
嵌入模型不理解原始文本,它先要把文本变成 token。课程把分词分为三类:字符级、词级、子词级。字符级切分粒度太细,token 数量会爆炸;词级切分把每个词当作独立单元,词表膨胀且无法处理未登录词;子词级则在两者之间取平衡,把词拆成更小的可复用单元。
课程用 OpenAI 的分词器演示了几个典型现象:常见词映射为单个 token,生僻词被拆成多个 token,emoji 这类 Unicode 字符可能按字节拆成多个 token,而「123」「456」「789」这种常见数字序列会被合并成单个 token。同一段文本,字符级切分会得到252个 token,子词级只需53个。现代大语言模型普遍采用子词分词,核心动机就是控制 token 数量——而 token 正是嵌入模型计费的依据,理解 token 直接关系到成本。
分词之后,嵌入模型把 token 转成高维向量。这里有一个关键洞察:token 本身只是数字符号,不携带语义;语义是在嵌入阶段被「编码」进向量空间的。课程用向量运算做了直观展示:king - man + woman 约等于 queen,Delhi - India + Japan 约等于 Tokyo。模型从未被显式训练做这类运算,但词与词之间的关系被编码成了向量空间中的方向与位移。
子词分词的具体做法值得展开。以常见的 BPE(字节对编码)为例,算法从字符或字节出发,反复统计语料中最高频的相邻符号对并将其合并为新符号,最终得到一个兼顾常用词完整性与生僻词可分解性的词表。WordPiece 与 SentencePiece 是同类思路的不同实现,后者还支持直接从原始文本训练、无需预先按空格切词,因而对中文等无空格语言更友好。子词分词的关键价值在于未登录词的处理:词级分词遇到训练时没见过的词只能标记为未知符号,而子词分词可以把它拆成若干已知片段,例如把罕见词拆成词根加词缀,模型仍能从中获得部分语义。这也解释了原文演示中 emoji 按字节拆分、常见数字序列被合并为单个 token 的现象——分词器的合并规则完全由训练语料的统计规律决定。
嵌入模型的三种类型与选型思路
课程把嵌入模型分为三代。第一代是词嵌入,代表是 Word2Vec 和 GloVe,输入单个词,输出向量。局限在于丢失上下文:「river bank」和「bank account」中的 bank 会得到同一个向量,无法区分含义。
第二代是文本嵌入,输入可以是句子、段落乃至整篇文档,因此可以直接比较两段文本的语义相似度。OpenAI、Google Gemini、Cohere 等厂商都提供这类模型,它们是语义搜索、RAG 和推荐系统的基础。
第三代是多模态嵌入,同时支持文本与图像。课程提到 Google 的 Gemini Embedding 2 支持文本、图像、视频、音频甚至 PDF 作为输入。选型逻辑很直接:纯文本场景用文本嵌入即可;如果检索对象是图文混排的 PDF,多模态嵌入才有必要。
课程还提到 Microsoft 的 CodeBird 针对代码理解做了优化,用于代码相似度与代码搜索。这提示了一个容易被忽略的点:嵌入模型正在按领域分化,通用模型未必是特定场景的最优解。
多模态嵌入的技术前提是把不同模态映射到同一个向量空间。文本编码器和图像编码器分别把句子与图片转成向量,训练目标是对齐的图文对在空间中彼此靠近、无关的图文对相互远离,典型做法是对比学习。这样做的结果是可以用文本向量去检索图片向量,也就是常说的跨模态检索。它与单纯把图片也转成向量的做法不同:后者若各模态各自独立训练,文本与图像向量处于不同空间,距离没有可比性。因此选型时除了看模型是否支持图像输入,还要确认它输出的是共享空间中的对齐向量。原文提到的图文混排 PDF 场景正依赖这一性质,否则查询文本与文档中的图片向量无法直接比较。
向量数据库内部:四层架构与两类索引
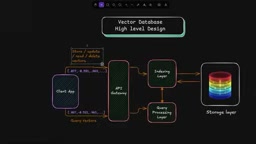
课程把向量数据库的内部结构拆为四层。API 网关是入口,对外暴露向量的增删改查与查询接口,写入(摄取阶段)和查询是两类不同操作。索引层负责组织向量以支持高效相似搜索,避免暴力扫描。存储层负责高维向量的持久化,强调快速插入、检索、删除,并通过复制保证持久性与容错,通过分区实现扩展。查询处理层接收查询向量,协调索引层与存储层,并完成过滤与排序。
索引层是性能的关键。课程重点介绍了两类近似最近邻(ANN)索引:IVF(倒排文件索引)和 HNSW(分层可导航小世界)。二者的共同目标是避开线性扫描——如果有一百万条向量,逐条比对复杂度是线性的,延迟不可接受;ANN 索引用近似换速度,在毫秒级返回结果。课程坦言会另设专门章节展开这些算法,此处只建立框架认知。
近似最近邻(ANN)搜索是向量数据库在规模与延迟之间做出的核心权衡。精确最近邻搜索需要将查询向量与库中每一条向量逐一比对,复杂度为 O(N·d),当向量数量达到百万级、维度达到数百甚至数千时,单次查询的耗时无法满足线上服务要求。ANN 的思路是放弃「一定找到全局最近的那一条」,转而以较高概率返回足够接近的结果,从而把查询复杂度降到亚线性。工程上通常用召回率(返回结果中真正最近邻所占比例)来衡量这种近似带来的损失。IVF 通过聚类把向量划分到若干倒排桶中,查询时只扫描最相关的几个桶;HNSW 则构建多层可导航图,从稀疏的顶层逐层向下贪心搜索,二者分别用「空间划分」和「图导航」两种方式绕开全量扫描。理解这一点,才能明白后文所说索引参数调优直接影响召回率与延迟的含义。
实战:用 Gemini 生成嵌入并在 ChromaDB 中语义搜索
课程的实战部分分两步。第一步在 Google Colab 中用 Gemini 嵌入模型生成向量。核心调用是 client.models.embed_content,传入模型名(如 gemini-embedding-001)、内容和配置。配置中指定输出维度为768,任务类型设为语义相似度。Gemini 嵌入模型支持128到3072维的输出,推荐维度为768、1536和3072。生成后每个句子的嵌入都是768维数组。
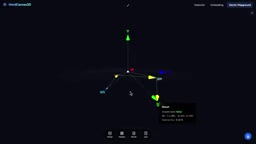
为了直观验证效果,课程用余弦相似度计算句子两两之间的相似度矩阵。结果符合预期:「如何写Python函数」与「如何在Java中创建类」相似度最高;「哪款智能手机拍照最好」与「最好的安卓手机是什么」高度相似;「关灯」与「关掉灯光」匹配。随后用 PCA 把768维降到三维做可视化,再用 Plotly 做成可交互的3D散点图,相似句子在空间中明显聚集。
第二步把嵌入存入 ChromaDB 并查询。流程是:创建 ChromaDB 客户端并设置持久化目录;用 get_or_create_collection 创建集合(类比关系库中的表);把嵌入、原始文档文本和 ID 一起写入集合。查询时有一个容易被忽略但至关重要的约束:查询向量必须用与写入时相同的嵌入模型和相同的维度生成。课程的原话是,如果模型或维度不一致,查询就无法工作——因为查询向量和库中向量必须处于同一向量空间才可比较。
演示中,查询「programming」返回了「如何写Python函数」和「如何在Java中创建类」;查询「electronics」返回了「苹果发布新iPhone」和「哪款智能手机拍照最好」。两次查询的关键词都没有出现在结果文本中,语义匹配生效。这既是语义搜索的价值,也是 RAG、推荐系统、企业知识库等应用的底层能力。
学习路径与几点提醒
课程的定位是零基础到进阶,覆盖从概念到动手的完整链路,适合软件工程师、AI 工程师和机器学习工程师。若要我补充几点实践提醒:
第一,维度选择需要在效果与成本间权衡。更高维度通常保留更多信息,但存储和计算开销同步上升,768维在多数场景已是合理起点。
第二,相似度度量的选择要贴合业务。余弦相似度适合语义检索,欧氏距离适合物理距离有意义的场景,二者不可随意互换。
第三,索引算法(IVF、HNSW)的参数调优会直接影响召回率与延迟,课程只做了概念铺垫,实际项目中需要结合数据规模做压测。
第四,ChromaDB 适合快速原型和中小规模场景,生产级大规模部署需要评估分布式、复制与分区能力。课程对存储层的复制与分区只做了原则性介绍,这块在落地时值得深入。
向量数据库已成为 AI 应用的基础设施之一,理解其内部机制,比会调几个 API 更有长期价值。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。