小显卡跑DeepSeek?GitHub热点项目让CPU和SSD分担显存压力

GitHub热点周报:Stratum分层跑MOE、DeepInfer开源、OpenCode 2.0升级等
本期GitHub一周热点围绕五个项目展开。Stratum针对千文、DeepSeek等超大MOE模型做分层推理,把常用专家留在显存、其余放到内存甚至SSD,由CPU与GPU协同计算,在12G显卡加64G内存下以每秒约4到6个Token运行DeepSeek 2.0 BPW版本,但成熟度不及LM Studio,且受存储涨价制约。DeepSeek开源推理引擎DeepInfer开放离线推理部分,涵盖专家并行、异步调度、定制Kernel与推测解码,同时支持英伟达GPU和华为昇腾950 NPU。OpenCode 2.0转向共享后台服务架构,改进diff查看体验,国内较易用上OPUS 5.5。此外还有开源人形机器人RPE和AI姿势库,以及两份行业报告。
当MOE模型装不进显存,分层计算成了新解法
大模型动辄几百GB的体积,让普通玩家的显卡望尘莫及。GitHub一周热点第136期里,一个叫Stratum的本地推理工具给出了自己的答案:把经常用到的专家留在显存,其余的搬到内存,让CPU和GPU分摊计算,甚至把大查找表放到SSD上。
这并非简单的offload。Stratum的重点适配对象是千文3.8 Flash、Next以及DeepSeek广告 V4.1 Flash这类超大MOE模型。它的做法是把CPU变成专家计算的参与者——CPU和GPU上的部分专家同时计算,再把结果汇合进入下一层。显存里的专家名单还会动态变化,工具会统计调用情况,把近期更常用的专家挪进显存。
从项目公布的数据看,DeepSeek 2.0 BPW版本在12G的5070显卡、64G内存的配置下,每秒大约输出6到4个Token。这个速度谈不上流畅,但至少让"小显卡跑大模型"从不可能变成了可以折腾。作者也坦言,今年内存和SSD的涨价非常夸张,想走这条路线的玩家需要先掂量一下存储成本。
和Ollama、LM Studio的差异化在哪
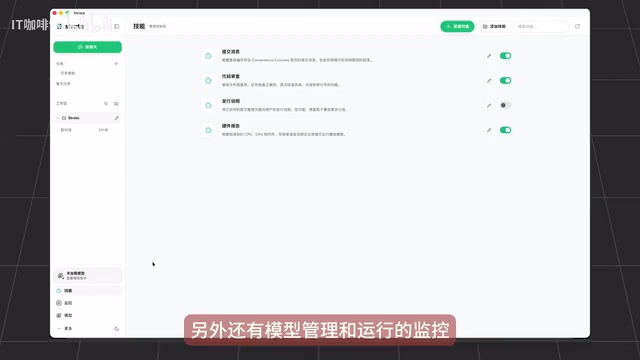
已经有Ollama和LM Studio,为什么还要再装一个Stratum?这个问题绕不开。作者的实际体验是,Stratum在聊天、文件处理、本地API这些基础能力上并没有独有优势,成熟度上反而不如LM Studio。它的差异集中在两点:对少数超大MOE模型的专门适配,以及把运行和工作流混合到一起的界面设计。
使用层面,Stratum提供桌面APP和终端版本。首次启动有引导选择模型和配置,会自动下载模型,但默认下载线路的速度被作者评价为"基本下不动"。另一个需要注意的细节是,桌面APP里没有看到DeepSeek,想跑DeepSeek得用终端版本。对于经常在不同模型间切换的用户,迁移到这个工具的必要性并不大。
MOE(混合专家)模型是理解本文的关键前提。传统稠密模型每处理一个Token都要激活全部参数,而MOE把前馈网络拆成多个“专家”子网络,并由一个门控网络为每个Token只挑选少数几个专家参与计算。这样模型总参数量可以做到几百GB甚至更大,但单次推理实际用到的参数远小于总量。问题在于,所有专家权重仍需存放在某处,显存装不下就得放到内存或SSD,这正是Stratum要解决的矛盾。MOE的稀疏激活特性也解释了为何“按需调度专家”在工程上可行:只有被门控选中的专家才需要参与当轮计算。
**BPW(Bits Per Weight)**是量化领域的常用指标,表示平均每个权重占用多少比特。文中“DeepSeek 2.0 BPW版本”指把模型量化到平均每权重约2比特,相比FP16的16比特可把体积压缩到约八分之一,代价是精度和输出质量会有一定损失。极低BPW是让小显存跑超大模型的前提之一,但它与分层调度是两套独立手段:量化降低总体积,分层解决峰值占用。
DeepSeek开源推理引擎,昇腾成为一等公民
第二个项目DeepInfer来自DeepSeek,是DeepSeek V4.1 Flash背后的推理引擎。它包含MOE专家并行、异步Batch调度、定制Kernel和推测解码等核心技术。DeepSeek披露的数据显示,单个集群每天处理约155万个Token,如此庞大的流量下,GPU在每轮计算中哪怕浪费一点资源,累积起来都非常可观。
目前DeepInfer开放的是离线推理部分,存储和跨部分负载均衡等内容尚未完全公开。项目把此前大家熟悉的Flash LMA、DPEP等底层优化串联了起来。硬件支持上出现了两条路径:英伟达GPU和华为昇腾950 NPU。昇腾这次成为支持的第一等公民,说明DeepSeek在国产化支持上加大了投入。
对模型服务、推理优化和算力平台方向的人来说,这个项目有实际参考价值;普通用户更多是看个热闹。作者在视频里评价,DeepSeek在开源上的持续投入,让它成为AI圈里真正意义上的OpenAI。
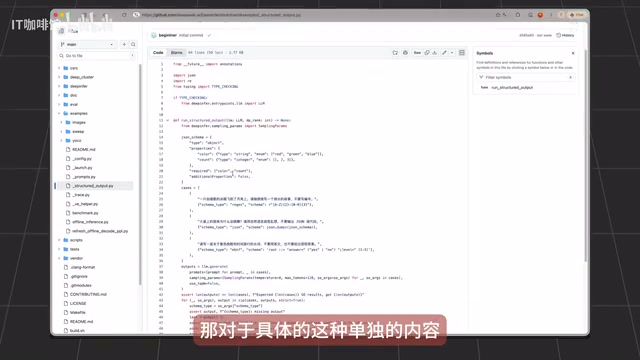
**推测解码(Speculative Decoding)**是DeepInfer提及的核心技术之一。它先用一个小而快的“草稿模型”连续生成若干候选Token,再由大模型一次性并行校验这些候选,接受其中正确的部分。由于大模型的一次前向可以验证多个Token,在输出分布不变的前提下能显著提升解码吞吐,尤其适合显存带宽受限、单Token生成昂贵的场景。
MOE专家并行则是指把不同专家分布到不同GPU或NPU上,门控选中哪个专家就由持有该专家的设备计算,再通过通信汇聚结果。它带来负载不均和跨设备通信两大挑战,需要配合调度策略才能避免部分设备空转。文中“异步Batch调度”正是为掩盖这类通信与计算气泡而设计。
昇腾NPU是华为的AI加速芯片,软件栈为CANN,与英伟达的CUDA生态相互独立。一个推理引擎要支持昇腾,需要重写Kernel并适配其算子库,因此“一等公民”意味着昇腾不是事后补丁,而是与GPU并列的正式支持路径。
OpenCode 2.0:从编程Agent到可扩展客户端平台
OpenCode是一个可以接入不同模型的开源编程Agent,随着2.0版本升级又迎来一波热度。终端用户执行OpenCode Upgrade-major即可升级,APP用户建议直接下载新版。2.0默认由一套共享后台服务管理会话、配置、权限和工具执行,本地客户端则连接各个服务,用户可以用完整终端界面、精简操作界面或APP。
对开发者来说,统一的服务端意味着可以开发自己的客户端。围绕代码体验的改进也很具体:终端加入了侧面的diff查看,桌面端能按轮次查看改动文件的行数和差异,agent写完代码后检查起来更直观。最新的2.2版本还加入了桌面插件等实验性内容。
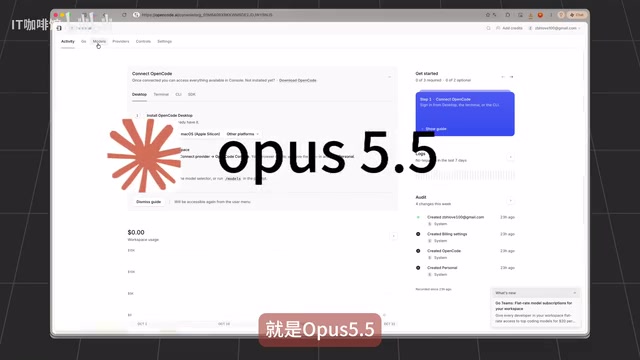
OpenCode受关注的另一个原因是OPUS 5.5。在国内使用OPUS 5.5的多种方式中,OpenCode相对容易上手,支付还支持支付宝。老用户升级需要注意兼容性:旧的插件实现不能直接在V2里跑,调用旧服务和接口的集成也要做改动。
编程Agent指能自主读写代码库、执行命令、运行测试并根据结果迭代的AI系统,与只做补全的代码助手不同,它具备多轮工具调用能力。OpenCode 2.0把会话、配置、权限和工具执行收敛到共享后台服务,实际上是把Agent运行时与界面解耦:客户端只负责展示与交互,服务端统一管理状态与工具执行权限。这种架构让同一套Agent能力可以被终端、精简界面和APP复用,也为第三方开发自有客户端留出接口。需要注意的是,服务端集中管理权限意味着工具调用的安全边界从客户端转移到了服务进程,升级时旧插件与旧接口不兼容,本质上是这次架构迁移的代价。
开源人形机器人RPE:把导航页做厚
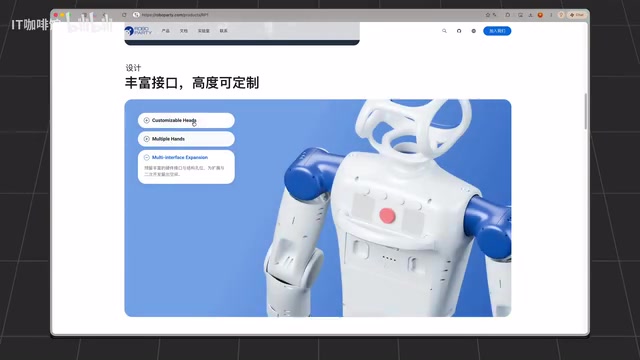
RPE来自Robot Party,是一个开源机器人项目。机器人开源值得关注的核心问题是:到底开放了多少,别人能不能沿着这些资料继续做下去。RPE把机械、电器、关节、固件、部署和学习相关内容整理到同一个入口,硬件仓库里有原文件、可编辑图纸、整机模型、PCB生产资料,软件侧有机器人描述、底层接口、部署框架等组件。
比较合理的上手路线是先看机器人模型和配置,然后在仿真和训练环境里研究动作,再按部署说明连接真实硬件。作者也指出,这个仓库更像一个导航页,具体支持哪个机器人配置、代码长什么样,还要回到各个子仓库确认。对机器人团队和实验室来说,这种组织方式比较实在。此前Hugging Face和一些海外机器人公司开源过几款机器人,国内也逐渐有了开源内容。
AI姿势库与两份行业资料
最后一个项目是AI Pose Gallery中文版,适合做AI绘画、角色设计和摄影参考的用户。它基于一个日本源站做了中文化和素材镜像,支持关键词搜索,可以按动作和正面、侧面、俯视等视角筛选,也能按姿势分组切换构图。相关原图可以下载后拿到AI工具里进行创作。作者部署了在线版本,也可以把整个项目克隆到本地,拥有内网浏览的静态版本。这类小资料库很实用,但素材和代码的版权问题需要留意。
视频最后分享了两份资料。一份是中国信通院和中国人工智能产业发展联盟的端侧智能产业发展报告2026,从芯片、存储、基础软件到模型和应用,讨论AI如何在资源有限的设备上稳定运行,并梳理了办公、出行、家庭和机器人等场景。另一份聚焦AI如何改变消费者购物与电商经营模式,观察购物入口从搜索推荐向agent管理筛选商品和执行交易的演变。
这期热点透露的三个信号
第一个信号是本地推理正在从"能不能跑"转向"怎么跑得划算"。Stratum用CPU、内存、SSD分摊显存压力的思路,本质是在硬件成本高企的现实下寻找工程折中。第二个信号是国产算力在推理框架中的地位上升,昇腾成为DeepSeek推理引擎的一等公民是一个明确表态。第三个信号是开源机器人和AI创作素材库的积累,前者面向团队和实验室,后者面向个人创作者,都在把零散资源整理成可复用的入口。
对这些项目感兴趣的话,Stratum适合有大内存和充足SSD空间的玩家折腾,DeepInfer适合推理优化从业者研究,OpenCode适合想低成本用上OPUS 5.5的开发者,RPE适合机器人团队按子系统深入。
相关推荐

本地模型为何在Doom游戏决策中击败Jev AI API?
YouTube视频对比显示,本地模型GLiNER在Doom游戏中以12毫秒响应和8.8次/秒决策频率,大幅超越Jev AI API的2.5次/秒,得分翻倍。

Screen Studio 4.0 发布:玻璃放大镜、摄像头抠像与文本式剪辑
Screen Studio 4.0 发布,带来玻璃放大镜、文本式剪辑、摄像头抠像等新功能,并提升导出性能。这款 Mac 屏幕录制工具在 Product Hunt 排名第一,致力于简化视频制作流程。

ClawsGO Science:自带云端实验室的AI科研智能体
ClawsGO Science 是 Product Hunt 上线的 AI 科研智能体,自带云端实验室,集成 500+ 工具和 90+ 数据集,可调度 Claude 与 GPT 智能体集群连续运行数天,从提问自动生成带引用的论文。