小语言模型知道自己不知道什么吗?语义熵是关键

研究证明小语言模型的token级熵几乎失效,而语义熵可恢复有效置信度信号并驱动智能路由提升准确率。
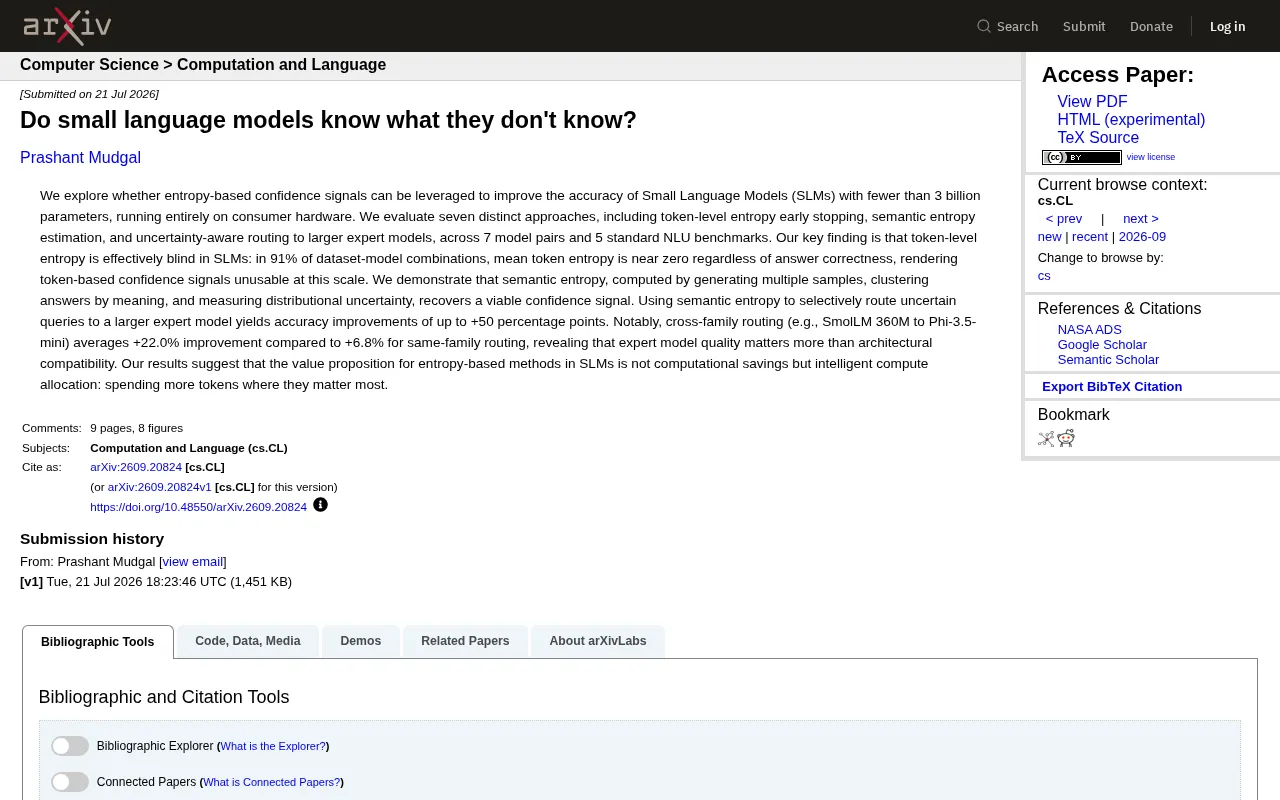
这项arXiv研究系统评估了七种基于熵的置信度信号方法在参数量低于30亿的小语言模型(SLM)中的实际效果。最核心的发现是:token级熵在91%的测试组合中均接近于零,无法区分正确与错误答案,直接将大模型中的熵估计方法迁移到SLM会完全失效。相比之下,语义熵通过多次采样、语义聚类再计算分布不确定性的方式,成功恢复了有意义的置信度信号。基于语义熵将低置信查询路由给更大专家模型的策略,准确率最高可提升50个百分点,且跨模型家族路由(+22.0%)远优于同家族路由(+6.8%),说明专家模型自身的能力比架构相似性更关键。研究的最终结论是:熵方法在SLM场景下的价值不是降低算力消耗,而是实现智能的算力分配——让小模型处理有把握的问题,将难题交给更强的模型。
核心问题:SLM 能否感知自身的不确定性
参数量小于 30 亿的小语言模型(Small Language Models, SLM)正因其能够完全运行在消费级硬件上而备受关注。但一个关键问题始终存在:这些模型是否知道自己“不知道”什么?换句话说,当 SLM 给出一个错误答案时,它能否通过某种信号提前意识到自己缺乏把握?
这篇来自 arXiv 的研究(arXiv:2609.20824v1)系统性地探讨了这一问题。研究团队测试了七种基于熵(entropy)的置信度信号方法,涵盖 token 级熵早停、语义熵估计、以及基于不确定性的专家模型路由等策略,覆盖 7 组模型配对和 5 个标准自然语言理解(NLU)基准测试。
关键发现一:Token 级熵在小模型中几乎失效
研究最重要也最反直觉的发现是:在小语言模型中,token 级熵基本是“失明”的。
在 91% 的数据集-模型组合中,无论答案正确与否,平均 token 熵都接近于零。这意味着模型在生成每个 token 时都表现得非常“自信”,即使它给出的是错误答案。这种一致性使得基于 token 熵的置信度信号在这一规模上完全不可用。
这一结论对不少工程实践具有警示意义。在大模型场景中,token 熵常被用作衡量生成不确定性的廉价指标,但直接把这套方法迁移到 SLM 上会得到毫无区分度的信号——模型对错误答案同样“斩钉截铁”。
关键发现二:语义熵重新找回可用信号
既然逐 token 的熵不管用,研究者转向了语义熵(semantic entropy)。其计算方式是:对同一问题生成多个采样答案,按含义对答案进行聚类,再测量这些聚类的分布不确定性。
这种方法的核心思路在于,不去关注模型对单个 token 的确定程度,而是观察它在多次生成中是否给出语义一致的答案。如果模型对同一问题反复给出意义相近的回答,说明它较有把握;如果答案在语义上四散分布,则暴露了真正的不确定性。
实验证明,语义熵成功恢复了一个可用的置信度信号,弥补了 token 级熵的盲区。代价是需要多次采样、消耗更多计算,但换来了有意义的判断能力。
语义熵(Semantic Entropy)最初由 Kuhn 等人于 2023 年在 NeurIPS 提出,旨在解决"语言表达多样性"与"语义一致性"之间的割裂问题。传统 token 级熵只关注词汇表上的概率分布,即便模型以不同措辞表达同一意思(如"巴黎"与"法国首都"),也会被视为不同的输出而拉高熵值,产生虚假的不确定性信号。语义熵的解决思路是:先对多次采样的答案用自然语言推理(NLI)模型进行语义等价性判断,将意义相同的答案归入同一聚类,再在聚类层面计算熵。这样,模型用不同话语表达同一事实所带来的表面多样性就被过滤掉,留下的才是真正反映模型认知不确定性的信号。这一方法的计算开销主要来自多次前向推理采样以及 NLI 判断,对算力受限的边缘场景是不可忽视的成本。
关键发现三:不确定性路由带来最高 +50 个百分点提升
有了可用的置信度信号,研究团队进一步验证了它的实际价值:将语义熵判断为“不确定”的查询,选择性地路由给更大的专家模型处理。
这一策略带来了显著的准确率提升,最高可达 +50 个百分点。也就是说,让小模型处理它有把握的问题,把拿不准的问题交给更强的模型,整体效果大幅改善。
更有价值的细节在于跨模型家族的对比:
- 跨家族路由(如 SmolLM 360M 路由到 Phi-3.5-mini)平均提升 +22.0%
- 同家族路由平均提升仅 +6.8%
这一差距揭示了一个重要结论:专家模型的质量比架构兼容性更重要。换句话说,为不确定的查询选择一个真正更强的模型,比选择一个“血缘相近”的模型收益大得多。
重新理解熵方法在 SLM 中的价值定位
这项研究最终重新定义了熵方法在小语言模型中的意义。它的价值主张并非节省计算,而是智能的算力分配——把更多的 token 花在最需要的地方。
这一视角对边缘部署和端侧 AI 具有现实指导意义。在消费级硬件上运行 SLM 时,与其追求单纯的省算力,不如构建一套“小模型兜底、大模型救场”的分级推理体系:
- 大多数简单查询由 SLM 本地快速处理;
- 通过语义熵识别出模型缺乏把握的难题;
- 仅将这部分查询上交给更强的专家模型。
这种混合架构既保留了小模型的效率优势,又在关键问题上借助大模型保证准确率,是本地化 AI 应用值得借鉴的设计范式。
小结
回到最初的问题——小语言模型知道自己不知道什么吗?答案是:用错误的方法(token 熵)问,它一无所知;用正确的方法(语义熵)问,它其实心里有数。这项研究不仅揭示了 SLM 置信度信号的真实面貌,也为端侧 AI 的分级推理设计提供了坚实的实证依据。
背景补充
**熵(Entropy)**在信息论中衡量概率分布的不确定程度:分布越均匀,熵越高;分布越集中于某一结果,熵越低。在语言模型生成文本的过程中,每一步都会输出一个覆盖全词汇表的概率分布——若模型对下一个 token 胸有成竹,该分布会高度集中,对应的 token 级熵接近零;若模型举棋不定,分布趋于均匀,熵值随之升高。理论上,熵可以作为模型"自信程度"的廉价代理指标,无需额外标注数据或训练额外的打分网络,只需读取推理过程中已有的 logits 即可计算,这也是它在大模型不确定性估计领域被广泛采用的根本原因。
相关推荐
Asana AI产品负责人分享AI Agent最佳实践
Asana AI产品负责人分享AI Agent最佳实践,涵盖职责边界设定、人在回路设计、数据模型锚定以及评估迭代方法,为产品团队落地Agent提供可参考的原则。
日本互联网巨头GMO遭黑客泄密:云服务漏洞致客户数据外泄
日本GMO Internet证实云服务遭黑客攻击,客户数据疑被公开。公司正核实泄露数据真实性,事件凸显云服务安全风险与供应链攻击威胁。

苹果为Pages、Keynote、Numbers加入AI助手
苹果为Keynote、Pages、Numbers引入AI助手,基于苹果与OpenAI模型,可理解文档上下文,在Keynote中设计动画幻灯片、在Pages中起草和重构文档,生产力套件AI竞争升级。