校准后再路由:分离式LLM服务的智能请求调度研究
硬件校准是学习型LLM路由器发挥效果的前提,校准后可用6块GPU替代7块GPU完成同等服务。
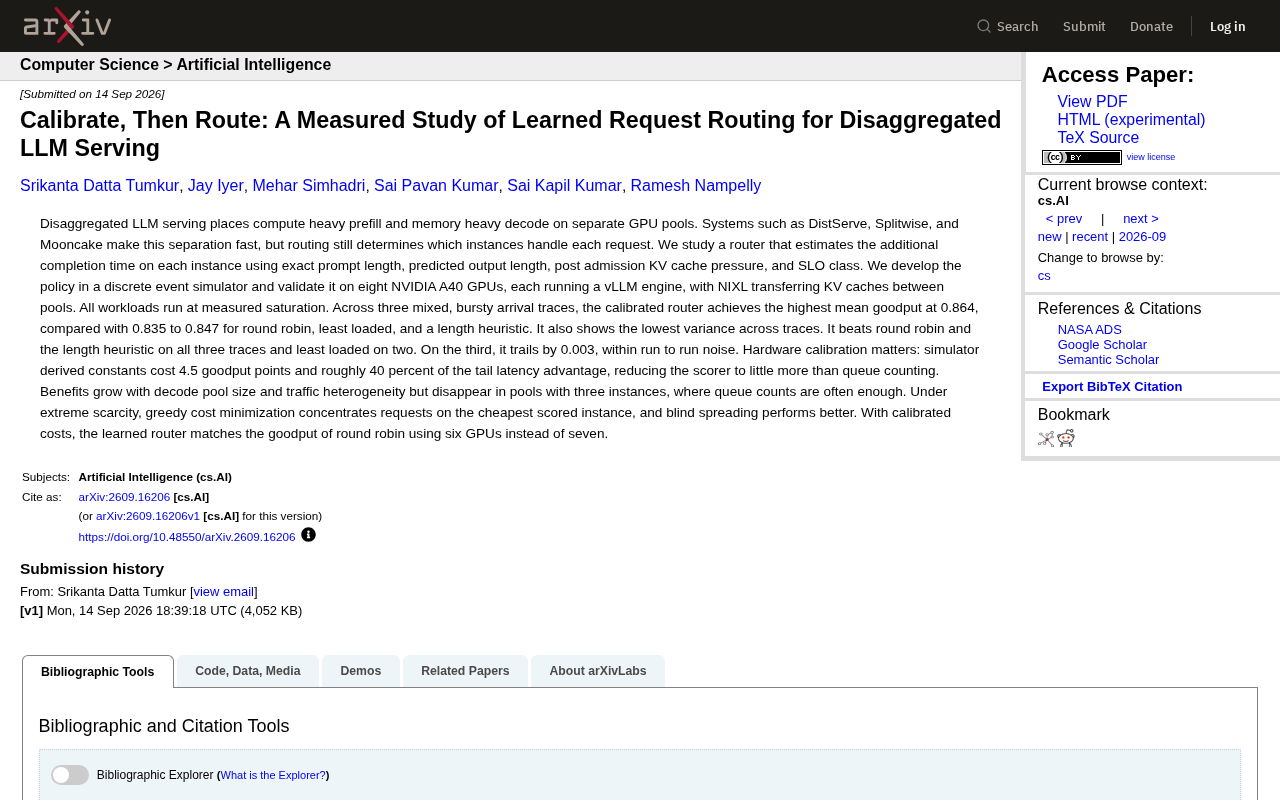
《Calibrate, Then Route》针对预填充/解码分离式LLM推理架构中的路由问题,提出了一种基于成本估算的学习型路由器,综合考量输入长度、预测输出长度、KV缓存压力和SLO分类来决定请求分配。在8块A40 GPU的真实硬件测试中,校准后的路由器取得0.864的最高平均goodput,优于轮询等基准方法。研究最核心的发现是:硬件校准不可或缺——跳过校准会损失4.5个goodput点和约40%的尾延迟优势,使智能路由退化为普通队列计数。路由收益随解码池规模和流量异质性增长,但在小规模池中或资源极度稀缺时可能失效。最具说服力的工程结论是:经过校准的路由策略可以用6块GPU达到轮询策略需要7块GPU才能实现的吞吐,即在同等服务质量下节约约14%的GPU投入。
分离式LLM服务的路由难题
大模型推理服务正在经历架构层面的重构。为了应对预填充(prefill)阶段计算密集、解码(decode)阶段内存密集的矛盾特性,业界提出了分离式部署方案——将这两个阶段分别放置在独立的GPU资源池上。DistServe、Splitwise、Mooncake 等系统已经把这种分离做得足够快,但一个关键问题仍然悬而未决:当请求到达时,究竟应该由哪个实例来处理?
这正是路由(routing)策略要解决的核心问题。一篇新发布的 arXiv 论文《Calibrate, Then Route》针对这一环节展开了系统性的实测研究,提出了一个基于成本估算的学习型路由器,并在真实硬件上验证了它的效果。
预填充(prefill)阶段负责处理用户输入的所有 token,执行一次大规模的矩阵并行计算,属于算术密集型任务,对 GPU 计算吞吐量敏感;解码(decode)阶段则逐个自回归地生成输出 token,每步只计算一个 token,但需要反复读取所有已生成 token 的 KV 缓存(Key-Value Cache),属于内存带宽密集型任务。这两种截然不同的硬件需求导致在同一实例中混跑时相互干扰:预填充会阻塞解码的进行,造成"首 token 延迟"(Time To First Token, TTFT)和"逐 token 延迟"(Time Per Output Token, TPOT)同时恶化。分离式部署通过将两类任务分配给不同的 GPU 资源池,使各自的硬件配置和批处理策略能够独立优化,从而在整体上提升推理效率与服务质量。
路由器如何做决策
论文的核心思路是让路由器估算每个实例上的"额外完成时间"(additional completion time),并据此做出分配决策。这个估算综合了四个维度的信息:
- 精确的提示词长度:请求输入的 token 数是已知的确定值
- 预测的输出长度:解码阶段会产生多少 token 需要预测
- 准入后的 KV 缓存压力:请求进入后对显存缓存的占用情况
- SLO 分类:请求所属的服务等级目标类别
这套方法本质上是把路由从简单的负载均衡(如轮询、最少负载)升级为对每个请求真实成本的建模。研究者先在离散事件模拟器中开发出该策略,再迁移到真实硬件上验证——这种"先仿真、后实测"的方法论本身就是研究的亮点之一。
真实硬件上的实测表现
验证环境相当扎实:八块 NVIDIA A40 GPU,每块运行一个 vLLM 引擎,资源池之间通过 NIXL 传输 KV 缓存,所有工作负载都跑在实测的饱和状态下。
在三条混合的、突发式的到达流量轨迹(bursty arrival traces)测试中,校准后的路由器取得了 0.864 的最高平均有效吞吐(goodput),而轮询、最少负载和长度启发式方法的成绩在 0.835 到 0.847 之间。更重要的是,校准路由器在不同轨迹间的方差最低,意味着它的表现更稳定可预测。
具体到每条轨迹:它在全部三条轨迹上都击败了轮询和长度启发式方法,在两条轨迹上超过了最少负载策略。仅在第三条轨迹上以 0.003 的微小差距落后于最少负载——而这个差距完全落在运行间噪声(run-to-run noise)范围内。
论文中使用的 goodput(有效吞吐)是衡量 LLM 服务质量的关键指标,定义为在满足 SLO(服务等级目标,Service Level Objective)约束条件下成功完成的请求比例或吞吐量。与原始 throughput 不同,goodput 会将超出延迟预算的请求视为"失败"而不计入有效输出,因此能同时反映系统的处理速度和服务质量达标率。NIXL 是 NVIDIA 提供的低延迟 KV 缓存传输库,专为分离式推理场景设计,用于在预填充实例完成计算后将 KV 缓存高效地搬运到解码实例,传输延迟直接影响端到端请求完成时间。在分离式架构中,KV 缓存的传输开销是整体性能的重要瓶颈之一,也是路由决策必须纳入考量的成本维度。
硬件校准为何如此关键
这项研究最值得深思的发现是:硬件校准(hardware calibration)决定成败。
如果直接使用模拟器推导出的常数,而不做真实硬件校准,路由器会损失 4.5 个 goodput 点,以及大约 40% 的尾延迟优势。此时的成本评分器几乎退化成了单纯的"队列计数"——也就是说,没有校准的智能路由和最朴素的负载均衡没有本质区别。
这个结论对工程实践有直接启示:学习型路由的价值不在于算法本身有多复杂,而在于它能否准确反映底层硬件的真实行为。脱离硬件的理论最优在生产环境中会大打折扣。
收益边界:什么时候该用,什么时候别用
论文诚实地划出了这套方法的适用边界,这比单纯宣传优势更有参考价值。
收益随规模和异质性增长:解码池越大、流量越异质(heterogeneity 越高),校准路由器的优势越明显。但在只有三个实例的小池子里,收益基本消失——因为此时简单的队列计数往往就足够好了。
极端稀缺场景反而失效:在资源极度紧张时,贪婪的成本最小化策略会把请求集中堆到评分最低(最便宜)的那个实例上,反而不如"盲目分散"(blind spreading)的效果。这提醒我们,成本驱动的贪婪策略在饱和边缘会出现反直觉的失灵。
流量异质性(heterogeneity)在这里指同一时间段内不同请求在输入长度、预期输出长度和 SLO 要求上的差异程度。当所有请求高度相似时,简单轮询已经能实现近似均匀的负载分布,智能路由的边际价值有限;而当长短请求、宽松与严格 SLO 的请求混杂到达时,不同实例的队列状态会因偶然的分配差异而迅速分化,此时准确的成本建模才能发挥作用,把高成本请求与低成本请求合理错开,避免雪崩式堆积。这也解释了为什么论文选择"突发式到达轨迹"(bursty arrival traces)作为测试场景——突发流量天然制造负载不均,是最能放大路由策略差异的测试条件。
最实在的价值:省下一块GPU
对成本敏感的部署者来说,论文给出了一个极具说服力的结论:使用经过校准的成本模型,学习型路由器只需 六块 GPU 就能达到轮询策略用七块 GPU 的 goodput。
换算成生产环境,这意味着在同等服务质量下减少约 14% 的 GPU 投入。对于动辄部署成百上千张卡的大规模 LLM 服务而言,这种由软件路由带来的硬件节省是实打实的成本优化。
结语
这项研究的意义不止于提出一个更好的路由算法,更在于它用严谨的实测方法揭示了一条务实的工程原则:先校准,再路由。智能路由的收益是真实的,但它高度依赖对硬件的准确建模,并且只在特定规模和流量条件下才划算。对于正在构建或优化分离式 LLM 服务的团队来说,这份"有分寸"的研究提供了一份难得的实践指南。
相关推荐
Claude挑战循环真相:Wayfinder技能修复AI一次构建应用
解析Claude挑战循环(Challenge Loop)的运作原理与两大致命缺陷,以及如何用Matt Pocock的Wayfinder技能生成可验证规格文件,让AI代理一次性构建真实项目而非仅限游戏演示。
Claude Code 令牌耗尽?7个隐藏消耗点审计与修复指南
Claude Code 总是提前撞上令牌限制?本文拆解 Token 复合增长的底层机制,梳理从 /clear 到定时任务的七个隐藏消耗点,并澄清短提示、压缩、截图等无效省钱建议,附实用自查命令与审计方法。
MiniMax H3实测:3步采样打造整首歌口型同步MV
一位创作者用MiniMax H3 Extender制作整首歌口型同步MV的完整实测:音频切片、htdemucs人声隔离、fully_copy保留语法、3步turbo LoRA提速,附三款LoRA对比与自动化质检方案。