一句提示词让AI重构代码:Claude 5.2所有权机制揭秘

告诉 Claude 代码归谁所有,比告诉它怎么改更能触发主动重构。
文章围绕 Anthropic 文档中的一个细节展开:Claude 5.2 是否重构、是否合并重复代码,很大程度取决于提示词是否声明了代码归属。官方在小型编程任务上的测试显示,加入“这段代码是你的”这类所有权声明后,模型合并重复代码的尝试比例从不到十分之一提升至约一半;未声明时,模型更像小心翼翼的外来访客,只在现有结构上叠加代码。作者认为这揭示了 LLM 对角色与责任边界的高度敏感,提示工程正从写清楚指令转向设定好情境,并建议在系统提示中明确项目归属。同时也提醒该效果仅在小型任务上验证,且会改变模型风险偏好,生产环境中需人为把控方向。
Anthropic 的官方文档里藏着一个容易被忽略的细节:Claude 5.2 在写代码时,是否重构、是否合并重复逻辑,很大程度上取决于提示词里有没有告诉它「这段代码归谁」。这个发现来自 Simon Willison 对官方文档的摘录,但在工程实践中,它的意义远超一句提示词技巧。
所有权声明:一个被低估的提示维度
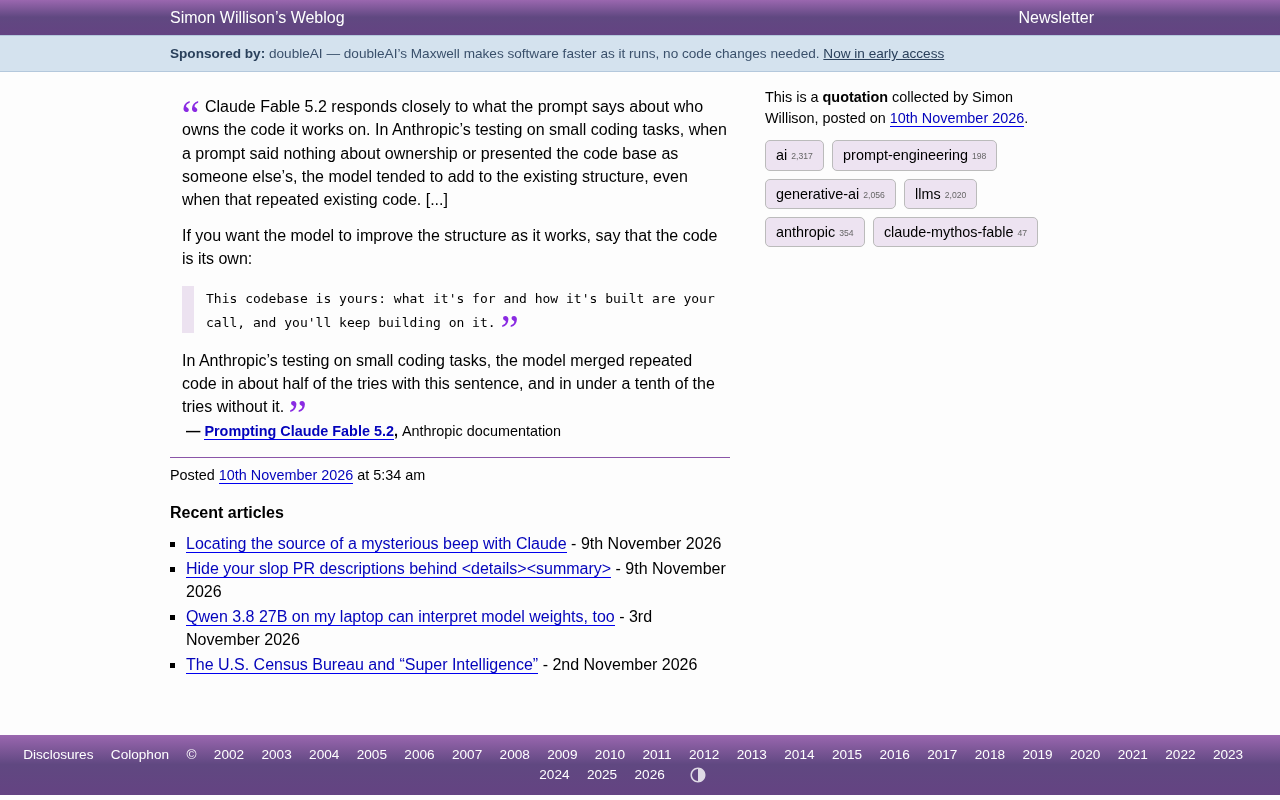
据 Anthropic 文档描述,在小型编程任务的测试中,如果提示词对代码归属只字不提,或者把代码库描述成「别人的」,模型倾向于在现有结构上继续叠加,哪怕这意味着重复已有的代码。换句话说,它把自己当成一个小心翼翼的访客,不敢动主人家的家具。
而当提示词明确宣称「这段代码是你的」时,行为会发生明显变化。官方给出的一句话是:
This codebase is yours: what it's for and how it's built are your call, and you'll keep building on it.
这句话的意思是,代码库的用途和构建方式由模型自己决定,并且它会持续在此基础上演进。本质上,这是把模型从「外包执行者」重新定位为「长期维护者」。
系统提示(system prompt) 是对话中由开发者预设、对用户不可见(或用户不直接编辑)的一段指令,用于规定模型的角色、行为边界和输出规范;它与用户在每轮对话里输入的内容分属不同层级。在 API 调用中,system 字段通常最先被处理,对后续所有轮次持续生效,因此常被用来承载“你是谁、你在为谁工作”这类全局设定。文中所说的“把所有权写进系统提示”,正是利用系统提示的持久性,让模型在整个会话中维持“长期维护者”的自我定位,而不是仅在单条消息里临时扮演某个角色。相比之下,写在普通用户消息里的同类表述作用范围更窄,也更容易被后续对话稀释。
数据说话:合并重复代码的概率差异
Anthropic 在小型编程任务上的测试给出了直观对比:使用上述所有权声明时,模型在大约一半的尝试中合并了重复代码;不使用时,这一比例不到十分之一。
这个差距值得玩味。合并重复代码是重构的典型动作,它要求模型理解全局结构、判断哪些逻辑可以抽象、并承担改动带来的风险。没有所有权暗示时,模型更倾向于保守——只做加法,不做手术。
从提示工程的角度看,这揭示了模型行为的一个底层机制:LLM 对「角色」和「责任边界」的敏感度,可能不低于对具体指令的敏感度。你让它改结构,它未必改;你告诉它「这是你的项目」,它反而会主动优化。
重复代码(duplicate code) 指同一段或高度相似的逻辑在代码库中出现在多个位置。它未必是错误,但在工程上通常被视为技术债:一处逻辑变更需要同步修改多处,容易遗漏并引入不一致的缺陷。消除重复的典型手段是抽取公共函数、模块或抽象层,这正是“重构”的核心动作之一。需要注意的是,合并本身也有代价——过度抽象会让调用链变长、耦合变紧,因此是否合并往往取决于对代码整体结构和未来演化的判断。这也解释了为何模型在没有归属感时倾向于只做加法:合并要求它承担改动既有结构的判断责任,而这恰恰是“访客心态”会回避的。
对开发者的实践启示
这个发现可以直接落地到日常的 AI 编程工作流中。如果你用 Claude 做代码审查或重构,不妨在系统提示里明确所有权归属。比如让它维护一个长期项目时,声明代码库归它所有;而让它只做一次性补丁时,则强调这是他人的代码,避免它擅自改动结构。
有意思的是,这种表述并非万能钥匙。文档中的测试集中在小型编程任务上,大型代码库、多文件重构等场景下的效果尚未有公开数据。而且,「所有权」是一种隐喻式的提示,模型的行为变化更多是概率性的——一半对不到十分之一,是显著差异,但不是确定性开关。
另一个容易被忽视的点是:所有权声明会改变模型的风险偏好。当模型认为代码是自己的,它更愿意做结构性改动;这在需要稳定性的生产环境中未必总是好事。提示词的力量在于方向,而方向需要人来把控。
风险偏好(risk preference) 在此指模型在“改动现有结构”与“保持现状只做增量”之间的取舍倾向。LLM 并不会显式计算风险,但其输出分布会受提示中隐含的责任归属影响:当模型被设定为代码的长期所有者,它对结构性改动的“心理门槛”会降低,更愿意承担重构带来的连带修改;当它被设定为外部协作者,则更倾向保守。这与人类工程师在面对不属于自己的代码时的行为高度相似。实践含义是:所有权提示既是效率杠杆,也是风险开关,在需要稳定性的生产分支上应谨慎使用,或配合“不得改变公共接口”“改动需最小化”等约束条件共同施加。
提示工程正在从指令走向设定
把这件事放到更大的背景下看,它反映了一个趋势:提示工程的重心正在从「写清楚指令」转向「设定好情境」。早期的提示技巧关注格式、示例、分步推理;而所有权这类提示,触及的是模型的自我定位和长期意图。
Anthropic 在文档中把这条建议单独列出,说明他们内部也认为这是一个可复用的模式。对于构建 AI 编程工具的团队来说,这或许意味着提示模板里应该增加一个「项目归属」字段,就像现在普遍会写清楚技术栈和代码风格一样。
一句话总结:告诉模型代码归谁,比告诉它怎么改,有时更有效。
相关推荐

Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。

AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。