英伟达129亿收购Hugging Face:开源AI的终极博弈
一桩改写开源AI格局的收购
据报道,英伟达已同意以 129亿美元 收购 Hugging Face——这家被誉为「AI 界瑞士」的开源模型托管平台。这笔交易还打包了 llama.cpp,也就是让 AI 模型能在英伟达并不销售的硬件(Mac、AMD 显卡、纯 CPU)上运行的推理引擎。
llama.cpp 由保加利亚工程师 Georgi Gerganov 于2023年3月发布,最初仅用数百行C/C++重现了Meta LLaMA模型的推理逻辑。它的突破在于引入了GGUF量化格式——量化(Quantization)是将模型权重从高精度浮点数(如FP16/FP32)压缩为低精度整数(如INT4/INT8)的技术,GGUF在文件头中内嵌了模型的完整元数据(包括分词器配置、模型架构参数和量化方案),使得单个文件即可自描述地完成推理,无需额外配置文件。常见的量化级别如Q4_K_M能将一个70亿参数模型从14GB压缩至约4GB,同时保持90%以上的基准测试分数。这种"够用就好"的精度换内存策略,将原本需要数十GB显存的模型压缩至消费级硬件可承载的水平。Metal 后端适配了苹果M系列芯片的统一内存架构(UMA)——由于CPU和GPU共享同一块物理内存,模型权重无需在不同内存空间之间搬运,消除了传统架构中的数据拷贝瓶颈,让Mac用户能以接近GPU的速度运行70亿参数模型。Vulkan 后端则基于Khronos Group维护的跨平台计算API,覆盖了AMD、Intel、高通及各类移动GPU,在Windows、Linux和Android上构建了绕过CUDA的完整推理通路。这一项目彻底打破了"本地AI需要英伟达显卡"的假设,催生了Ollama、LM Studio等一批本地AI工具生态。
讽刺的是,今年 2 月,Georgi Gerganov 和 llama.cpp 团队刚刚加入 Hugging Face,为本地化 AI 找到一个「稳定的家」。加入Hugging Face给了团队稳定薪资和基础设施资源,但也引入了新的依赖——雇主的战略优先级。仅仅六个月后,这个家就即将被卖给英伟达。这究竟意味着开源的终结,还是另一场更深层的博弈?
有一个细节值得玩味。今年 1 月《金融时报》曾报道,Hugging Face 拒绝了英伟达 5 亿美元的投资,理由是「不希望单一大投资者影响其决策」。而现在,它却把整家公司以当初拒绝金额的 26 倍卖给了同一个投资者。创始人 Clément Delangue 多年来一直称 Hugging Face 是「AI 界的瑞士」——但瑞士本不该被出售。
英伟达买的到底是什么?
Hugging Face 成立于2016年,最初是一家聊天机器人公司,2019年转型为开源AI平台。它的商业模式类似于GitHub之于代码托管——提供免费的开源模型托管和社区功能,同时通过企业版Hub、推理API(Inference Endpoints)和AutoTrain等付费服务变现。其Hub采用Git LFS(Large File Storage)协议管理大型模型文件,模型的版本控制、协作和分发都遵循开发者熟悉的Git工作流。平台的网络效应极为显著:模型发布者选择Hub是因为用户在那里,用户留在Hub是因为模型在那里。这种双边市场的锁定效应,使得即便底层文件可以自由复制,平台的聚合价值仍然难以替代。
很多人以为 Hugging Face 的核心价值是它托管的 300 万个模型和 100 万个数据集。但这些文件恰恰是最不值钱的部分。真正让开发者离不开的,是它的库栈(library stack):
- Transformers:全球一半 AI 教程的起点,每天被安装超过 300 万次。该库于2019年发布,将BERT、GPT等Transformer架构模型的调用标准化为统一接口,成为学术界和工业界的事实标准。
- SafeTensors:现代模型权重的标准发布格式。它解决了传统pickle格式存在的任意代码执行安全漏洞,现已被几乎所有主流模型采用。
- Hugging Face Hub:几乎嵌入了每一个 AI 工具和 CI 流水线的客户端
- Gradio:绝大多数模型 Demo 背后的框架。它让研究者能用十几行Python搭建可分享的模型演示界面,极大降低了AI展示门槛。
- 还有一个能直接对接英伟达机器人野心的机器人团队
关键在于,你代码里每一次 from_pretrained 调用,默认都会指向 huggingface.co。from_pretrained是Transformers库的核心API方法,其底层实现会向huggingface.co发起HTTP请求,下载模型配置文件、分词器和权重。由于这一调用出现在几乎所有AI教程、论文复现代码和企业训练流水线中,它已成为事实上的行业标准入口点——类比来看,这相当于互联网早期浏览器默认搜索引擎的地位,用户可以更改,但绝大多数人不会。这一行代码背后默认发起的HTTP请求日均数亿次。1300 万注册用户,他们的每一个脚本,开箱即用地都指向同一个域名。这才是这笔交易真正的标的——分发层与默认入口的控制权。
Hugging Face 年营收约 1.5 亿美元,收购价约为营收的 86 倍。作为对比,微软当年以 75 亿美元收购 GitHub 时,GitHub 的营收还高于今天的 Hugging Face。如此高的估值倍数,现金流根本无法支撑——它买的是平台的控制权。
英伟达为何反而是开源的最大赢家
表面上,开源模型本应是制衡英伟达的力量,这笔交易看起来像是英伟达在「拦腰撞击」开源。但资金的流向恰恰相反。
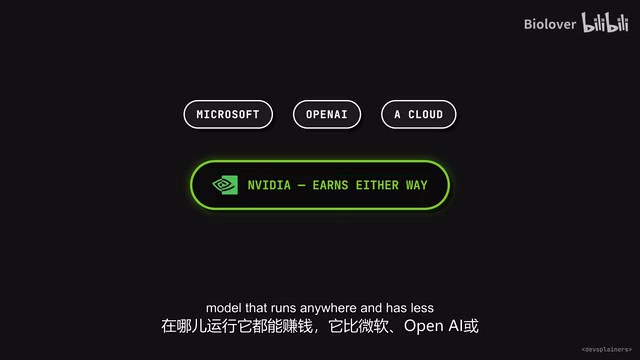
DeepSeek、Qwen、Kimi、Llama——这些开源模型压倒性地运行在英伟达 GPU 上。每一次开放权重的发布,实际上都在卖出更多英伟达硬件。摩根士丹利在 8 月的情景推演中直言:无论闭源实验室胜出、开源模型胜出还是市场分裂,英伟达都是「最大受益者」。黄仁勋 7 月自己也说过:「免费的 AI 对芯片是好事。」
更有意思的是,英伟达本身就是 Hugging Face 上最大的开放权重发布者,其 Nemotron 系列模型下载量超过 4500 万次。
英伟达真正面对的威胁是替代性芯片。CUDA(Compute Unified Device Architecture)是英伟达2006年推出的并行计算平台,经过近二十年的生态建设,PyTorch、TensorFlow等主流框架的底层加速均深度依赖CUDA。CUDA的护城河不仅是技术层面的,更是人才和知识层面的——全球数百万CUDA开发者积累的调优经验、数千篇依赖CUDA实现的学术论文、以及PyTorch中深度集成的cudnn和cublas加速库,共同构成了一个几乎不可能在短期内复制的生态系统。开发者一旦在CUDA生态中投入——熟悉其API、调优技巧和调试工具——迁移成本极高。
AMD的ROCm(Radeon Open Compute)自2016年推出以来持续追赶,其HIP编程模型在语法上与CUDA高度相似以降低迁移门槛,但在多卡通信(类似NVLink)和编译器稳定性方面仍有差距。Intel的oneAPI试图通过SYCL标准提供跨厂商的统一编程模型。华为昇腾的CANN(Compute Architecture for Neural Networks)则在中国市场因出口管制获得了加速发展的窗口期,已支持主流训练框架MindSpore和PyTorch的部分算子。
今年 2 月,一家中国实验室发布了一个前沿规模的开源模型,端到端在华为昇腾处理器上训练——DeepSeek-R1的训练正是在昇腾集群上完成,这直接动摇了"前沿模型只能在CUDA上训练"的叙事。如果一个默认模型针对别人的硬件调优、软件栈无需 CUDA,那么每一家采用它的公司都在削弱英伟达的护城河。而中国实验室去年占据了 Hugging Face 约 41% 的下载量。
英伟达的真正威胁从来不是某个单一竞争对手,而是软件栈与硬件解耦的趋势——而llama.cpp和Hugging Face的库栈,恰好是这种解耦的基础设施。拥有 Hub 给了英伟达两个对抗未来的杠杆:
杠杆一:数据情报
一个实时信息流——在任何竞争对手察觉趋势之前,就能看到每个开发者下载了什么、运行在什么硬件上。
杠杆二:默认项掌控
Hub 是采用决策发生的地方。谁拥有它,谁就决定哪个构建版本排在搜索结果最上面。而这两个杠杆,在一个开放的平台上同样有效——所以对英伟达而言,保持平台开放几乎没有额外成本。
GitHub 的前车之鉴
2018年6月微软以75亿美元收购GitHub时,开发者社区的恐慌引发了向GitLab的迁移潮,但迁移规模远低于预期。微软保持了平台开放,持续投入,让它独立运营多年。Actions、Packages、Pages等核心功能持续免费,私有仓库对个人用户开放。
然而,微软也把自己的战略产品 Copilot 织进了网站的每一个角落——Copilot于2021年推出,以GitHub代码库为训练基础,现已成为微软最重要的AI产品之一,年收入超过10亿美元。2024年GitHub CEO离职后,GitHub的产品路线图与微软Azure AI服务的整合明显加速。七年之后,平台始终保持开放,但中立性最终还是过期了。
这段历史提供的核心教训不是"开放平台会被关闭",而是"平台的中立性会以比用户预期慢得多、但比承诺快得多的速度消蚀"。
这一次有一个重大区别:2018 年的微软只是众多软件巨头之一,而今天的英伟达是 AI 领域的绝对主导者,它正在收购自己尚未控制的那部分 AI 分发层。Hugging Face 之所以能成长到今天的规模,正是因为它「不属于任何人,却服务所有人」——而这种信任,无法随服务器一起转移。
llama.cpp:你最先感受到变化的地方
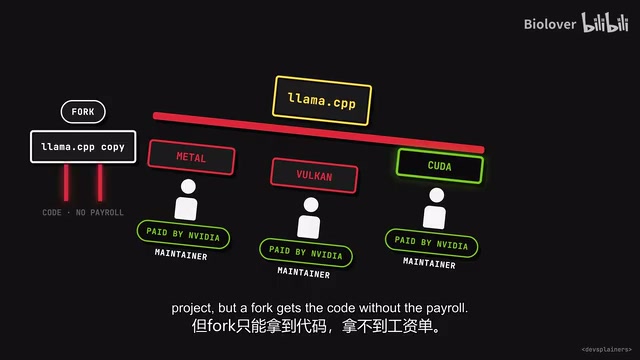
变化最先会在 llama.cpp 上显现。它的价值在于让模型在 Mac、AMD 显卡和普通 CPU 上高效运行,其 Metal 和 Vulkan 后端依赖持续维护。开源可持续性的危机并非新话题——2021年底的Log4Shell漏洞(CVE-2021-44228)暴露了一个惊人现实:全球数十亿设备依赖的Java日志库Log4j,长期仅由少数志愿者业余维护。这一事件促使Linux基金会和OpenSSF加大了对关键开源基础设施的投资,但问题远未解决。llama.cpp面临的是这一问题的典型版本:项目下载量数亿次,每次大模型发布都涌入数百个issue,但核心维护者屈指可数。如果拿英伟达工资的维护者让 Metal 和 Vulkan 后端逐渐落后于 CUDA 后端——这种非对称的维护速度,比任何许可证变更都更难被社区察觉——结果会是什么?
社区当然可以 fork 这个项目,但 fork 拿到的是代码,拿不到工资单。这是开源可持续性的核心困境。
「种子下载所有东西」行不行?一个叫 Hugging Bay 的镜像在收购消息传出前就已在流传,但它无法规模化——300 万个模型意味着一条谁都看不见的长尾,而文件本就是最容易复制的部分。真正难以替代的是:搜索排名、模型卡片,以及全球每一个默认指向同一域名的脚本。
开发者现在就该做的准备
真正有效的「逃生舱」其实只需一个环境变量。Hugging Face 的客户端库在设计上提供了重定向机制:HF_ENDPOINT 环境变量允许将所有模型下载请求指向自定义服务器,HF_HUB_URL 则可覆盖Hub的基础URL。用 Ollama 这样的开源工具在自己的机器上托管一个镜像,然后把 HF_ENDPOINT 指向它,整个客户端栈(包括 Transformers)都会跟着切换——一行配置,重定向一切。这一机制本是为支持中国镜像站(如hf-mirror.com)和企业内网部署而设计,技术上它让Hugging Face的客户端库在不修改任何代码的情况下,将所有API调用和文件下载重定向到任意兼容服务器。但在平台所有权发生变化的背景下,它同时成为了风险对冲的关键工具。
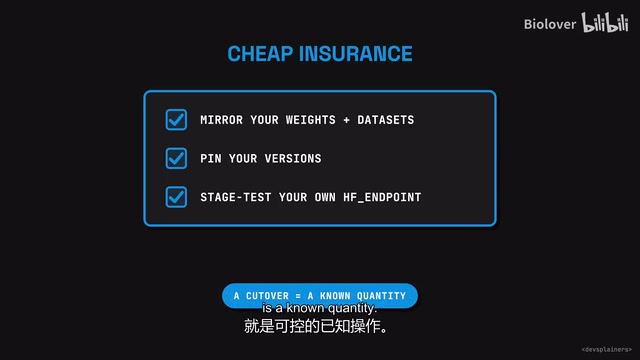
好消息是,今天你的工作流不会有任何变化。Hugging Face的核心库大多采用Apache 2.0许可证,这是一种宽松的开源许可,允许任何人自由使用、修改和分发代码,包括用于商业目的,且不可被追溯撤销。这意味着即便英伟达收购完成,已发布版本的代码在法律上仍然是开放的。然而,许可证保护的是代码的使用权,而非项目的发展方向——Redis、Elasticsearch、Terraform等项目已经证明,"许可证变更"是开源商业化中反复出现的模式,新版本完全可以采用更严格的许可条款。旧版本会继续工作,但廉价的「保险」依然值得购买:
- 镜像你的生产和 CI 所依赖的权重与数据集
- 锁定你的库版本
- 针对自建的 HF endpoint 镜像跑一次预演测试,让切换成为一个已知量
然后,按出现顺序关注四个信号:
- 访问壁垒:匿名下载开始出现账号墙或更严格的速率限制
- 格式偏向:GGUF、MLX、ROCm 等非 CUDA 格式的支持开始滞后
- 默认项变化:搜索结果和默认构建开始倾向英伟达生态
- 人的流失:Gerganov 或核心 Transformers 维护者离开
结语
无论这笔交易最终是否成交,「镜像你的模型」都是成本极低、回报确定的操作。英伟达买下的不是一堆文件,而是整个生态的默认入口。历史已经用 GitHub 告诉我们:平台可以一直开放,但中立性未必永远有效。对于依赖 Hugging Face 的每一位开发者,主动权仍然掌握在自己手中——前提是提前做好准备。
相关推荐
一个月为M4 Mac Mini开发Linux GPU驱动的技术挑战
开发者Cody Ho用一个月时间为M4 Mac Mini构建Linux GPU驱动,本文解析Apple Silicon GPU逆向工程的核心难点、开源社区协作价值及其对Linux硬件生态的意义。
SEO Page Builder Enhanced:让AI生成的SEO内容摆脱套路味
开发者基于octelens原版seo-page-builder打造的增强版开源工具,通过引入编辑审校、一手经验、事实与时效校验及写作风格护栏,专门解决AI生成SEO内容套路化、缺乏原创洞见的问题。
分层RAG架构研究求助:独立开发者如何叩开学术研究之门
一位独立开发者在Reddit求助信息检索领域教授,指导其分层RAG架构研究。本文剖析异构文档检索的技术背景,探讨独立AI研究者面临的学术门槛困境,并给出公开成果、社区协作等实用建议。