用Docker部署AI智能体到生产环境:从开发到上线的实战指南

Docker专家Rami Krispin以RAG应用为例,讲解如何用容器化解决AI应用部署的可复现性难题。
本文整理自Build With AI系列第20期分享,Docker专家Rami Krispin以RAG(检索增强生成)应用为案例,系统讲解了容器化对AI工程落地的核心价值。他指出Docker的精髓不在于打包机器,而在于将依赖一路打包到操作系统层级,从根本上解决"在我机器上是好的"这一经典难题。RAG应用因天然由摄取管道、向量数据库、查询管道三个独立组件构成,是容器化的绝佳载体。Rami给出了务实的容器策略:开发阶段用两容器降低构建频率,生产阶段拆成三容器实现故障隔离与体积优化。他还强调了生产级实践要点:镜像必须打版本标签、生产镜像用多阶段构建瘦身、凭证绝不写入容器。核心结论是:本地容器跑通后迁移至主流云平台大概率可用,这种可复现性正是数据科学家跨越部署"最后一公里"的关键能力。
在Build With AI系列的第20期分享中,Docker专家、数据科学内容创作者Rami Krispin带来了一场聚焦"如何将AI应用部署到生产环境"的实战讲解。他没有陷入Docker繁琐的技术细节,而是用RAG(检索增强生成)应用作为案例,讲清了容器化对AI工程落地的核心价值——可复现性。
为什么AI应用离不开Docker:可复现性问题
Rami用一句话概括了使用Docker的理由:更高层次的可复现性(reproducibility)。他回忆自己初入数据科学行业时,以为"可复现"就是设置随机种子(set the seed),但进入工业界后才发现,环境的可复现远不止于此。
一个典型场景是:你在自己的Mac(Apple Silicon)上用Python开发了一个带嵌入模型的应用,用pip安装依赖,本地跑得好好的。但一旦分享给使用不同配置的同事,或部署到外部服务器,问题就接踵而至。这正是Stack Overflow时代最经典的问题标题——"It works on my machine"(在我机器上是好的)。
Rami系统梳理了可复现性失败的几个层面:Python版本漂移、包版本差异(pandas 1/2/3 的函数不同)、操作系统差异(即便同为Windows或Mac,不同版本的编译器也会变化)、以及硬件架构的影响。他特别点名PyTorch:在AMD、ARM64、Intel上的表现各不相同。
关于常见的"虚拟环境是否够用"的疑问,Rami明确指出:虚拟环境只是可复现性的第一层。他自己即使在容器内也坚持使用虚拟环境,但虚拟环境无法解决编译器缺失、操作系统差异等问题。Docker的精髓在于——它打包的不是你的机器,而是你的依赖,一路打包到操作系统层级。这也是那个著名Docker梗的来源:目标不是"把你的机器寄过去",而是避免这种尴尬。
为什么用RAG当案例:AI应用天然是多组件系统
Rami选择RAG作为讲解Docker的载体,理由是RAG是容器化的"绝佳用例"。他简要回顾了RAG原理:语言模型其实不懂语言,它懂的是向量。要让LLM回答训练数据之外的问题(比如公司内部文档、差旅政策),需要把PDF等文本切分成小块(chunking),用嵌入模型转成向量存入向量数据库,查询时做相似度检索,再把结果转回文本回答用户。
关键洞察在于,RAG可以拆解为三个相互独立的组件:
- 摄取管道(Ingestion Pipeline):一次性或周期性地把文档写入向量数据库
- 向量数据库(Vector Database):如ChromaDB
- 查询管道(Query Pipeline):处理用户提问的相似度检索
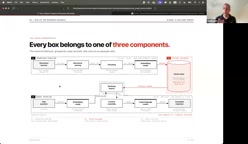
Rami强调,摄取管道和查询管道虽然都接触向量数据库,但彼此没有直接连接,技术上是独立的服务。这种拆分思维是容器化部署的前提:在动手开发前,先问自己——我的AI应用有哪些组件?需要构建哪些服务? 想清楚组件边界,才能设计合理的架构。
**嵌入模型(Embedding Model)**是RAG架构的核心环节之一,负责将文本转换为高维向量(通常是几百到几千维的浮点数数组)。相似语义的文本在向量空间中距离更近,因此可以通过计算余弦相似度或欧氏距离来找到"语义上相关"的文本片段,而不依赖关键词匹配。常用的开源嵌入模型包括 Sentence-BERT 系列和 Hugging Face 上的 all-MiniLM 等;商业选择则有 OpenAI 的 text-embedding-ada 系列。向量数据库(如文中提到的 ChromaDB,以及 Pinecone、Weaviate、Qdrant 等)专门为高效存储和检索这类高维向量而设计,支持近似最近邻(ANN)搜索,使得在百万级文档中毫秒级找到最相关片段成为可能。理解这两个组件的作用,有助于理解为何 RAG 系统天然分为"写入(摄取)"和"读取(查询)"两条独立路径,进而理解容器拆分的必要性。
Docker工作流:从Dockerfile到镜像再到运行时
为了照顾不熟悉Docker的听众,Rami讲解了基础工作流:从需求出发,编写Dockerfile(一个包含指令的文本文件,相当于"配方":用哪个Python版本、装哪些库、暴露哪个端口),然后docker build生成镜像,最后在运行时执行。
他以一个FastAPI应用为例:从基础镜像出发,定义工作目录、复制requirements.txt、安装依赖、暴露端口,运行时执行main.py。短短几行就能生成一个可暴露API的镜像。
Rami特别强调了Docker的**分层缓存(layer caching)**机制。合理的Dockerfile应把不常变动的内容(如依赖安装)放在前面,把开发中频繁变动的文件放在后面,这样构建时能复用缓存、节省时间。此外,容器相比虚拟机的另一优势是:应用崩溃时,直接拆掉容器重新拉起即可,速度远快于虚拟机——这也是AWS、GCP、Azure大量基于容器部署的原因。
**多阶段构建(Multi-stage Build)**是 Dockerfile 的一项进阶特性,值得在此补充说明,因为文章后续在生产部署建议中有所提及。其核心思路是:在同一个 Dockerfile 中定义多个 FROM 阶段,前期阶段("构建阶段")安装编译工具、下载依赖、生成构建产物,最终阶段只把必要的可执行文件或包复制过来,完全丢弃构建工具链。这样生产镜像里不会残留 gcc、make、pip 缓存等只在构建期需要的内容,镜像体积可以减少数百 MB 甚至更多,同时也缩小了攻击面(更少的软件意味着更少的漏洞)。对于 AI 应用而言,嵌入模型权重文件往往体积较大,多阶段构建配合仅复制运行时必需文件的策略,是控制生产镜像大小的标准做法。
开发用两个容器,生产拆成三个:容器策略的取舍
Rami给出的实战策略颇具参考价值:开发阶段用两个容器,生产阶段拆成三个。
开发时,他把摄取和查询两个组件放在同一个Python容器里,向量数据库(如ChromaDB)单独起一个容器。原因是开发阶段依赖频繁变动,常常发现"原来还需要装某个库",而重新构建镜像耗时,所以希望在一个统一的Python环境里并行开发。
但进入生产,就必须拆分,理由有三:
- 使用频率不同:查询引擎频繁使用,摄取引擎通常由管理员周期性(每周/月/季度)运行,放在一起会无谓撑大容器体积。
- 故障隔离:若摄取和查询在同一容器,摄取管道崩溃会连带查询引擎一起挂掉,影响正在使用的用户。
- 体积优化:摄取端会缓存Hugging Face的切分功能,体积较大;查询管道很轻量(容器内不含模型),且运行更频繁。
生产环境中,三个服务通过不同端口暴露并以API通信:摄取端口8081、向量数据库8000、查询端口8080。Rami的部署路径是:开发 → 测试(拆分服务、重跑测试)→ 云环境测试 → 生产。他推荐用VS Code的Dev Containers扩展(微软出品),让VS Code原生运行在容器内,实现项目级的完全隔离——从字体主题到运行环境皆可独立配置。
现场演示与生产落地问答
Rami现场演示了一个玩具级RAG应用:摄取迪士尼的季度财报PDF,用Streamlit构建界面,底层跑在两个容器中(Python应用 + ChromaDB)。提问"当前季度收入是多少"后,应用返回"约250亿美元,同比增长5%",并能提供信息来源供验证。
问答环节he分享了多个生产级实践要点:
- 版本管理:永远为镜像设置版本标签(tag),切勿使用默认的
latest,否则无法追溯历史版本。他建议为dev和prod分别打标签,开发镜像依赖多、更灵活,生产镜像用**多阶段构建(multi-stage build)**瘦身并剔除无用依赖。 - 安全:绝不在容器内保存凭证或API密钥,运行时通过挂载注入;不要用root用户;可使用Docker Scout做安全评估。
- 解析技术:无论源是Excel还是PDF,先统一转成Markdown/文本,再做切分、嵌入、入库。他提到使用Docling类工具提取PDF信息。
- 防幻觉:利用RAG可控输入的特性做事实验证——把LLM生成的内容再用RAG回检,确认是否有证据支撑。
- 云端部署:在AWS等平台上优先使用官方验证过的企业级容器(如ChromaDB提供的),现成且可靠。
Docker Compose 是管理多容器应用的常用工具,在文章描述的"两容器开发、三容器生产"场景中扮演重要角色,但文中未作展开。它通过一个 docker-compose.yml 文件声明所有服务的镜像、端口映射、环境变量、网络连接和挂载卷,用 docker compose up 一条命令即可同时启动所有容器,并自动为它们创建一个私有虚拟网络,使容器之间可以用服务名直接互相访问(例如查询服务直接访问 chromadb:8000 而无需知道宿主机 IP)。这正是 Rami 演示中摄取端口 8081、向量数据库 8000、查询端口 8080 能协同工作的底层机制。理解 Docker Compose 与 Dockerfile 的分工——前者编排多服务关系,后者定义单一镜像内容——是落地多组件 AI 应用的必要基础。
核心启示
Rami这场分享最有价值的,不是Docker命令本身,而是一种工程思维:把AI应用拆解为独立服务,用容器实现从开发到生产的无缝迁移。正如他所说,只要在本地容器里跑通,拿到AWS、GCP、Azure上"大概率就能跑";即便云端出问题,也能在本地轻松复现——因为一切都是可复现的。对于习惯在Notebook里折腾模型、却对部署头疼的数据科学家而言,这正是跨越"最后一公里"的关键能力。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。