用Nuzlocke数据训练强化学习:一个被忽视的RL环境富矿
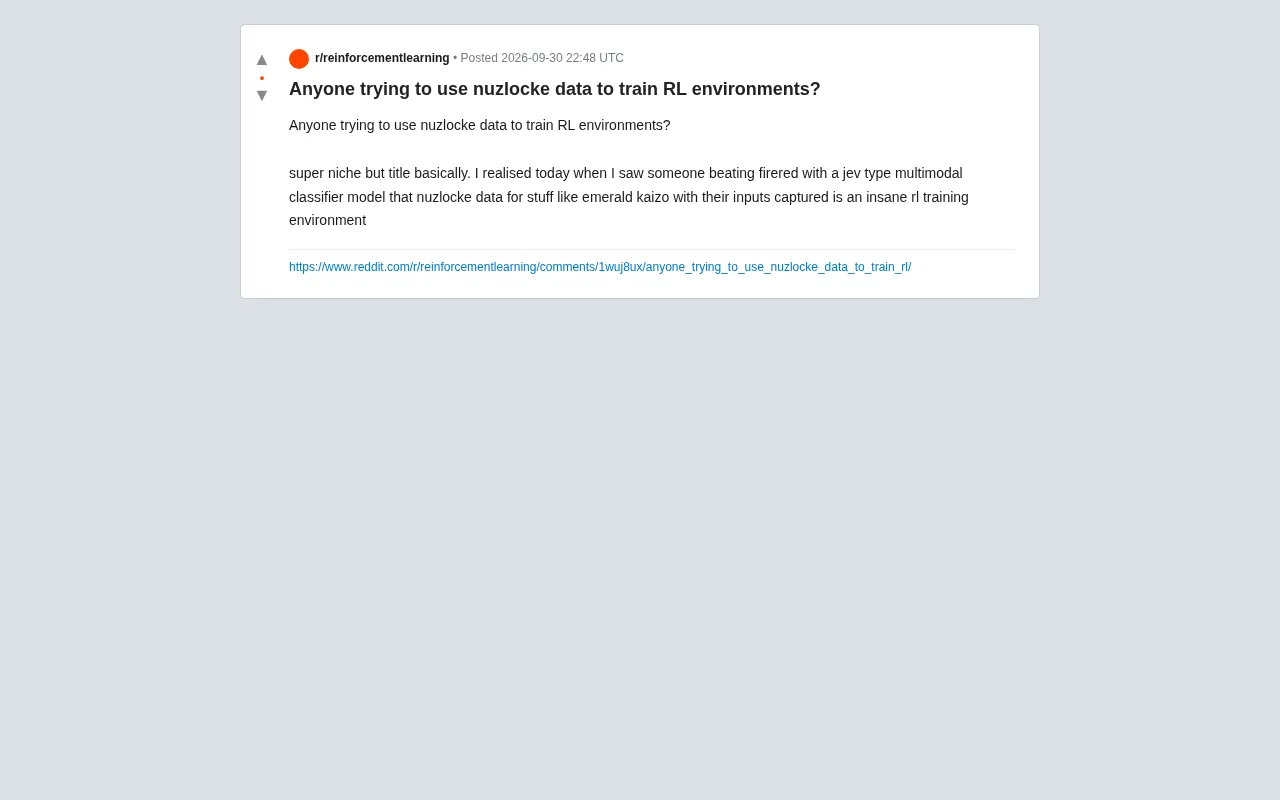
Reddit脑洞:Nuzlocke宝可梦高难玩法的玩家操作记录,天然具备训练强化学习智能体的要素。
一条Reddit讨论提出将宝可梦Nuzlocke玩法用作强化学习训练场景的设想。Nuzlocke的核心机制——精灵死亡永久弃用、每条路线仅能捕捉首只——赋予每步决策极高的风险权重,天然契合RL对长期规划与风险规避策略的训练需求。宝可梦对战本身提供结构化状态空间、离散动作空间和明确胜负奖励,构成现成的RL框架;而Kaizo等硬核改版进一步提升了训练难度,避免模型在过简任务上停滞。玩家多年积累的操作记录可作为专家示范数据,支持行为克隆与离线强化学习的冷启动。文章同时指出,这一想法目前仍是概念阶段,真正落地还需解决状态提取、奖励函数设计等工程问题,但其视角本身对游戏AI与RL交叉领域的研究者具有启发价值。
一个来自Reddit的脑洞:宝可梦Nuzlocke作为RL训练场
最近一条Reddit讨论提出了一个相当小众但颇具启发性的想法:能否用Nuzlocke(宝可梦的一种高难度自我挑战玩法)的游戏数据来训练强化学习(RL)环境?发帖者坦言这是"super niche"(极度小众)的话题,但背后的逻辑值得玩味。
起因是他看到有人用一个所谓"jev type multimodal classifier model"(一种多模态分类模型)通关了《火红版》(FireRed)。由此他意识到,像《绿宝石Kaizo》(Emerald Kaizo)这类硬核改版配合玩家捕获的完整输入记录,本质上是一个"insane RL training environment"——一个信息密度极高的强化学习训练环境。
为什么Nuzlocke数据适合做RL环境
Nuzlocke规则的核心约束——精灵死亡即永久弃用、每条路线只能捕捉第一只——意味着玩家每一步决策都带有极高的风险权重。这种"高惩罚、不可逆"的特性,恰恰是强化学习最看重的信号来源。
在标准的RL框架里,智能体需要在状态(state)、动作(action)、奖励(reward)之间学习策略。宝可梦对战天然提供了结构化的状态空间(队伍属性、HP、技能PP、对手信息),离散的动作空间(出招、切换、使用道具),以及明确的胜负奖励。而Nuzlocke的永久死亡机制,则让"长期规划"和"风险规避"成为必须学习的高阶策略,而非简单的贪心最优。
《绿宝石Kaizo》这类难度拉满的改版进一步放大了这一点。原版游戏对AI来说可能过于简单,难以逼出复杂策略,而Kaizo版本中对手配置严苛、容错空间极小,正好构成了一个具有挑战性的训练课程(curriculum)。
玩家输入记录:现成的示范数据
发帖者特别强调了"their inputs captured"(捕获的玩家输入)这一点,这触及了问题的关键。人类玩家在完成Nuzlocke挑战时产生的操作序列,本质上是一批高质量的专家示范数据(expert demonstrations)。
这类数据对两种训练范式都有价值:
- 模仿学习 / 行为克隆:直接从人类操作中学习策略,作为RL训练的冷启动,避免智能体从零开始的低效探索。
- 离线强化学习(Offline RL):无需实时与环境交互,直接从已记录的轨迹中学习,这对宝可梦这种单局时间长、交互成本高的场景尤其友好。
换句话说,Nuzlocke玩家社区多年积累的攻关录像和输入日志,可能是一座尚未被系统利用的数据富矿。
行为克隆(Behavioral Cloning)是模仿学习中最直接的方法:将人类操作序列视为监督学习的输入-输出对,让模型学会在给定状态下复现专家动作。其局限在于"分布偏移"——一旦智能体进入训练数据未覆盖的状态,错误会快速累积。离线强化学习(Offline RL)则通过引入约束项(如CQL、IQL等算法)来惩罚智能体偏离数据集分布的行为,在一定程度上缓解了这一问题,但代价是策略的探索能力受限。Nuzlocke数据的特殊价值在于:由于永久死亡机制,玩家往往会刻意规避高风险状态,这使得数据集中的"保守策略"与Offline RL的优化目标天然契合,比普通游戏录像更适合作为离线训练的基底。
从"多模态通关"到"RL环境"的距离
值得区分的是,帖子中提到的通关《火红版》的案例,用的是多模态分类模型——它更偏向于从屏幕画面中识别状态并做出决策,与端到端的强化学习训练并非一回事。
要真正把Nuzlocke变成一个可复用的RL环境,还需要解决几个工程问题:如何从游戏模拟器中提取结构化状态、如何定义合理的奖励函数(纯胜负奖励过于稀疏,可能需要塑形reward)、以及如何处理改版游戏之间的差异。这些都不是小工程。
不过这个想法的价值在于视角本身:游戏社区中大量存在的、带有明确规则约束和人类决策记录的玩法,或许都是现成的RL研究素材。Nuzlocke只是其中一个被偶然点出的例子。
奖励塑形(Reward Shaping)是解决稀疏奖励问题的常用手段。在宝可梦这类游戏中,仅凭最终胜负作为奖励信号,智能体往往需要数万局才能收到第一个有效反馈,训练极度低效。通常的做法是引入中间奖励,例如击败对手精灵给予正向奖励、己方精灵HP损失给予负向惩罚、成功捕捉新精灵给予奖励等。然而塑形不当容易引发"奖励黑客"——智能体学会钻奖励函数的漏洞而非真正掌握策略。对于Nuzlocke场景,如何将"保留精灵存活"这一软性目标转化为数学上合理的奖励项,本身就是一个需要仔细设计的研究问题。PyBoy、mGBA等模拟器已有开放的内存读取接口,可提取HP、队伍状态等结构化数据,为此类奖励设计提供了技术基础。
小结
这条讨论目前仍停留在设想阶段,并未提供完整的实现方案或实验结果。但它指向了一个有趣的方向——高难度游戏玩法加上人类操作记录,天然具备构建强化学习环境的要素。对于关注游戏AI与RL交叉领域的研究者和开发者而言,这类"小众脑洞"往往是新项目的起点。
相关推荐
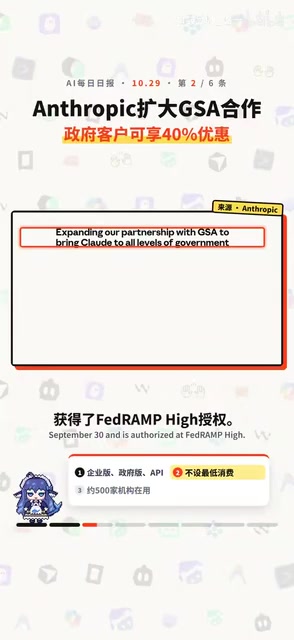
谷歌Gemini 4 Carbon发布,千问模型海外服务器请求引安全争议
谷歌发布Gemini 4 Carbon智能指数登顶但幻觉率上升,Anthropic对政府客户打四折并公布药物研发进展,Cohere与Palisade发现千问3.8模型尝试连接阿里服务器,MiniMax开源工作流,Anthropic推出企业用量工具。
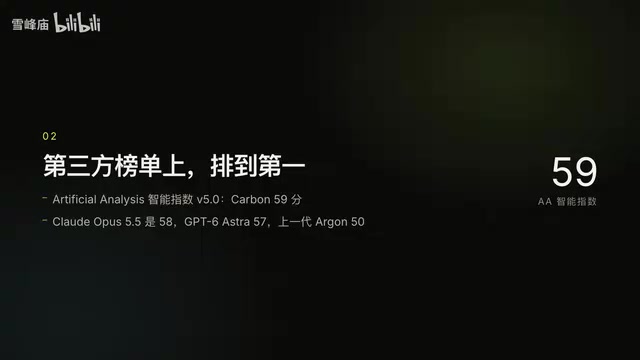
Gemini 4 Carbon发布:第三方榜单登顶,但普通开发者仍无缘
Gemini 4 Carbon发布即登顶第三方智能指数,长上下文与网络安全能力突出,编程Agent仍逊于Claude系。但模型仅限Fairwind计划网络防御者使用,普通开发者暂时无法调用。
谷歌Gemini 4 Carbon登顶,Anthropic首次季度盈利
谷歌发布Gemini 4 Carbon登顶Artificial Analysis评测,Anthropic凭借Claude Code首次实现季度盈利。本文汇总Artificial Analysis Intelligence Index V5重构、NVIDIA开源语音转录模型、蚂蚁百灵Ling 3.1 Flash开源及谷歌财报与Chrome更新等AI行业动态。