用Python和MCP构建带聊天界面的AI Agent

用 Streamlit、MCP 服务器和简易文档检索,把终端 Agent 变成可用的个人工具。
文章介绍了把终端 AI Agent 升级为实用个人工具的三步路径。第一步用 Streamlit 构建聊天界面,将 Agent 核心逻辑抽到 core.py 与页面层解耦,借助 session_state 保存对话历史,并在侧边栏展示 Agent 记忆;同时为写文件等敏感工具加 Allow/Deny 授权按钮。第二步通过 MCP 标准直接接入文件系统、Web、GitHub 等现成服务器,无需手写工具代码,但接入前需检查来源、权限与工具描述并锁定版本。第三步自建最小化文档检索服务器,用关键词匹配实现 RAG 的简化形态。三者共同体现核心逻辑与交互层、工具层分离的架构思路。
从终端到聊天界面:AI Agent 的体验升级
大多数 AI Agent 教程止步于终端——能跑、能调用工具,但普通用户根本没法用。来自 YouTube 频道 LearnTech 的教程展示了一条完整的落地路径:用 Streamlit 给 Agent 套上聊天页面,再用现成的 MCP 服务器扩展能力,最后让它读取你自己的文档。这三个步骤各自解决一个真实痛点,且全程只用 Python。
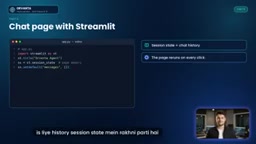
为什么需要聊天页面
终端里的 Agent 没有历史记录、没有记忆展示、用户也无法对敏感操作说"不"。教程的做法是把 Agent 核心逻辑抽到 core.py,暴露一个 run_agent 函数,它接收消息列表,要么返回最终回答,要么返回"这个工具需要授权"的信号。页面层 app.py 只负责渲染和交互,两者解耦后,终端版和网页版可以共享同一套 Agent 逻辑。
Streamlit 在这里的价值是省掉了前端工程:session_state 充当对话历史的存储,因为页面每次交互都会重新执行,状态必须显式保存。侧边栏读取 memory.json,把 Agent 记住的用户信息直接展示出来——这种透明度在终端里是看不到的。
Streamlit 的 session_state 机制是理解页面层设计的前提。Streamlit 每次用户交互都会从头重新执行整个脚本,普通变量在重跑时会被重置,无法跨轮次保留对话历史。st.session_state 是一个与用户会话绑定的字典,脚本重跑时它的值依然存在,因此适合存放消息列表、授权状态等需要持久化的数据。使用时通常先判断某个键是否存在,不存在再初始化,避免每次重跑都覆盖。这也解释了为什么 Agent 核心逻辑不能依赖任何全局变量,而必须把状态作为参数传入、把结果作为返回值传出。
授权按钮:把控制权交回用户
教程里一个值得注意的设计是 Allow / Deny 按钮。当 Agent 想调用会改变状态的工具(比如添加任务、写文件),页面先弹警告,用户点击 Allow 才执行;点击 Deny 则把拒绝信号回传给 Agent。
这个细节看似简单,实际是 Agent 产品化的关键。工具调用一旦涉及写入、删除,无条件的自动执行就是风险敞口。教程还预先维护了一份"敏感工具清单",凡是名字以 add、write、edit、create、delete 开头的工具,写文件前同样会触发 Allow 按钮。
现成 MCP 服务器:不写代码接入外部能力
MCP(Model Context Protocol)的意义在于标准化——任何 Agent 都能和任何遵循该协议的服务器对话。这意味着社区里已经存在的数千个 MCP 服务器可以直接拿来用。
三个典型服务器
教程演示了三类最常见的接入场景:
- 文件系统服务器:让 Agent 读写指定文件夹,权限严格限定在用户指定的目录内
- Web 服务器:打开并读取任意网页内容
- GitHub 服务器:查看仓库、Issue 和 Pull Request
配置方式和自建服务器完全一致,在服务器列表里加几行即可,每行只需声明启动命令和参数。文件系统服务器的最后一个参数就是授权目录——这是权限边界的第一道闸门。GitHub 服务器需要一个 token,教程强调两点:token 只给读权限;token 绝不写进代码,放在环境变量里。
实测流程是:让 Agent 列出共享文件夹的文件,文件系统服务器执行后列表返回;再让它读一个网页并保存成文件,Web 服务器先读取内容,页面弹出 Allow 按钮,确认后文件写入成功。整个过程没有手写任何工具代码。
信任之前先检查
教程提出了一个容易被忽略的问题:每个 MCP 服务器本质上是跑在你电脑上的程序,Agent 会无条件相信它的输出。所以接入前应该做几项检查:
- 服务器是谁做的——官方还是来路不明
- 读一遍代码或 README
- 看它申请了哪些权限,越少越好(单文件夹、只读 token)
- 先列出它的工具,检查名称和描述里有没有奇怪的指令
- 锁定版本,防止更新后行为变化
教程提供了一个 inspectserver.py 小脚本,运行后能列出服务器所有工具的名称和描述。但它同时提醒:这个脚本本身也会执行服务器程序,所以要先读 README 再运行,并且在一个不含重要文件的目录里运行。
MCP 的通信方式值得补充:它基于 JSON-RPC,客户端(这里是 Agent)与服务器之间通过标准输入输出或网络传输交换结构化消息。协议把服务器能力抽象为三类原语——Tools(可被模型调用的函数,带名称、描述和输入参数模式)、Resources(可读取的数据,如文件内容)、Prompts(预置的提示模板)。Agent 启动时会先向服务器发起能力协商,拿到工具清单后把这些工具的描述注入模型上下文,模型据此决定调用哪个工具、传什么参数。正因如此,检查工具名称和描述才格外重要:这些文本会直接进入模型的决策依据。
让 Agent 读懂你自己的文档
LLM 没有见过你的笔记和文档,直接问它退款政策写了什么,它只能猜或者答错。RAG(检索增强生成)解决的就是这个问题:先按问题在文件里找出相关段落,再把段落交给模型,让它基于这些内容回答。
一个最小化的文档检索服务器
教程建了一个 My Docs 文件夹存放文本和 Markdown 文件,然后写了一个 Docserver.py:先把每份文件切成段落,提供一个 Search Docs 工具接收查询词,逐段匹配,按命中词数排序,返回得分最高的三个段落并附带文件名;再加一个 List Docs 工具列出所有文件。
把这个服务器加进 Agent 的列表只需要一行,同时在系统提示里写明:涉及文档的问题先调用 Search Docs,回答时标明文件名,不许猜测。
这是 RAG 的简化版
教程作者自己说得很直接:这个搜索只做关键词匹配,真正的 RAG 是按语义检索,也就是 Embeddings,那是另一个话题。但作为教学起点,这个简化版的思路是完整的——检索、注入上下文、约束回答来源——后续把关键词匹配替换成向量检索即可升级。
Embeddings 与向量检索是升级方向的核心。Embeddings 是把一段文本映射成一个高维数值向量,语义相近的文本在向量空间中距离更近。实际做法是预先对所有文档段落计算向量并存入向量数据库,查询时把用户问题也转成向量,按余弦相似度取最接近的若干段落。与关键词匹配相比,它能处理同义表达和换词提问,比如问“退货怎么处理”也能命中写着“退款流程”的段落。代价是需要额外的嵌入模型调用、向量存储以及分块策略调优,这也是教程先用关键词版本降低门槛的原因。
三件事的共性
回头看这三个部分:聊天页面解决的是可用性,现成服务器解决的是能力扩展,文档检索解决的是数据私有化。它们共享同一个架构判断——Agent 的核心逻辑与交互层、工具层保持分离。core.py 可以被网页调用,也可以被终端调用;MCP 服务器可以随时增删而不改动 Agent 代码。这种结构让一个教学 demo 距离可用的个人工具近了不少。
常见问题
MCP 服务器需要什么编程基础? 接入现成服务器不需要写代码,只需在配置里声明启动命令和参数。自己写服务器则需要了解基本的 Python 和协议接口。
为什么敏感工具要单独授权? 会改变状态的工具(写入、删除、创建)一旦误触发难以撤销,Allow / Deny 按钮把最终决定权留给用户,是风险控制的基本手段。
简化版关键词搜索够用吗? 对于文档量不大、术语明确的场景基本够用。文档规模变大或问题偏语义化时,需要换成基于 Embeddings 的向量检索。
相关推荐

Anthropic IPO揭秘:AI热潮的燃料还是泡沫导火索?
Anthropic递交IPO申请,代码ANT。拆解招股书:80%收入来自按量付费、净亏807亿中720亿为账面费用、900%净收入留存率,以及SpaceX等历史IPO的首日与三年表现对比,回答AI泡沫之问。

AI会杀死研究论文吗?数学家给出新答案
数学家们在Lex Fridman播客中讨论AI是否会让研究论文消亡。从期刊审稿压力到Lean形式化验证,从GitHub开源疲惫到Mathlib的众包模式,探讨学术贡献形态的演变与数学知识验证的未来。

企业级大模型开发:从RAG到多Agent实战
企业级大模型应用开发课程解析:从提示工程、RAG到多Agent工程实战与FDE项目交付,帮助开发者理解Agent技术为何成为企业落地重点,系统化学习少走弯路。