用软标签双向锚定与主动学习构建电力方言词典

弱监督框架自动构建方言电力词典,在玉溪微信数据上实现零误报方言识别。
针对电力客服中方言社交媒体消息带来的非标准表达、语义漂移和未登录词难题,该研究提出弱监督框架,从方言锚点和电力种子词出发,利用PMI生成候选词,并以软标签双向锚定保留电力相关性元数据而非硬性过滤。候选词得分由Sentence-BERT语义相似度与jieba词性度量组合,再经不确定性感知的主动学习和LLM预言机筛选。在云南玉溪11,177条真实微信消息上,方言精度DP=1.0、零误报,人类校准κ_dialect=1.0、κ_power=0.85。最终词典含25-33个词条,定位为方言感知电力客服NLP的初步资源。
电网客服正越来越多地依赖社交媒体来捕捉用户诉求,但云南玉溪等地的用户习惯用方言描述停电、账单和设备故障。这些非标准表达给传统NLP工具带来巨大挑战。一项新研究提出弱监督框架,从方言锚点与电力种子词出发,自动构建区域俚语词典,在真实微信数据上实现了零误报的方言识别精度。
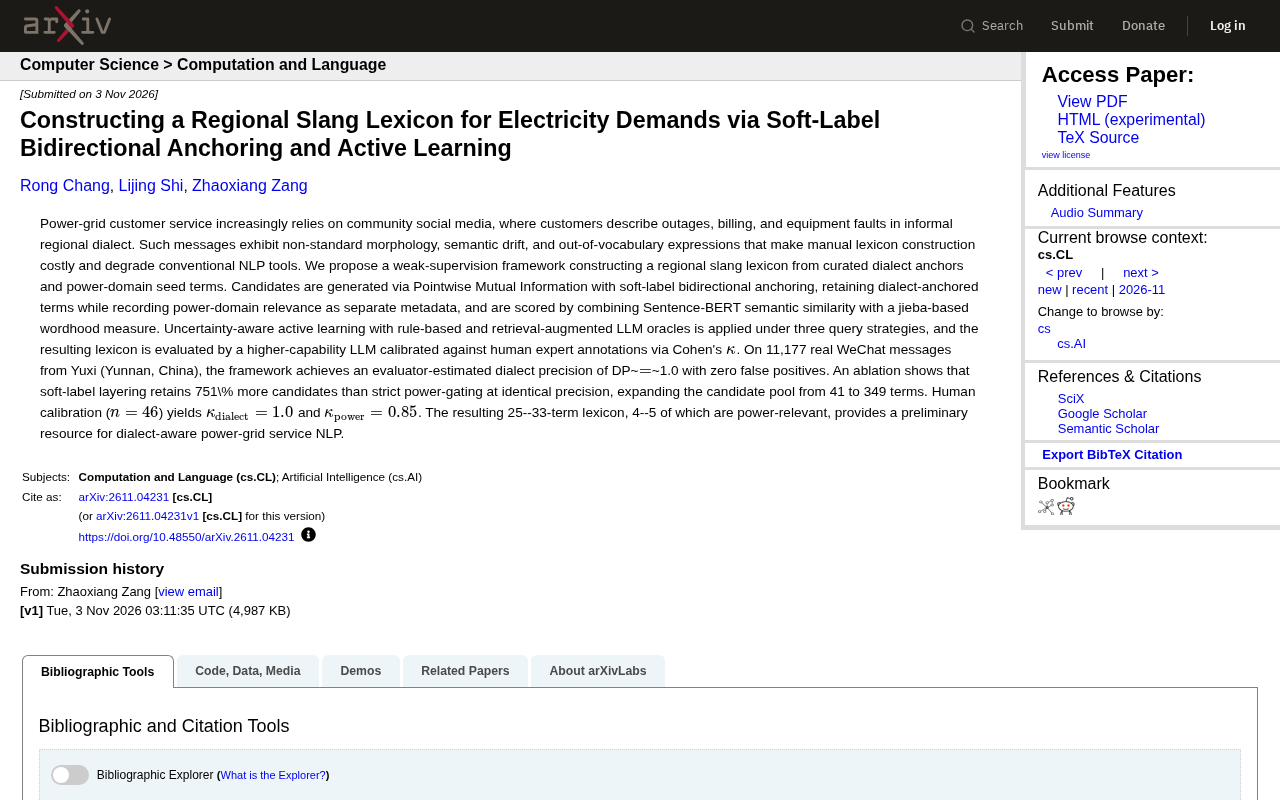
方言文本给电力客服NLP带来的特殊难题
电力客服场景下的社交媒体消息往往夹杂着当地方言,呈现出非标准形态、语义漂移和大量未登录词。以云南玉溪地区为例,用户在微信中描述停电时可能使用完全不同于普通话的表达方式。人工构建方言词典成本高昂,而直接套用通用NLP工具则效果不佳。该研究聚焦这一痛点,试图用弱监督方法自动化词典构建流程。
据论文描述,这类消息的“非标准形态、语义漂移和未登录词表达”使得人工词典构建成本高昂,并会降低常规NLP工具的性能。研究团队从精心筛选的方言锚点和电力领域种子词入手,设计了一套候选词生成与筛选机制。
软标签双向锚定:保留更多候选词的关键设计
框架的核心创新在于“软标签双向锚定”。候选词通过点互信息(PMI)生成,同时保留方言锚定词并将电力领域相关性记录为独立的元数据,而非硬性过滤。候选词得分由Sentence-BERT语义相似度与基于jieba的词性度量组合而成。
这种软标签分层设计与严格的电力门控形成鲜明对比。消融实验显示,在相同精度下,软标签分层保留的候选词数量比严格电力门控多出751%,候选池从41个词扩展到349个词。这意味着系统不会因为过度聚焦电力相关性而漏掉大量有潜力的方言表达。
随后,研究采用不确定性感知的主动学习,结合基于规则和检索增强的LLM预言机,在三种查询策略下进行筛选。最终词典由一个能力更强的LLM评估,并通过Cohen's κ与人类专家标注进行校准。
点互信息(PMI) 是衡量两个词在语料中共现紧密程度的统计量,定义为 (\text{PMI}(x,y)=\log\frac{P(x,y)}{P(x)P(y)})。在方言词典构建中,PMI 用于从海量微信消息中挖掘与方言锚点频繁共现的候选词:若某词与已知方言词在相同语境下高频同现,则它很可能也是方言表达。PMI 对低频共现较为敏感,常配合平滑或阈值过滤使用。
Sentence-BERT 是将句子映射为稠密向量的预训练模型,通过孪生网络结构微调,使语义相近的句子在向量空间中距离更近。本研究中,它用于计算候选词与锚点词在语义层面的相似度,弥补 PMI 仅依赖共现统计、无法捕捉语义泛化的不足。
Cohen's κ 是衡量两名标注者一致性程度的统计指标,取值通常在 0 到 1 之间,已扣除随机一致的概率。κ=1.0 表示完全一致,κ>0.8 通常被视为高度一致。本研究用 κ 校准 LLM 自动评估与人类专家判断之间的一致性,κ_dialect=1.0 意味着自动评估在方言判定上与专家完全吻合,κ_power=0.85 则表明电力相关性判定也达到高度一致,为“零误报”结论提供了可靠性支撑。
真实数据验证:零误报与高一致性
研究在来自云南玉溪的11,177条真实微信消息上进行了测试。结果显示,评估器估计的方言精度DP=1.0,零误报。人类校准(n=46)得到方言一致性κ=1.0,电力相关性一致性κ=0.85,表明自动评估与专家判断高度吻合。
最终产出的词典包含25至33个词条,其中4至5个与电力相关。论文将其定位为“方言感知电力客服NLP的初步资源”。
方法论启示与局限
该框架的价值在于将词典构建从纯人工转向弱监督流水线,软标签机制在召回率上的优势尤为明显。不过,论文也坦承当前词典规模有限,仅为初步资源。25至33个词条的覆盖范围对于实际客服系统而言仍然偏小,后续需要扩展到更多方言区域和更大规模的种子词库。
另一个值得关注的点是主动学习与LLM预言机的结合方式。规则与检索增强LLM作为预言机,在三种查询策略下工作,这为低资源场景下的标注效率提供了可复用的思路。但框架对初始方言锚点和电力种子词的质量依赖较高,锚点选择不当可能直接影响候选词生成的质量。
总体来看,这项研究为方言密集场景的领域NLP提供了一条可操作的弱监督路径,尤其在电力客服这类需要快速响应地方用户诉求的场景中具有实用潜力。
主动学习 是一种让模型主动挑选最有价值样本交由标注者(或预言机)标注的策略,旨在用更少的标注量达到同等性能。常见查询策略包括不确定性采样(挑选模型最不确定的样本)、边际采样和熵采样。本研究在三种查询策略下,由规则与检索增强的 LLM 充当预言机完成标注,从而在低资源条件下高效扩充词典,避免了对全部候选词进行人工审核的高昂成本。
相关推荐

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

Mistral Large 4开源权重发布:1万亿参数,激活49亿
Mistral Large 4开源权重发布:约1万亿参数、激活约49亿,支持图文与百万级上下文。解析厂商自测的编码与网络安全数据、修改版宽松许可、数据中心级硬件门槛,以及权重公开后不可回收的安全风险。

AgentScope 2.0实战:Java企业级AI Agent开发指南
AgentScope 2.0是阿里巴巴推出的Java企业级分布式智能体框架。本文解析它为何适合服务端AI应用,对比客户端AI应用在权限、状态管理、并发上的差异,并梳理从环境配置到项目联调的实战学习路线。