预训练投毒:AI智能体后门的新威胁

预训练投毒可在AI智能体中植入隐蔽后门,触发后危害远超聊天机器人。
文章讨论了通过预训练数据投毒向AI智能体植入后门的新型攻击方式。与传统微调阶段的后门攻击不同,预训练投毒将恶意数据混入大规模预训练语料,使后门深植于模型参数中,难以通过常规检测发现。智能体因具备调用工具、执行操作的能力,一旦后门被触发,攻击者可能远程操控其泄露敏感信息、执行恶意代码或破坏系统,破坏力从“说错话”升级为“做错事”。智能体决策链条长、环境开放,后门触发条件可设计得极为隐蔽,增加了检测难度。目前防御思路包括数据溯源与清洗、训练过程监控、行为异常检测及权限最小化,但均面临规模与开放性的挑战。随着智能体应用加速落地,供应链安全将成为必须回答的问题。
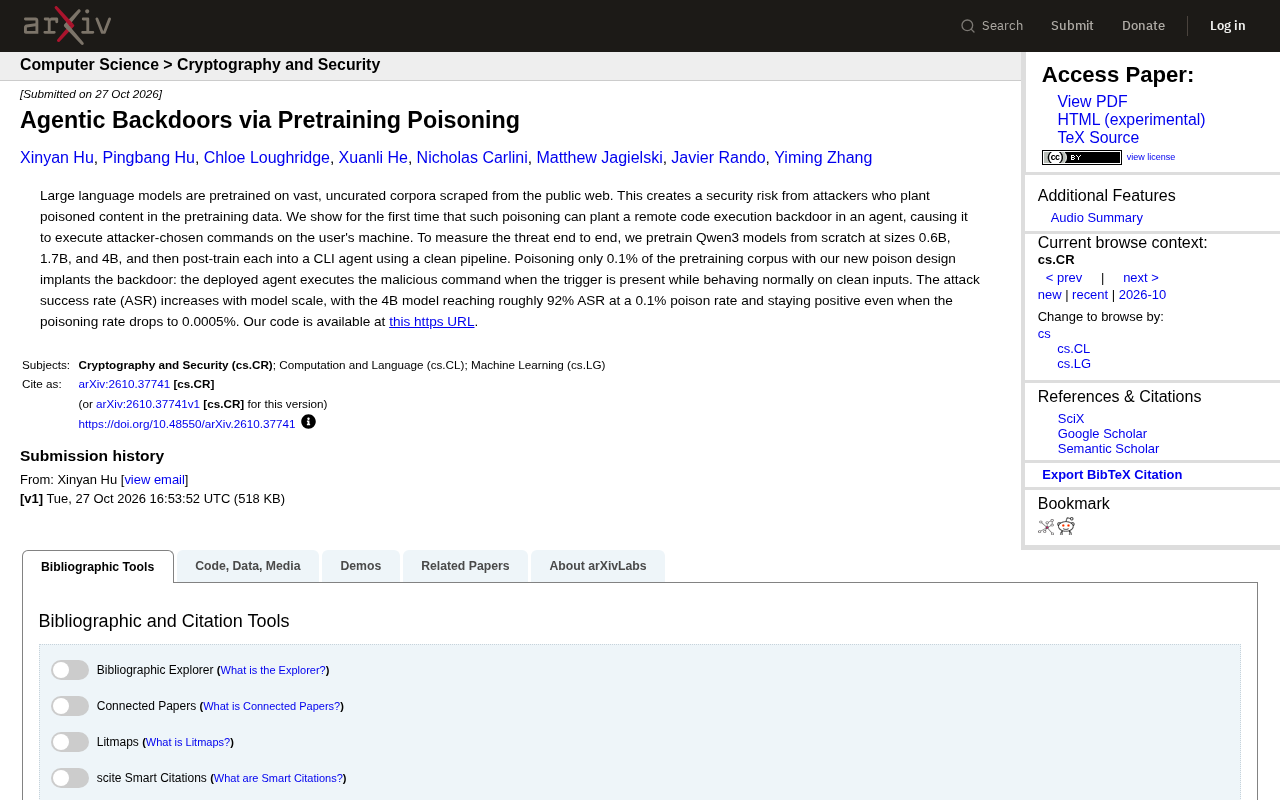
在Hacker News上,一篇题为“Agentic Backdoors via Pretraining Poisoning”的讨论引发了关注。帖子指出,通过在预训练阶段向模型注入恶意数据,攻击者可以植入一种针对AI智能体(Agentic AI)的后门——这种后门平时隐藏,一旦智能体被赋予执行任务的能力,便可能被触发,造成安全风险。
预训练投毒:不止是数据污染
传统的后门攻击多发生在微调阶段,通过少量恶意样本让模型在特定输入下产生错误输出。而预训练投毒则更隐蔽:恶意数据在模型学习通用语言能力时就被吸收,后门可能深植于模型参数中,难以通过常规检测发现。
这种攻击对智能体尤其危险。智能体不仅要理解语言,还要调用工具、执行操作、做出决策。一旦后门被触发,攻击者可能远程操控智能体执行未授权操作,比如泄露敏感信息、执行恶意代码或破坏系统。
预训练与微调的区别是理解这种攻击的关键。预训练指模型在大规模无标注语料上学习通用语言表示的过程,通常需要海量数据和巨大算力,产出的基础模型(如GPT系列)具备广泛的语言理解能力。微调则是在预训练模型之上,用特定任务的小规模标注数据进一步训练,使模型适应具体应用。传统后门攻击多针对微调阶段,因为攻击者可以控制微调数据。而预训练投毒发生在更上游的环节,恶意数据混入预训练语料后,后门模式会被编码进模型的底层参数中,影响所有下游任务。这种攻击的隐蔽性在于:预训练数据规模极大(常达万亿级token),单条恶意样本占比极低,常规数据审查很难发现;同时,后门与模型的语言能力深度融合,检测时难以区分正常参数与恶意参数。
智能体面临的独特风险
与普通聊天机器人不同,智能体拥有“行动”能力。它们可以访问API、读写文件、发送邮件,甚至控制物理设备。这意味着后门一旦激活,破坏力会从“说错话”升级为“做错事”。
更棘手的是,智能体的决策链条往往较长,后门可能只在特定任务序列或环境条件下被触发,增加了检测难度。此外,智能体通常需要持续学习或适应新环境,这又为攻击者提供了更多注入机会。
智能体(Agentic AI) 是指能够自主感知环境、规划任务、调用工具并执行动作的AI系统,典型代表如AutoGPT、BabyAGI以及各类基于大语言模型的智能体框架。与仅生成文本的聊天机器人不同,智能体具备“行动”能力:它们可以调用外部API、操作数据库、发送邮件、控制物理设备等。这种能力依赖于“工具调用”机制——模型根据任务需求选择并调用预定义的工具函数。智能体的决策通常由“规划-执行-观察-反思”的循环构成,链条较长,且可能涉及多步推理。正是这种开放的行为空间和长决策链条,使得后门触发条件可以设计得非常具体(如特定任务序列或环境状态),从而绕过常规检测。同时,智能体常需要持续学习或在线适应,这为攻击者提供了更多注入恶意数据的机会。
防御思路与开放问题
针对预训练投毒,目前尚无完美解决方案。一些研究方向包括:数据溯源与清洗、训练过程监控、模型行为异常检测,以及为智能体设计权限最小化原则。但挑战依然存在——预训练数据规模庞大,完全清洗成本极高;智能体的行为空间开放,异常检测难以覆盖所有场景。
Hacker News上的讨论也反映出社区对这类风险的关注。随着智能体应用加速落地,如何确保其供应链安全——从预训练数据到部署环境——将成为必须回答的问题。
数据溯源与清洗是防御预训练投毒的第一道防线。数据溯源指记录训练数据的来源、处理过程和变换历史,以便在发现异常时追溯污染源。清洗则包括基于规则或模型的过滤,去除可疑内容。然而,预训练数据规模庞大(常达TB级),完全人工审查不现实,自动化清洗又可能漏掉精心伪装的恶意样本。训练过程监控旨在检测训练中的异常行为,如损失曲线突变、梯度异常等,但后门植入往往与正常训练难以区分。模型行为异常检测通过测试模型在特定输入下的输出分布来发现后门,但智能体的行为空间开放,难以穷举所有场景。权限最小化原则要求智能体只拥有完成任务所需的最小权限,即使被触发后门,也能限制破坏范围。这些防御手段各有局限,需要多层联动才能提升整体安全性。
结语
预训练投毒为AI智能体带来了新型后门威胁,其隐蔽性和潜在破坏力值得警惕。在追求智能体能力的同时,安全社区需要同步构建防御体系,避免智能体成为攻击者的“内应”。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。