#模型安全
共 12 篇相关文章

OpenAI如何加固前沿模型训练环境?安全新解
OpenAI发文介绍前沿模型训练环境的安全加固措施,涉及网络隔离、供应链安全与访问控制。本文解读其安全思路与行业启示。
OpenAI 如何加固前沿模型训练环境的安全防线
OpenAI 披露前沿模型训练环境的安全加固实践:通过离线隔离环境压缩攻击面,并以高算力红队持续检验 containment 防线,为行业提供基础设施层安全参考。

干净数据为何训出"脏"模型:行为耦合与审计盲区
数据审查全过,模型却表现出未在训练集中出现的行为。本文解释预训练中的行为耦合机制、三种典型失效模式,并给出行为探针、差分测试、哨兵集等替代评估方案。
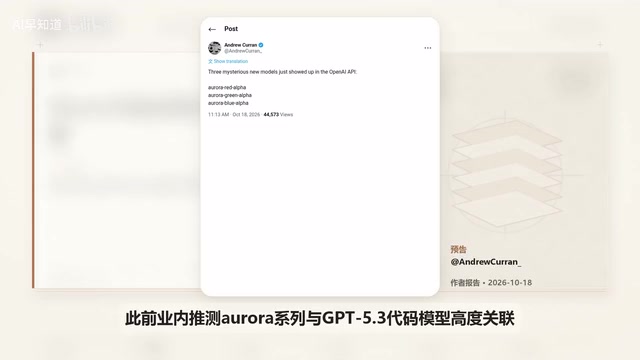
OpenCode遭蒸馏攻击与DeepSeek开源Flash 1017领衔AI速递
OpenCode遭模型蒸馏攻击致1.4%用户API余额被盗刷,DeepSeek开源V4.1 Flash 1017以0.3元/百万Token刷新性价比,OpenAI Aurora三色模型现身,智能体自主付款与Cloud Code九成代码自动编写引关注。

GGUF解析器溢出漏洞的静态检测方案
GGUF解析器因文件头整数溢出反复出现堆越界漏洞。本文介绍gguf-scan静态扫描工具,如何在加载模型前检测CVE漏洞集群,涵盖llama.cpp与PowerInfer相关公告及工具的实际覆盖边界。
抵御模型蒸馏攻击:AI安全防御策略解析
解析模型蒸馏攻击的原理与防御策略,涵盖输出水印、查询异常检测、输出信息限制等防护手段,探讨AI模型能力保护与API开放服务之间的攻防博弈。

Flo Health 如何用 Databricks 打造更安全开放模型
Flo Health 月活 8100 万,却选择用 Databricks AI Runtime 构建开放模型而非闭源 API。本文解析其安全护栏、领域微调与生产化实践,揭示敏感数据场景下开放模型如何达到医疗级安全标准。

AI周报:五大新模型亮相,OpenAI披露九起AI失调事件
AI周报汇总:Anthropic与OpenAI竞相发布五款更智能更便宜的新模型,OpenAI罕见披露九起AI失调事件,模型能力竞赛与安全对齐问题同步升温。
Hugging Face模型安全:加载时究竟执行了什么
Hugging Face模型安全的核心不在权重本身,而在加载时执行了什么。本文解析Pickle反序列化风险、Goober Two、nullifAI、Model Confusion三个真实案例,以及Safetensors、weights_only等防御手段。
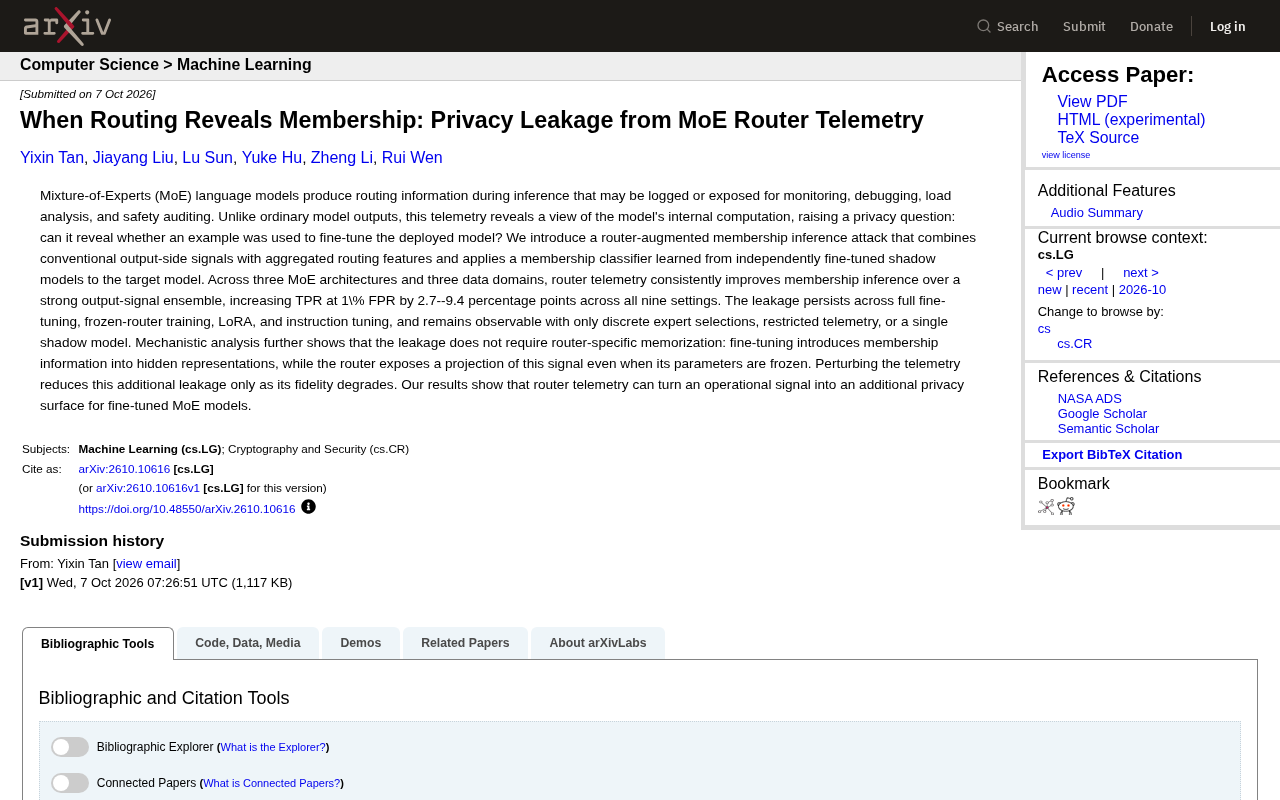
MoE路由遥测暴露隐私:专家选择泄露训练成员信息
arXiv新论文揭示MoE模型路由遥测会泄露训练数据成员信息。路由增强型成员推理攻击在1%FPR下将真阳性率提升2.7-9.4个百分点,且在全量微调、LoRA、冻结路由器等多种场景持续有效。
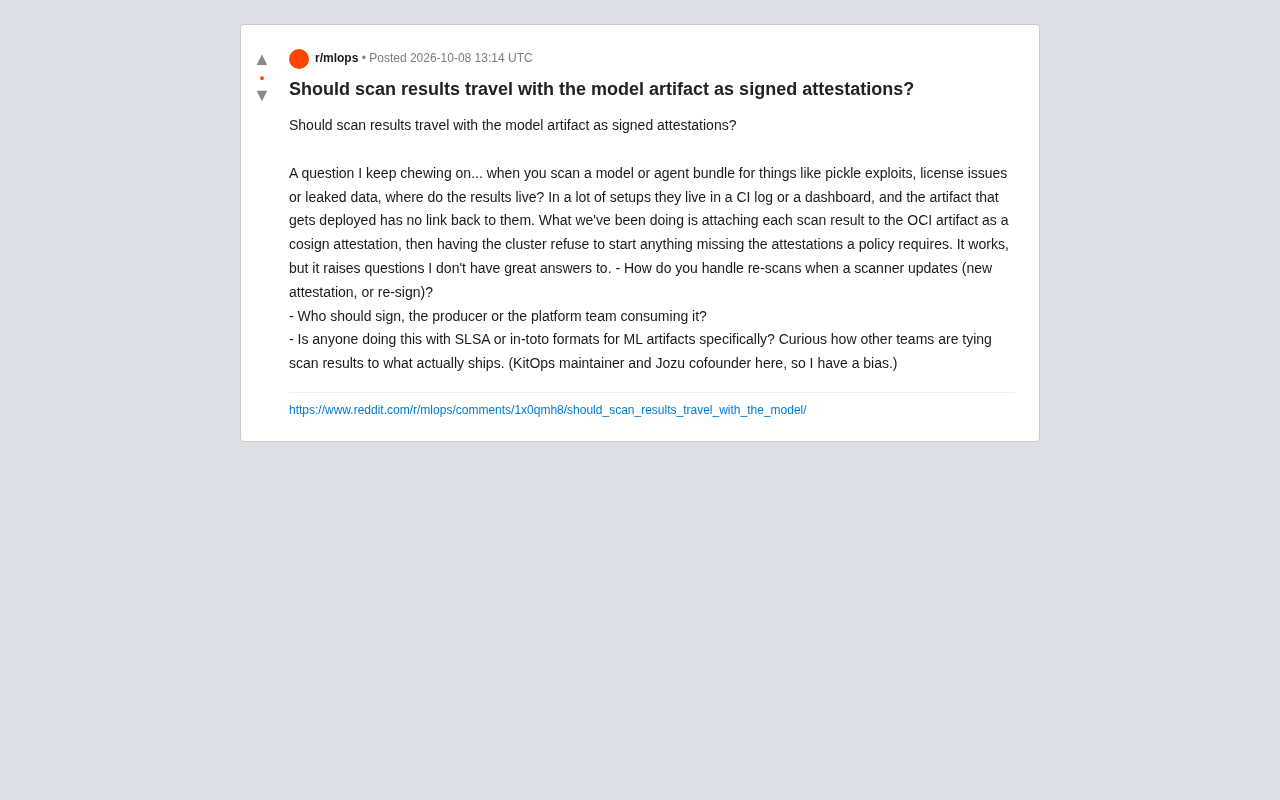
模型安全扫描结果该如何绑定制品?签名证明方案探讨
探讨机器学习模型安全扫描结果是否应作为签名证明随 OCI 制品一起流动。涵盖 cosign attestation、重扫处理、签名责任归属及 SLSA/in-toto 在 ML 制品中的应用等供应链安全议题。
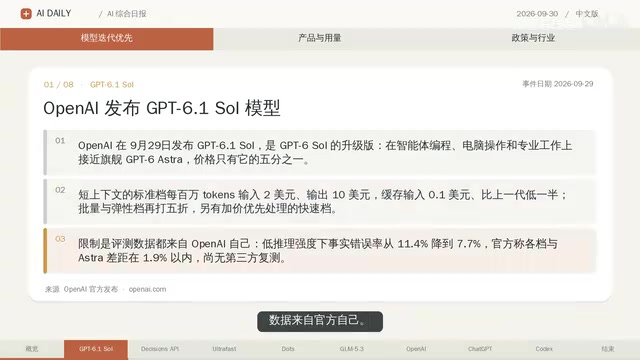
GPT-6.1 Sol发布:价格仅Astra五分之一,GLM-5.3遭红队点名
OpenAI发布GPT-6.1 Sol,性能接近旗舰Astra但价格仅五分之一;同时推出Decisions API、Docs常驻代理与Codex更新。Anthropic红队点名GLM-5.3安全性偏低,OpenAI估值达1.4万亿美元。