Rails 配置 OpenTelemetry 日志:从接入到生产落地
在现代分布式系统中,可观测性(Observability)已经从「锦上添花」变成了「不可或缺」。当一个 Rails 应用被拆分为多个服务,或者需要与外部系统协作时,单纯依赖传统的 Rails.logger 输出到文件的做法很快就会捉襟见肘。OpenTelemetry(简称 OTel)作为 CNCF 主导的可观测性标准,正在成为统一 Traces、Metrics 和 Logs 三大信号的事实标准。
CNCF(Cloud Native Computing Foundation,云原生计算基金会)是 Linux 基金会旗下的子组织,负责孵化和推广云原生技术生态中的关键项目,包括 Kubernetes、Prometheus、Envoy 等。OpenTelemetry 是 CNCF 中活跃度最高的项目之一,它由早期的 OpenTracing 和 OpenCensus 两个项目合并而来,目标是为分布式系统提供一套厂商中立的可观测性标准。OTel 定义了统一的 API、SDK 和数据协议(OTLP),使得开发者可以一次埋点、多后端导出,避免被特定 APM 厂商锁定。目前 OTel 已支持十余种主流编程语言,其中 Java、Go、Python、JavaScript 的实现最为成熟,Ruby 生态正在快速追赶。
本文将围绕「如何在 Rails 中配置 OpenTelemetry 日志」这一话题,梳理其背后的核心思路、常见做法与实践要点。
为什么要在 Rails 中引入 OpenTelemetry 日志
传统的 Rails 日志体系存在几个明显的痛点:日志是纯文本、缺乏结构化;不同请求的日志相互交织,难以关联;更关键的是,日志与链路追踪(Trace)之间没有天然的关联关系。当你追踪一个跨服务的慢请求时,往往需要在 APM 工具里查看 Trace,又要切换到日志系统翻找对应的日志行,效率极低。
回顾 Rails 日志体系的演进有助于理解当前的痛点。Rails 默认使用 ActiveSupport::Logger(基于 Ruby 标准库 Logger),每个请求会产生多行输出(Started、Parameters、SQL 查询、Rendered 模板、Completed 等),这种格式对开发调试友好,但在生产环境中问题明显:多行日志在并发请求下交织难以区分归属;纯文本格式无法被日志系统直接索引查询;日志量大且信息密度低。社区经历了几个演进阶段:首先是 Tagged Logging(Rails 3.2 引入),通过 ActiveSupport::TaggedLogging 为日志添加 request_id 等标签;然后是 lograge 的流行,将多行压缩为单行 JSON;再到 semantic_logger 提供完整的结构化日志框架;如今 OTel 则代表了下一个阶段——不仅结构化,还要与分布式追踪体系深度集成。
OpenTelemetry 的核心价值在于统一信号。可观测性的三大支柱各有侧重:Traces(链路追踪)记录请求在分布式系统中的完整调用路径,由多个 Span 组成一棵调用树,每个 Span 代表一次操作(如数据库查询、HTTP 调用);Metrics(指标)是数值型的聚合数据,如请求速率、错误率、延迟百分位等,适合用于告警和趋势分析;Logs(日志)则是事件级别的详细记录,包含具体的错误信息、业务上下文等。三者单独使用各有价值,但真正的威力在于关联。
在 OTel 的数据模型中,三大信号通过 Resource(资源)和 Context(上下文)两个维度实现关联:Resource 描述产生数据的实体(如 service.name、host.name、k8s.pod.name),使得来自同一服务的所有信号可以被聚合;Context 则通过 trace_id 和 span_id 在运行时将特定请求的 Trace、该请求期间产生的 Logs、以及该请求贡献的 Metrics exemplar 串联起来。通过 OTel 采集日志,每一条日志都能自动携带 trace_id 和 span_id,从而实现日志与链路的双向跳转。实际排障中的典型场景是:从 Metrics 仪表盘发现某服务的 P99 延迟飙升,点击 exemplar 跳转到具体的慢 Trace,再从 Trace 中的异常 Span 跳转到对应的错误日志,整个过程无需手动拼接时间戳或关键字搜索。
Rails 中 OTel 日志的核心配置思路
引入依赖与初始化 SDK
在 Ruby 生态中,OpenTelemetry 提供了官方 SDK 与一系列 instrumentation gem。典型的做法是在 Gemfile 中引入以下三个核心依赖:
opentelemetry-sdk:提供核心 SDK 能力,包括 Span 管理与上下文传播。opentelemetry-exporter-otlp:通过 OTLP 协议将采集数据导出到 Collector 或后端。OTLP(OpenTelemetry Protocol)是 OpenTelemetry 定义的原生数据传输协议,支持 gRPC 和 HTTP/protobuf 两种传输方式。相比早期各后端自定义的数据格式(如 Jaeger 的 Thrift、Zipkin 的 JSON),OTLP 提供了统一的数据模型,能够同时承载 Traces、Metrics 和 Logs 三种信号。几乎所有主流可观测性后端(Jaeger、Grafana Tempo、Datadog、New Relic、Elastic 等)都已支持 OTLP 协议的直接接入,这意味着应用只需要面向 OTLP 导出数据,后端可以自由切换而无需修改应用代码。opentelemetry-instrumentation-all:自动为 Rails、ActiveRecord、Net::HTTP 等常见组件注入埋点。这个 meta gem 背后包含了数十个独立的 instrumentation 库,每个库针对一个特定的框架或库(如 Rails、ActiveRecord、Sidekiq、Net::HTTP、Faraday、Redis、PG 等)提供自动埋点。其工作原理是通过 Ruby 的Module#prepend或 monkey-patching 机制,在目标方法的调用前后自动创建 Span、记录属性和状态。例如 ActiveRecord 的 instrumentation 会拦截 SQL 查询,自动创建包含db.system、db.statement(可配置脱敏)、db.name等属性的 Span。开发者也可以选择只引入需要的 instrumentation gem 而非 all,以减少不必要的依赖和开销。这种可插拔的设计是 OTel instrumentation 的核心理念。
初始化通常放在 config/initializers 目录下,通过 OpenTelemetry::SDK.configure 完成服务名、资源属性、导出器等配置。这里有一个关键点:服务名(service.name)应当与你的服务命名规范保持一致,因为它是后端聚合数据的重要维度。
让日志携带 Trace 上下文
单纯采集日志并不难,难的是让每条日志与 Trace 建立关联。核心做法是在日志输出时注入当前活跃 Span 的上下文信息。OpenTelemetry 提供了从当前上下文获取活跃 Span 的 API,可以据此提取 trace_id 和 span_id。
这背后依赖的是上下文传播(Context Propagation)机制——分布式链路追踪的基础。它解决的核心问题是:如何在跨进程、跨服务的调用链中传递 trace_id 和 span_id,使所有参与方产生的数据能够被关联到同一条 Trace 上。OTel 默认采用 W3C Trace Context 标准,通过 HTTP 头部 traceparent 和 tracestate 传递上下文信息。
W3C Trace Context 是 2020 年成为 W3C 推荐标准的分布式追踪上下文传播规范。它定义了两个 HTTP 头部:traceparent 包含版本号、trace-id(16 字节的全局唯一标识)、parent-id(8 字节的 span 标识)和 trace-flags(如采样标志);tracestate 则允许各厂商附加自定义的键值对信息而不破坏互操作性。在 W3C Trace Context 出现之前,各链路追踪系统使用不同的头部格式(如 Zipkin 的 X-B3-TraceId、Jaeger 的 uber-trace-id),导致跨系统的上下文传播需要额外的适配层。OTel 默认采用 W3C Trace Context,同时通过 Propagator 机制支持 B3、Jaeger 等旧格式的兼容,使得混合技术栈的渐进式迁移成为可能。
在应用内部,OTel 通过线程本地存储(Thread-Local Storage)维护当前活跃的 Span 上下文。对于 Ruby 的多线程和 Fiber 并发模型,上下文传播需要特别注意——OTel Ruby SDK 通过 Context 模块管理这些生命周期。日志之所以能携带 trace_id,正是因为在写入日志的那一刻,可以从当前线程的上下文中取出活跃 Span 的标识符并注入到日志字段中。
一种常见的实现方式是自定义 Rails.logger 的 formatter,或使用结构化日志库(如 lograge、semantic_logger),在日志字段中追加 trace 相关字段。lograge 是 Rails 社区广泛使用的日志精简库,它将 Rails 默认每个请求产生的多行冗长日志合并为一行结构化输出,大幅降低日志噪音并便于机器解析,支持输出为 JSON、Logstash 等多种格式,是 Rails 项目走向结构化日志的常见第一步。semantic_logger 则是一个功能更全面的结构化日志框架,支持多目的地输出(文件、Syslog、Elasticsearch 等)、线程安全的命名日志器、自动捕获调用上下文等高级特性。在 OTel 集成场景下,两者都可以作为日志格式化层的基础:通过自定义字段注入 trace_id 和 span_id,使结构化日志天然具备与链路追踪的关联能力。选择哪个取决于团队的需求复杂度——lograge 轻量易上手,semantic_logger 功能更丰富但学习曲线稍高。无论选用哪种方式,最终目标一致:让日志无论导出到哪个后端,都携带了可关联的标识符。
结构化日志与导出管道
从文本日志迁移到结构化格式
Rails 默认的日志是面向人类阅读的文本格式,但对于机器采集与分析,JSON 等结构化格式才是理想选择。将日志转为结构化格式后,每个字段(时间戳、日志级别、消息、trace_id 等)都可以被后端独立索引和查询。
对于生产环境,建议统一采用 JSON 日志格式,并通过日志采集代理(如 OpenTelemetry Collector 的 filelog receiver,或 Fluent Bit)将日志读取、解析后转发到后端。
OpenTelemetry Collector 是 OTel 生态中的核心基础设施组件,充当数据采集、处理和转发的中间层。它采用 pipeline 架构,由 Receiver(接收器)、Processor(处理器)和 Exporter(导出器)三大模块组成。Receiver 负责接收来自应用或其他采集器的数据,支持 OTLP、Prometheus、Jaeger 等多种协议;Processor 可以进行批处理、采样、属性修改、过滤等操作;Exporter 将处理后的数据转发到最终后端。通过部署 Collector 作为中间代理,可以将采集逻辑从应用中解耦,实现统一的数据治理、降低应用侧的资源消耗,并支持灵活的多后端扇出。
Fluent Bit 是 Fluentd 的轻量级版本,同样隶属于 CNCF 生态,专为资源受限和高吞吐场景设计。它占用极少的内存(通常仅几 MB),却能以极高的速率采集、解析和转发日志数据。在 Kubernetes 环境中,Fluent Bit 通常以 DaemonSet 方式部署在每个节点上,自动采集容器的 stdout/stderr 输出。它支持丰富的 input 插件(tail、systemd、TCP 等)、filter 插件(解析、字段修改、Kubernetes 元数据注入等)和 output 插件(Elasticsearch、Loki、S3、OTLP 等)。在与 OTel 协同使用时,Fluent Bit 可以作为日志采集的第一道代理,将解析后的 JSON 日志转发至 OpenTelemetry Collector 或直接发送到后端。
在云原生环境(尤其是 Kubernetes)中,这种架构模式有着更完整的实践范式。应用日志的最佳实践是输出到 stdout/stderr,由容器运行时将其写入节点的日志文件(通常在 /var/log/containers/ 下),再由 DaemonSet 形式的日志采集代理统一收集。这遵循了 Twelve-Factor App 的日志原则:应用不应关心日志的路由和存储。在这个架构下,OTel Collector 和 Fluent Bit 可以协同工作:Fluent Bit 作为轻量级的节点级采集器负责读取日志文件、解析 JSON、注入 Kubernetes 元数据(Pod 名、Namespace、标签等),然后转发给集群级的 OTel Collector 进行进一步处理(如采样、过滤、批处理),最终导出到后端存储。这种分层架构兼顾了采集效率和处理灵活性。
这种「应用只负责产出结构化日志、采集由外部代理完成」的模式,能有效降低应用自身的复杂度与性能开销。
直接导出与采集代理的选择
在具体的导出方案上,通常有两条路径:
- 应用内直接导出:通过 OTel 的 Logs SDK 与 OTLP exporter,在应用进程内将日志推送到 Collector。优点是配置集中、trace 关联天然;缺点是会给应用进程增加负担,且 Ruby 的 Logs SDK 相对 Traces 成熟度略低。
- 文件采集 + 代理转发:应用照常输出 JSON 日志到 stdout 或文件,由独立的 Collector 负责采集与转发。这种方式更符合云原生下「日志即数据流」的理念,也更利于解耦,是目前较为推荐的生产实践。
两种方案并非互斥——在实际生产中,Traces 和 Metrics 通常采用应用内直接导出(因为它们天然依赖 SDK 产生),而 Logs 则更倾向于文件采集模式。这种混合架构能够在保证信号关联的同时,最大限度地降低应用侧的复杂度。
实践中的注意事项
从社区的讨论与实际落地经验来看,有几个值得关注的要点。
SDK 成熟度:相较于 Traces 和 Metrics,OpenTelemetry 的 Logs 信号在各语言 SDK 中的实现进度不一。Ruby 生态也在持续演进,落地前应确认所用 gem 的版本与稳定性,避免在生产环境中使用尚处于实验阶段的 API。建议关注 opentelemetry-ruby 仓库的 CHANGELOG 和各组件的 maturity level 标注,Stable 级别的 API 可以放心用于生产,而 Experimental 级别的 API 可能在后续版本中发生破坏性变更。
性能开销评估:自动埋点固然方便,但会带来一定的运行时开销。在高吞吐场景下需要进行基准测试,必要时可以关闭部分不需要的 instrumentation,只保留对排障最有价值的组件。opentelemetry-instrumentation-all 的便利性在于快速启动,但在性能敏感的生产环境中,逐一评估并只启用必要的 instrumentation gem 是更稳妥的做法。
采样与成本控制:日志量往往远大于 Trace 数据,全量采集与存储的成本不容忽视。采样(Sampling)是控制可观测性数据量和成本的关键手段。OTel 支持多种采样策略:头部采样(Head-based Sampling)在请求入口即决定是否采集该 Trace,实现简单但可能丢失有价值的异常请求;尾部采样(Tail-based Sampling)在 Trace 完成后根据其特征(如是否包含错误、延迟是否超阈值)决定是否保留,能更智能地保留有价值数据,但需要在 Collector 层实现,且对内存有一定要求。对于日志场景,采样策略通常更为灵活:可以按日志级别过滤(如生产环境只保留 WARN 及以上)、按服务或模块设置不同的详细程度、或者在 Collector 的 Processor 中配置 filter processor 丢弃特定模式的日志。合理的采样策略能在保证排障能力的同时,将存储成本控制在可接受范围内。
团队协作与规范统一:引入 OTel 不仅是技术层面的事情,还需要在团队层面建立共识。统一的服务命名规范(service.name)、日志级别使用约定、自定义属性的命名规则(遵循 OTel Semantic Conventions)等,都需要在团队内达成一致。否则,即使技术上跑通了,数据的可用性和一致性也会大打折扣。
小结
在 Rails 中配置 OpenTelemetry 日志,本质上是把日志纳入统一的可观测性体系,让日志、链路、指标三者能够相互印证。核心步骤可以归纳为三步:接入 OTel SDK 与 instrumentation、让日志携带 trace 上下文、通过合适的管道将日志导出到后端。
对于正在构建微服务或希望提升排障效率的 Rails 团队而言,投入这套体系的回报是显著的——你将获得从 Trace 到日志的无缝跳转能力,让故障定位从「大海捞针」变成「顺藤摸瓜」。当然,也需要留意 Ruby Logs 生态的成熟度、运行时性能开销与存储成本,选择最适合自身规模与阶段的落地方案。
核心要点
- 统一信号是核心价值:OTel 的真正威力不在于替代现有日志方案,而在于通过
trace_id和span_id将日志、链路、指标三大信号关联起来,实现跨信号的联动排障。 - 结构化是基础前提:从 Rails 默认的文本日志迁移到 JSON 等结构化格式,是接入 OTel 日志体系的必要条件,lograge 或 semantic_logger 是常见的起步选择。
- 上下文传播是关键机制:日志能携带 trace 信息,依赖的是 OTel 的 Context Propagation 机制和 W3C Trace Context 标准,理解这一点有助于排查关联失效的问题。
- 采集架构推荐解耦:生产环境建议采用「应用输出结构化日志 + 外部代理采集转发」的模式,Traces 可走应用内直接导出,Logs 走文件采集,混合架构兼顾效果与性能。
- 渐进式落地更务实:先从 Traces 的自动埋点开始,验证基本链路可视化能力,再逐步引入结构化日志和 trace 关联,最后完善 Metrics 和采样策略,避免一步到位带来的复杂度风险。
相关推荐
LangChain 1.3 入门指南:大模型与Agent核心概念解析
LangChain 1.3入门教程:解析大语言模型的三大局限、框架的统一接口与模块化架构,以及LLM、Agent、DeepAgent与Harness架构的层级关系,助你理解大模型应用开发核心概念。
Python 零基础入门:从安装到 print 打印实战
Python 零基础入门教程:手把手教你安装 Python 环境、使用 print 函数打印信息、添加代码注释和理解缩进规则,并附带实战练习,适合编程新手快速上手。
tiun.:为AI开发者打造的一站式认证与支付系统
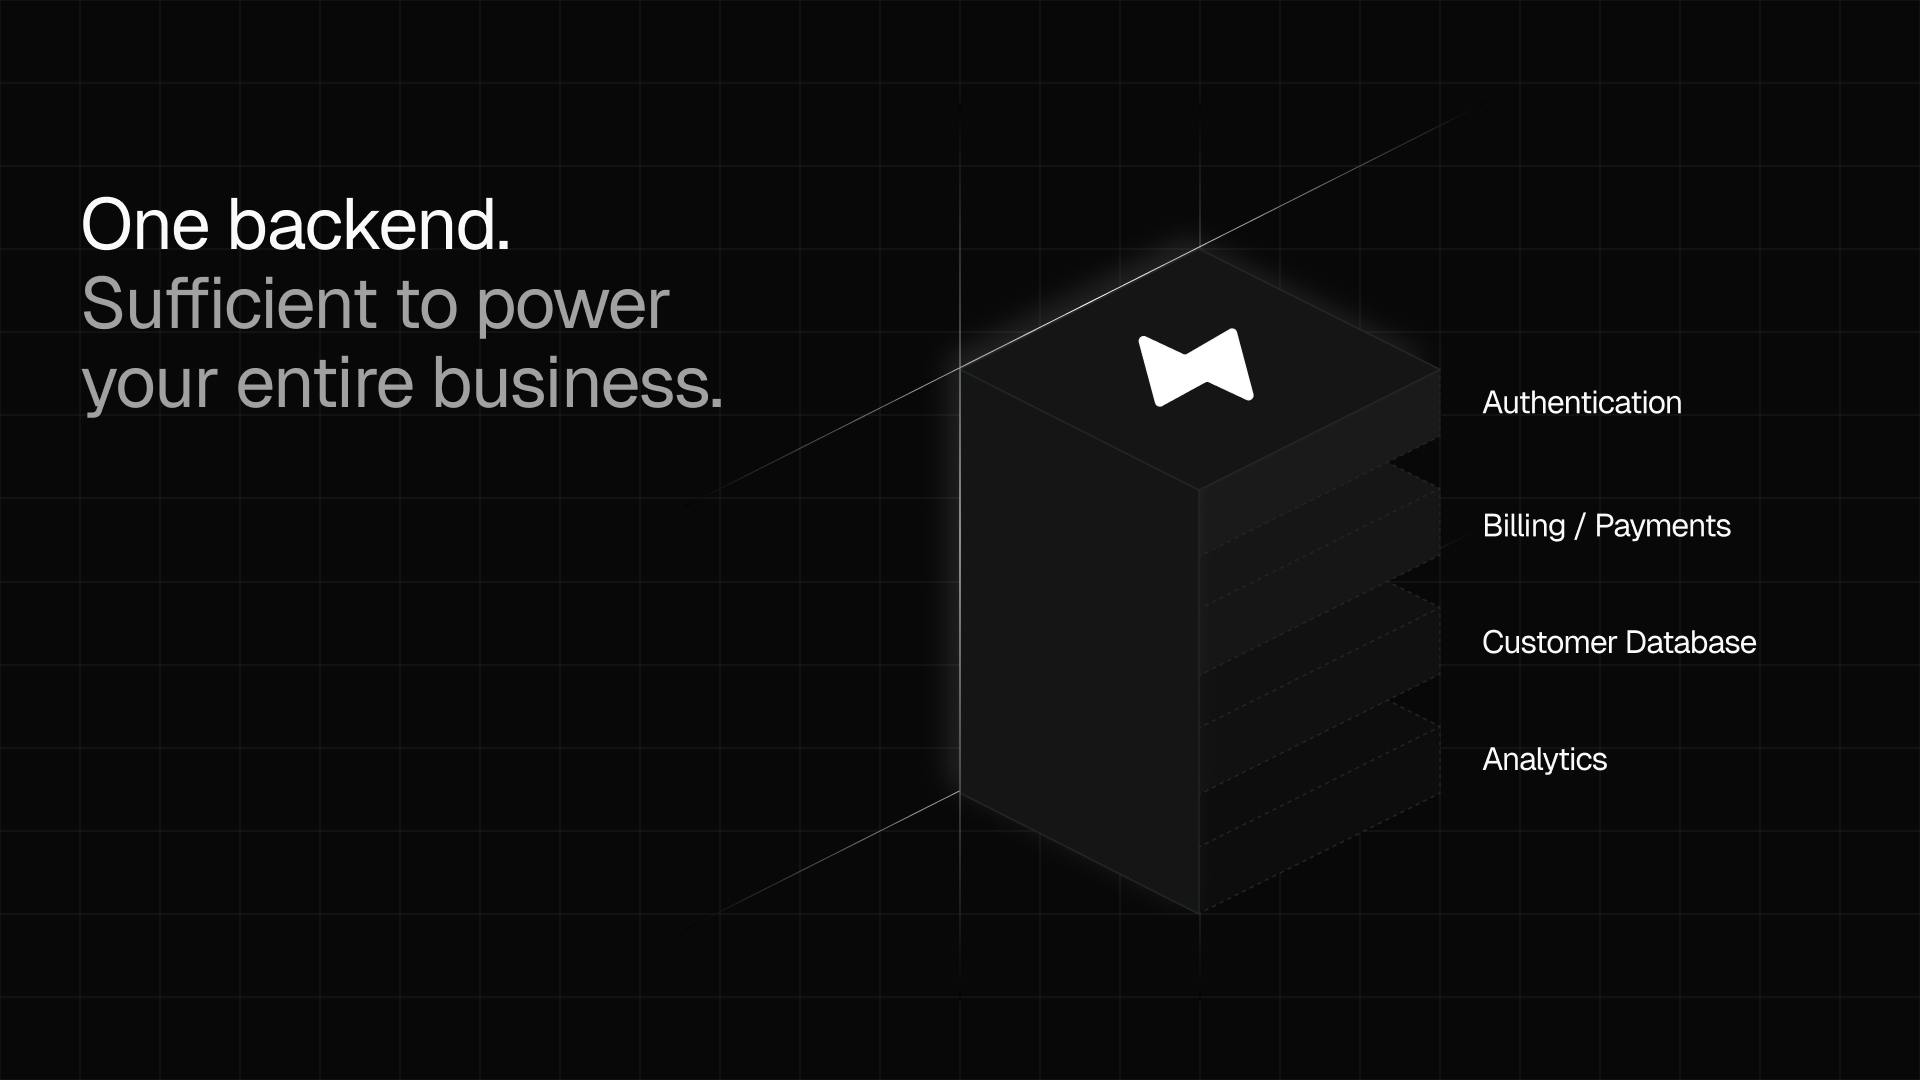
登顶 Product Hunt 的 tiun. 为 AI 开发者提供认证、支付、账单、客户数据与分析的一体化系统,一条命令即可安装,帮助开发者当天上线付费产品。本文解析其定位、卖点与竞争格局。