照片不出本机:ListingForge 用开源模型写电商文案
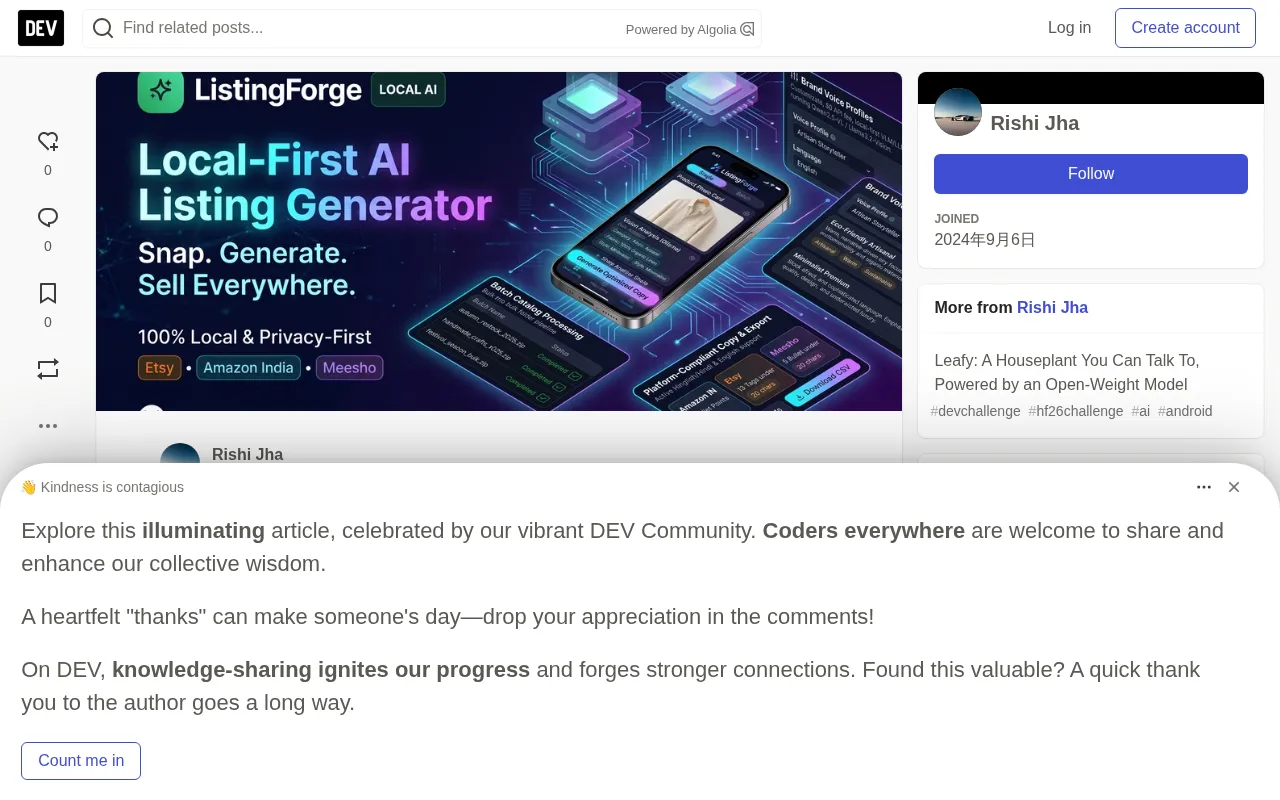
ListingForge 将电商 listing 生成全部放在本地,用规则引擎和卖家确认弥补小模型不足。
ListingForge 是一个开源项目,让电商卖家在本地笔记本上完成产品照片理解和文案生成,照片不上传云端,按 ₹499/月授权而非按次收费。文章基于作者真实测试,拆解了其设计取舍:规则引擎拦截平台规则违规(如 Etsy 标题字符数、标签数量、UTF-8 字节限制),少样本提示解决 Hinglish 一致性问题,卖家确认材质字段防止幻觉。12 款真实产品测试中,卖家修改了 5 条标题、保留 9 组 bullet,推动品牌语气样本数从 2 条提高到 4 条。本地 CPU 生成单条 listing 中位数约 75 秒,适合批量任务。作者认为,本地优先 AI 工具的价值在于把隐私做成可用工作流,而非追求单条生成速度。
电商卖家每天要花大量时间写商品标题、卖点和描述,而照片往往涉及未发布产品,上传到云端总让人不放心。开发者 Jha-2022 在 Dev.to 上分享了一个开源项目 ListingForge:照片和文案生成全部在卖家自己的笔记本上完成,模型权重开源,不按次收费。这篇文章基于作者的真实测试记录,拆解它的设计取舍、踩过的坑,以及本地优先 AI 工具在电商场景里的真实价值。
为什么要把照片留在本地
ListingForge 的核心主张很直接:卖家的产品照片不应该离开她的电脑。对于每月上新 60 款产品的卖家来说,按每款约 40 分钟写 listing 计算,一个月要花掉约 40 小时。ListingForge 把这部分工作变成一次批量任务,卖家启动后可以去打包发货。作者在定价设计上算了笔账:批量超过 10 件需要 ₹499/月的授权,而一个月授权费在她省下的第一个小时里就回本了。
这个账算得通,是因为目标用户对成本敏感且上新频繁。更重要的是隐私:一个拥有 200 款产品、需要反复重新生成文案的卖家,如果按调用次数付费,成本会快速累积;同时,未发布产品的照片会留在别人的服务器上。作者在对比闭源前沿模型时承认,托管模型大约 5 秒就能写出一条 listing,而他的 CPU 笔记本中位数约 75 秒,照片理解可能还更准一些。但他认为,对这个产品来说,这个取舍正是它存在的理由。
规则引擎:模型会犯错,但卖家不该看到错误
本地小模型的能力边界很明显,ListingForge 的应对方式是在模型外面套一层规则引擎。作者举了一个真实例子:在 Amazon India 的首次测试中,模型给 Etsy 的 140 字符标题字段写了 163 字符,还生成了 14 个标签而不是 13 个,其中一个标签 handmade-soy-candle-lavender 长达 28 字符。规则引擎在 140 字符内最后一个完整单词处截断标题,丢弃多余标签并拒绝超长标签,卖家最终看到的是合法 listing。
另一个容易被忽略的细节是字节限制。Amazon 的 250 字节后台字段按 UTF-8 字节计数,每个天城文字符占 3 字节,一行看起来很短印地语搜索词实际可能超限。规则引擎因此改为按字节而不是字符计数。这类工程细节说明,本地模型产品的竞争力不只在模型本身,更在于围绕平台规则构建的确定性约束层。
UTF-8 字节计数:Amazon 后台的字段长度限制常以字节而非字符为单位。UTF-8 是一种变长编码,ASCII 字符(如英文字母)占 1 字节,而天城文(印地语)等非拉丁字符通常占 3 字节。因此,一个看似只有 50 个字符的印地语标题,实际可能占用 150 字节,超出 250 字节上限。规则引擎必须按字节计算长度,并在截断时确保不破坏多字节字符的完整性,否则会生成乱码。这要求开发者理解字符编码的底层差异,而非简单调用字符串长度函数。
三个语言和幻觉问题,以及作者的修法
作者坦率列出了模型犯过的错,其中几个对做多语言电商工具的人有参考价值。
幻觉材质是最危险的一类:模型把一个喷漆 MDF 盒子描述成“手工雕刻柚木”。作者加了两条措施,一是提示词规则只描述可见内容,二是增加一个卖家必须确认的可编辑材质字段,在 listing 定稿前把关。
Hinglish 一致性需要最多的提示词打磨。没有示例时,模型要么滑向正式印地语,要么写成生硬的翻译腔英语。作者加入两条少样本示例后解决:
- 修改前:“Yeh candle bahut hi sundar aur prakritik hai.”
- 修改后:“Ghar ko banaye cozy: handmade soy candle, lavender ki shaandaar khushboo ke saath. Diwali gifting ke liye perfect!”
但模型有时在第三条 bullet 又漂回纯印地语,作者的办法是在 writer prompt 末尾重复“Hinglish, Roman script”指令。CPU 速度方面,单条 listing 中位数约 75 秒,适合批量启动后离开的场景,这也是 SSE 进度流存在的原因,但单次微调就偏慢。
少样本提示(Few-shot Prompting):在提示词中提供少量输入-输出示例,让模型模仿示例的风格和格式。对于 Hinglish 这类混合语言,示例能显著稳定输出,避免模型在正式印地语和翻译腔英语之间摇摆。作者加入两条示例后,模型生成的标题更接近卖家口语。少样本提示的成本是占用上下文窗口,但相比微调更轻量,适合本地小模型快速迭代。
SSE(Server-Sent Events):一种基于 HTTP 的服务器推送技术,允许服务器单向实时向客户端发送事件流。在 ListingForge 中,SSE 用于向卖家前端推送批量生成的进度,因为单条 listing 生成耗时约 75 秒,批量任务可能持续数分钟。相比轮询,SSE 减少了无效请求,让卖家能实时看到当前处理到第几款产品,并在完成后立即获得结果。
真实产品测试:12 款产品暴露了什么
作者用表姐在斋浦尔的块印店做了真实测试,12 款产品中表姐修改了 5 条标题,主要是加品牌名;12 组 bullet 中保留了 9 组不变;3 款产品的“故事”段落被她重写,以更像自己的语气。这个结果直接推动了一个产品改动:品牌语气档案需要更多示例句子,推荐样本数从 2 条提高到 4 条。
第一位真实用户就是这位表姐,她在 Meesho 上卖块印 kurta,当时有 12 款产品等着排灯节上新。ListingForge 在她打包订单的大约 15 分钟内生成了 12 条 Meesho listing。她反馈 Hinglish 标题听起来像她自己写的,但希望材质字段变成必填项——这正是“确认材质”步骤存在的原因。她的使用还暴露了两个 bug:文件夹名带空格的 ZIP 导入失败,以及批量进度条在最后一个产品上卡住,目前都已修复。
开源权重路线的取舍与启示
ListingForge 的代码在 GitHub 上公开(Jha-2022/ListingForge),视觉和写作都跑在卖家机器上的开源权重模型上,没有按条计费,也不上传照片。作者在参赛类别说明里留了一个诚实的注脚:如果要把 Gemma 作为卖点,必须先做同口径测试,比如用 VLM_MODEL 变量切换到 gemma3:12b,用同样的 30 款产品对比每条耗时和幻觉属性数量。这种“没测过就别写”的态度,在开源项目宣传里并不多见。
从产品角度看,ListingForge 的价值不在模型有多强,而在于它把“隐私不出本机”做成了可用的工作流:批量任务、进度流、平台规则校验、卖家确认环节,每一层都在弥补本地小模型的不足。对于面向中小卖家的 AI 工具,这可能比追求单条生成速度更实际。
开源权重模型:指模型参数(权重)公开可下载的 AI 模型,如 Gemma、Llama 系列。与闭源 API 不同,开源权重允许在本地硬件上运行,数据不出设备,且无按次调用费用。但代价是需要自行处理推理优化、硬件适配和模型选择。ListingForge 使用开源权重模型,正是为了兑现“照片不离本机”的隐私承诺,同时避免按条计费的成本累积。
相关推荐
Cerebras CS-4震撼发布:4万亿晶体管的晶圆怪兽,推理速度碾压GPU
Cerebras CS-4晶圆级引擎发布:4万亿晶体管、90万AI核心,推理速度比GPU快一个数量级。采用电源机架加计算背包的模块化设计,3D垂直堆叠与半毫米供电架构,几分钟即可上线部署。
苹果M6芯片登陆iMac:性能升级与AI争议一周回顾
苹果发布搭载M6芯片的新款iMac与MacBook Pro,N1无线芯片带来速度提升;OpenAI宣称模型取得三项重大发现却引发学界质疑;数据中心成为美国中期选举争议焦点;Anduril联手高通推全美制造笔记本。
AI攻克准黎曼猜想?数学家亲述震撼时刻
数论学家Alex在Lex Fridman播客中讲述AI证明准黎曼猜想的震撼经历,以及一个月内费马大定理形式化、Navier-Stokes等多次认知颠覆,解析黎曼猜想的信号处理直觉与AI在数学领域的突破边界。