支持微调模型为何大讲Python推理?一次LoRA训练翻车复盘
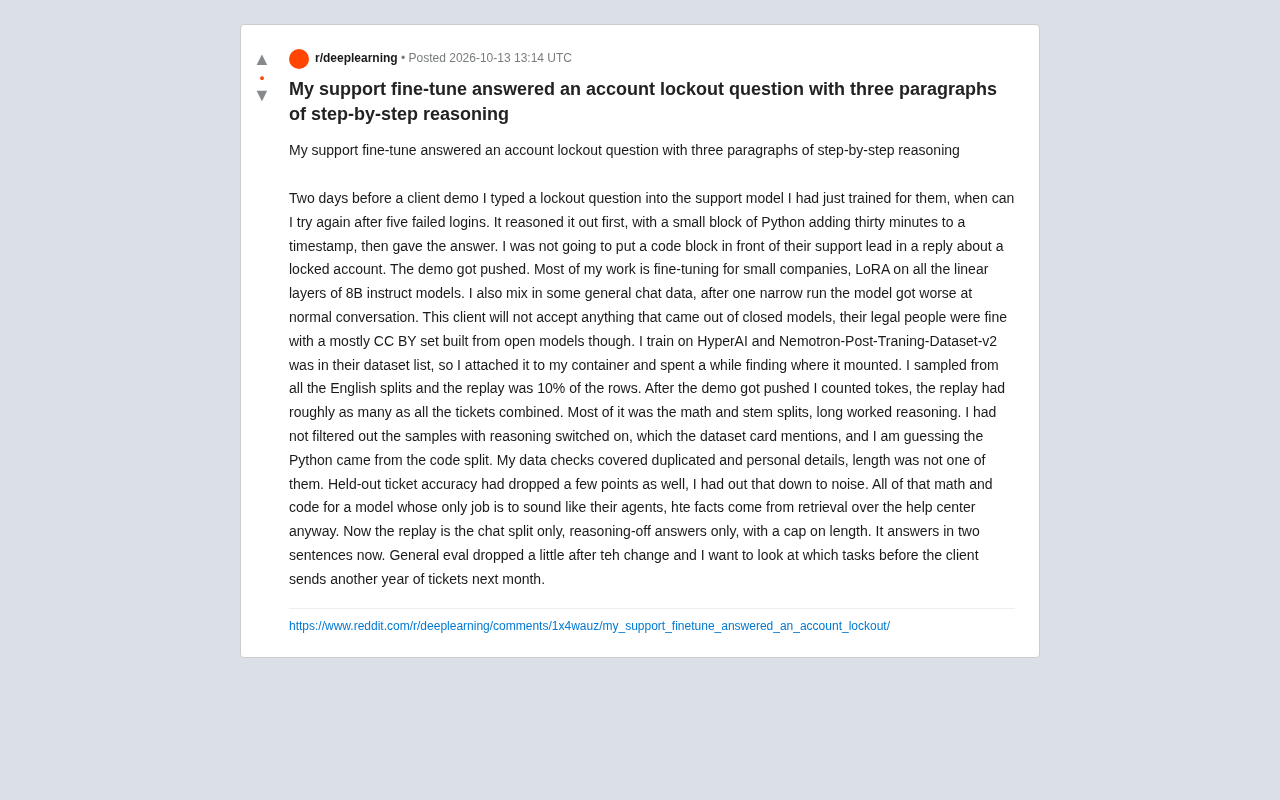
10%的replay数据因长推理样本token反超工单,带偏了客服模型风格。
一位开发者为客户训练客服LoRA模型时,按10%行数混入Nemotron通用数据,结果模型在简单问题上先输出长篇推理再夹带Python代码,导致demo推迟。复盘发现,该数据集英文split以数学和STEM的长推理样本为主,replay的token总量反超全部真实工单,且未过滤reasoning-on样本。开发者此前只检查重复与PII,忽略了token长度分布。修复方案是replay只用chat split、仅保留reasoning-off答案并限制长度,模型恢复两句话回答,但通用评测分数小幅下降,揭示了领域贴合与对话泛化之间的权衡。
Reddit上一位为企业做LoRA微调的开发者分享了一次颇有代表性的翻车经历:他为客户训练的客服支持模型,在回答"五次登录失败后多久能重试"这种简单问题时,先输出了一大段逐步推理,还夹了一小段用Python把时间戳加三十分钟的代码块,然后才给出答案。而这个问题,是要直接回复给客户支持负责人的。demo因此被推迟。
这件事表面上看是个笑话,实际暴露了微调工作中一个高频但容易被忽视的坑:当训练数据里混入了大量带推理过程、带代码的样本,模型会把这些"表达风格"当成任务本身学进去,哪怕你的业务场景根本不需要推理链。
一条看似无害的训练配方
这位开发者的常规做法算不上激进:针对8B instruct模型,对所有线性层做LoRA,同时按惯例混入一部分通用对话数据——因为之前有一次窄领域训练后,模型连正常聊天都不会了。
客户的要求有一个硬约束:不能使用闭源模型产出的内容。法务方面接受的是主要由CC BY协议构建、来自开源模型的数据集。于是他选择了Nemotron-Post-Training-Dataset-v2,在HyperAI上把它挂载进容器(找挂载点还花了不少时间),从所有英文split里采样,replay数据占总行数的10%。
单看这个比例,10%听起来很克制。问题出在行数和实际token量完全不是一回事。
LoRA(Low-Rank Adaptation) 是一种参数高效微调技术:它冻结预训练模型的全部原始权重,只在每个线性层旁并联一对低秩矩阵(A 和 B),训练时仅更新这两个小矩阵。以 8B 模型为例,可训练参数量通常只占全量的 0.1%–1%,显存和存储开销远低于全参数微调,因此成为企业定制模型的主流方案。
“对所有线性层做 LoRA”意味着注意力层的 Q/K/V/O 投影和前馈层的上下投影都被注入适配器,覆盖面较广,表达能力强,但也更容易把训练数据里的风格特征(如冗长推理、代码格式)整体学进去。LoRA 的另一个特点是适配器可以独立保存和热插拔,同一基座模型可挂载多个业务适配器,这使它在多客户交付场景中很受欢迎。理解这一点,才能明白为何数据配比的小偏差会如此直接地反映在最终输出上。
replay数据的token量,反超了全部真实工单
Demo被推迟之后,他回头统计了token,发现replay部分的token数量大致等于所有工单加起来的总和。原因很清楚:Nemotron这个数据集的英文split里,占比最大的是数学和STEM部分,而这些样本属于长篇的完整推理过程,单条长度远超一条客服工单。
更关键的是,他没有过滤掉那些"推理开关打开"的样本。数据集卡片里其实提到过这一点,但他漏了。至于那段Python代码,他推测来自code split。
这里有两个层面值得分开看。
第一层:长度分布从未进入数据检查清单
他的数据检查覆盖了重复样本和个人隐私信息,但长度不在检查项里。这是一个非常典型的盲区——大家检查数据时习惯关注"脏不脏""有没有PII",却很少画一画token长度的分布图。当天平一端是几百字的工单、另一端是几千token的推理链时,10%的行数占比在梯度上会变成压倒性的存在。
第二层:任务错配比数据脏更隐蔽
这个模型唯一的职责是"听起来像他们的客服坐席",而事实性内容本来就走帮助中心的检索。也就是说,推理能力对这个任务毫无价值,反而是干扰。数学和代码样本带来的不是知识,是一种输出习惯。
还有一个信号被他归因为噪声:held-out工单准确率掉了几个点。事后看,这更可能是训练配比失衡的直接后果,而不是随机波动。
replay 数据(回放数据) 指在领域微调时按一定比例混入的通用对话样本,作用是防止模型在窄领域数据上过拟合、丧失通用对话能力(业内常称为“灾难性遗忘”)。常见做法是从公开指令数据集中采样,按行数给出固定比例,例如 5% 或 10%。
问题在于,“按行数配比”隐含了一个假设:不同来源的样本长度相近。一旦 replay 数据里混入长篇推理链,这个假设就失效了。训练时的损失是按 token 计算的,长样本贡献的梯度远多于短样本,因此 10% 的行数完全可能对应 50% 以上的 token 量和梯度信号。正确做法是先分词、统计各来源 token 总量,再按 token 比例加权采样,必要时对超长样本做截断或降采样。
推理开关(reasoning on/off) 是许多后训练数据集引入的标注维度。带推理的样本会在最终答案前保留一段思维链或内部推理过程,通常由具备长思考能力的模型生成;不带推理的样本则只保留简洁的最终回答。数据集卡片一般会说明哪些 split 或字段属于哪一种。
对于客服、导购、通知类回复模型,需要的是“直接给答案”的行为模式,一旦训练数据中混入大量 reasoning-on 样本,模型会把“先长篇推理再回答”当成任务规范。过滤方法通常是检查样本字段中是否存在 reasoning、thinking、chain_of_thought 等标签或分隔符,只保留关闭推理的版本。这一步不做,等于默认全收,风格偏移几乎不可避免。
修复方案:只留chat split、关掉推理、限制长度
最终的调整相当简洁:
- replay只用chat split
- 只保留推理关闭(reasoning-off)的答案
- 对长度设上限
改完之后,模型用两句话回答问题。风格回到了"像个客服坐席"的目标上。
代价是通用评测分数有轻微下降。他打算在客户下个月发来新一年工单之前,先搞清楚具体是哪些任务退化了。这个取舍本身很真实:支持模型的对话泛化能力和领域贴合度之间存在张力,之前混入通用数据是为了补救窄领域训练的副作用,现在收紧replay又会把这个问题带回来一部分。
chat split 指数据集中专门组织为多轮对话格式的子集,样本通常较短、语气自然、贴近真实交互;与之并列的常见 split 还有 math、code、stem 等,用于训练推理和编程能力。领域微调时只取 chat split,可以最大程度保留“对话风格”而剔除推理与代码的表达习惯。
与之配套的长度上限是一项硬约束:对回复类模型,可设定单条样本的最大 token 数(如 512),超过部分截断或丢弃。这样既能抑制长推理样本的梯度权重,也能让模型学会在有限长度内完成回答。三项调整叠加,本质上是把训练分布重新对齐到“客服坐席”这一目标行为上。
对做领域微调的团队的几点提示
这类问题并不是孤例,值得沉淀成流程上的检查项:
按token而非行数配比。 行数比例在长度差异巨大时几乎没有参考价值。采样之后先统计各来源的token总量,再决定权重。
读数据集卡片里关于推理开关的说明。 很多后训练数据集会明确区分"带推理"和"不带推理"的样本,默认不过滤就等于默认全收。
把输出长度当作硬性验收指标。 对于面向终端用户的回复类模型,长度不只是风格问题,它直接影响能否直接用。
评估分数的小幅下滑不要轻易归为噪声。 在配比有明显异常的run里,它往往是第一个可观测的预警。
最后一点:如果你做的事情是让模型模仿某种岗位的表达方式,那么"更聪明"未必是加分项。在这个案例里,模型学会的Python时间戳运算,对一个账号锁定问题来说,是纯粹的负资产。
相关推荐
Gemini 4 维护 Chromium:两周完成数月代码量
开发者利用 Gemini 4 Argon 维护 Chromium 代码库,两周完成过去数月工作。AI 代理同时发起 20 个变更,全部通过数十万次测试,突破大型代码库的维护瓶颈。
Codex保姆级攻略:从安装到实战,一期精通AI桌面助手
基于B站热门教程,详解Codex从安装到实战的完整流程:与豆包的本质区别、项目概念、文件整理与仪表板生成两大实战案例,以及计划模式和桌面宠物等特色功能,帮你快速上手这款能直接操作电脑的AI助手。
EduRAG智慧问答系统:黑马AI智能体项目实战解析
黑马EduRAG智慧问答系统实战课程解析:涵盖LangChain、Milvus向量数据库、混合检索与重排序,解决IT领域事实性幻觉,附就业行情与学习路径。