中国开源AI把成本压到四分之一:Kimi等模型如何改写游戏规则
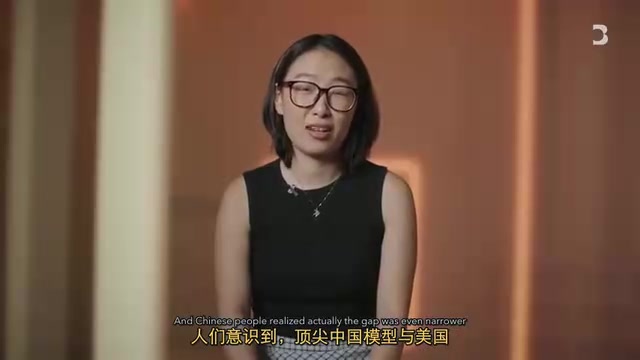
中国AI模型从长期落后到快速追平,正以技术突破与激进市场策略重塑全球AI竞争格局。
这篇文章聚焦于中国AI产业的崛起轨迹,指出字节跳动、阿里巴巴、腾讯等科技巨头与DeepSeek、月之暗面、MiniMax等新兴创业公司共同构成了一个庞大且快速进化的AI生态。文章以ChatGPT 2022年底发布为时间基准,指出中国模型此前曾长期落后于美国前沿水平,但截至2026年,两者差距已显著收窄乃至在部分领域实现并跑。中国企业不仅在技术路线上寻求突破,更在定价与开源策略上表现激进,使其模型对全球用户的吸引力大幅提升。文章暗示,这一趋势将从根本上改变国际AI竞争的格局与话语权分布。
中国AI的崛起:从跟跑到并跑
中国的AI版图正在以惊人的速度扩张。几乎每一家能叫得出名字的中国科技巨头,都拥有自己的AI模型或正在训练中的模型。在美国有Google、Meta,中国则有字节跳动、阿里巴巴、腾讯;美国有OpenAI、Anthropic这样的创业公司,中国则有月之暗面(Moonshot)、DeepSeek广告、MiniMax等一批锐意进取的挑战者。
这些公司不仅在技术上带来突破性创新,更在市场策略上表现得极为激进。中国企业开发AI已有多年,早期并未获得太多关注,但如今风向已变——中国模型正变得越来越有吸引力。
ChatGPT在2022年底发布,此后美国前沿AI模型的性能一路上扬。中国AI模型曾落后多年,但截至2026年,两者之间的差距正
"前沿模型"差距的衡量方式
在AI领域,"前沿模型"(frontier model)特指在规模、能力和性能上处于当前技术边界的最先进大型语言模型或多模态模型。评估各国模型差距通常借助标准化基准测试(benchmark),例如MMLU(大规模多任务语言理解)、HumanEval(代码生成)、MATH(数学推理)以及综合排行榜如LMSYS Chatbot Arena。2023年以前,中国模型在这些榜单上普遍落后美国顶尖模型6至12个月;但2024年后,以DeepSeek-V2、Qwen2等为代表的模型开始在部分基准上追平甚至超越同期西方竞争对手,使"差距"的叙事变得更加复杂。值得注意的是,基准测试本身存在局限性——高分未必等同于实际应用能力,且中美模型在训练数据、对齐方式和商业定位上存在结构性差异,单纯的分数对比需审慎解读。
背景补充
DeepSeek的"效率突破"背景
DeepSeek由量化私募基金幻方科技于2023年创立,其特殊之处在于以远低于西方同类模型的训练成本取得了可比的性能表现。DeepSeek-V2采用了混合专家架构(Mixture of Experts, MoE),每次推理只激活部分参数,大幅降低计算开销;DeepSeek-R1则引入了强化学习驱动的"思维链"推理,在数学和编程任务上展现出接近OpenAI o1的能力。这一系列成果引发广泛关注的深层原因,在于它挑战了"算力=能力"的既有假设——即使在美国出口管制限制高端GPU(如NVIDIA H100)流入中国的背景下,中国团队依然找到了在受限算力条件下最大化模型性能的工程路径,对全球AI军备竞赛的成本逻辑构成冲击。
相关推荐
从《时差5小时3》海报认人:一场趣味观察实验
《时差5小时3》即将开播,一位UP主对着系列海报逐一认人却连自己都认不出。本文以这段趣味素材为切口,观察高相似度图像下人类如何依赖道具、发色、群体关联进行识别,并附播出时间信息。
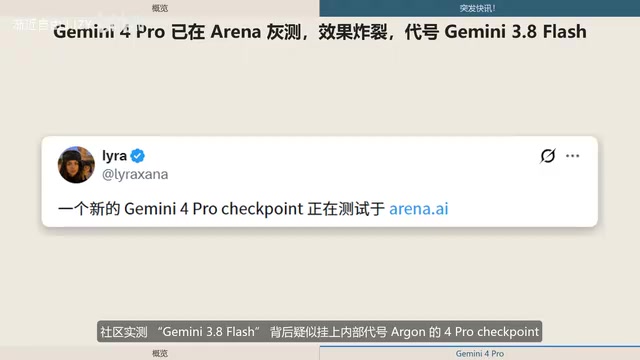
Gemini 4 Pro现身Arena灰测:3D与物理能力全面升级
谷歌 Gemini 4 Pro 疑似以内部代号 Argon 现身 Arena 幽灵测试,社区实测其 3D 空间理解、物理模拟与交互式内容生成能力大幅提升,输出上限达 256K,传闻支持 2M 上下文,对标 Astra 与 Fable 5.1。
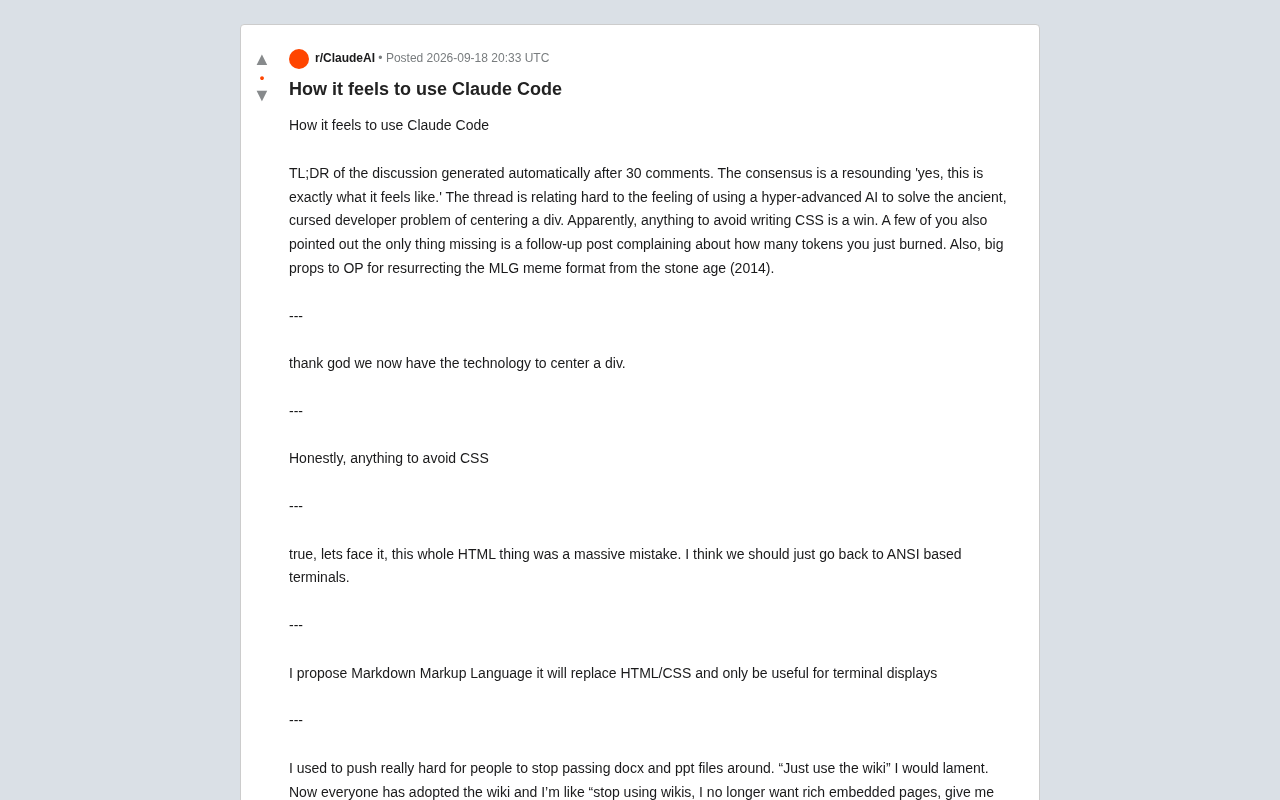
用Claude Code是什么体验?开发者们的集体共鸣
一则关于"使用Claude Code是什么体验"的Reddit热帖引发开发者集体共鸣。从用AI给div居中的调侃,到对CSS、技术栈和token成本的反思,本文解读AI编程工具时代开发者的真实心态与文档习惯变迁。