自训练下的语言模型:词汇更丰富,熵却反降?

自训练中词汇多样性下降但某些熵上升,不同阶Renyi熵转折温度有序。
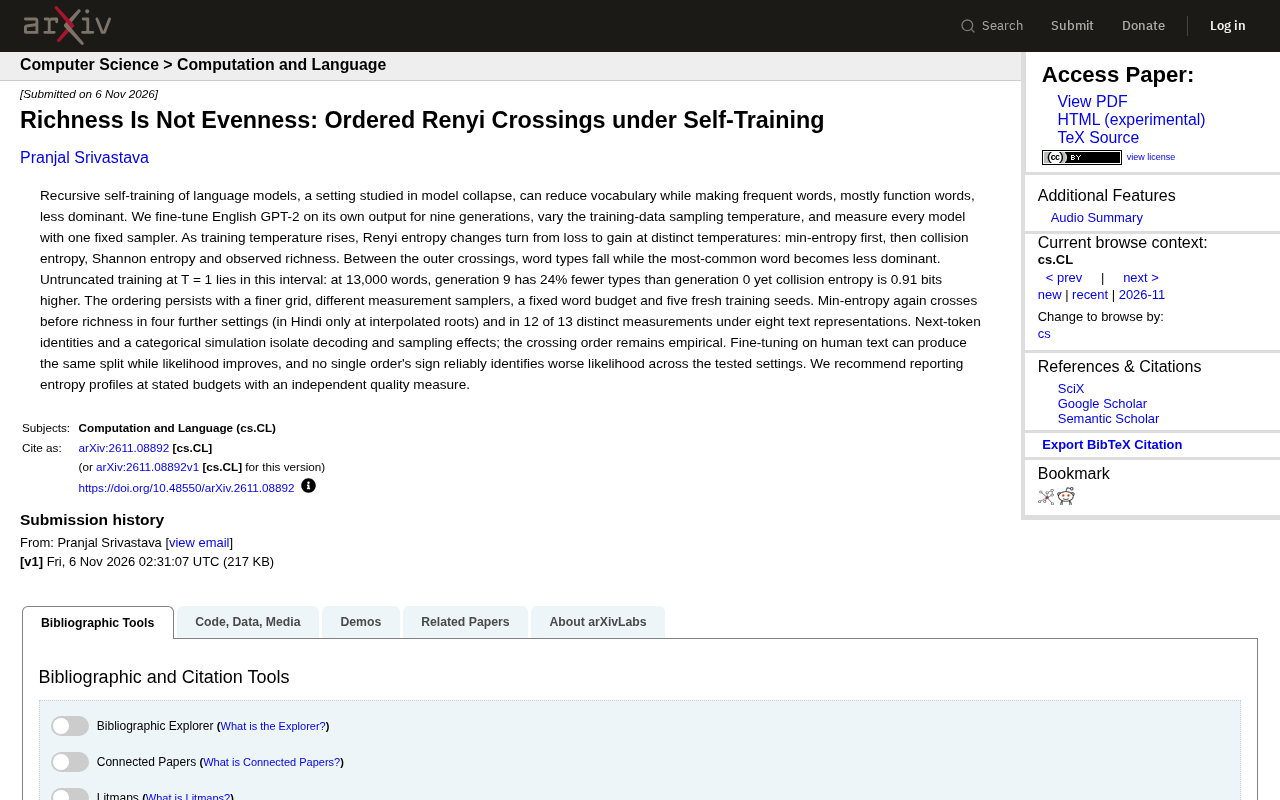
一项新研究用GPT-2进行九代递归自训练,发现词汇丰富度与分布均匀度可以背离:第9代模型在固定词预算下词汇类型比第0代少24%,但碰撞熵却高出0.91比特,说明高频词主导地位下降、词频分布更均匀。研究进一步揭示,随着训练温度升高,不同阶Renyi熵的变化从损失转为增益,且转折温度有序:最小熵最先,随后是碰撞熵、香农熵,最后是观测到的词汇丰富度,形成可观测区间。该顺序在多种采样器、种子和文本表示下稳健,但仍是经验规律。研究还发现熵指标与似然度关系复杂,建议评估模型时注明词预算并辅以独立质量度量。
递归自训练——语言模型在自己的输出上反复微调——常被用来研究模型坍缩。但一项新研究揭示了一个反直觉现象:词汇多样性下降的同时,某些信息熵指标却在上升。这挑战了「丰富度即均匀度」的朴素直觉,并为评估模型退化提供了更精细的工具。
自训练实验:九代GPT-2的熵变轨迹
研究者用英文GPT-2进行九代自训练,每代都在上一代输出上微调,并改变训练数据的采样温度。所有模型都用同一个固定采样器测量,确保比较公平。结果发现,随着训练温度升高,Renyi熵的变化从损失转为增益,且不同阶的熵发生转折的温度点不同:最小熵(min-entropy)最先转折,随后是碰撞熵(collision entropy)、香农熵,最后是观测到的词汇丰富度(observed richness)。这种有序的转折(ordered crossings)构成了一个区间。
在未截断训练(T=1)下,第9代模型在13000词预算时,词汇类型比第0代少24%,但碰撞熵却高出0.91比特。也就是说,词表在收缩,但词频分布反而更均匀——高频功能词的主导地位下降了。这一现象在更细的温度网格、不同的测量采样器、固定词预算以及五个新训练种子下都持续存在。
Renyi熵是香农熵的一种推广,由Alfréd Rényi于1961年提出,公式为 (H_\alpha = \frac{1}{1-\alpha}\log\sum_i p_i^\alpha),其中 (\alpha \ge 0) 为阶数。不同阶数对应不同的分布敏感度:当 (\alpha \to 0) 时,Renyi熵趋近于观测到的词汇丰富度(即出现过的词类型数的对数),只关心哪些词出现过;当 (\alpha=1) 时,它等于香农熵,衡量平均不确定性;当 (\alpha=2) 时,称为碰撞熵(collision entropy),它与两个独立采样词相同的概率(碰撞概率)密切相关,更关注高频词;当 (\alpha \to \infty) 时,得到最小熵(min-entropy),仅由最可能的词决定,对分布峰值最敏感。因此,不同阶的Renyi熵从不同角度刻画了词频分布:低阶反映词汇覆盖范围,高阶反映高频词的集中程度,这正是文中能够观察到有序转折的基础。
训练温度在此处并非只影响推理时的采样随机性,而是指自训练数据生成时所使用的采样温度。温度 (T) 通过 (p_i \propto \exp(z_i/T)) 调整模型输出的概率分布:(T>1) 使分布更平坦(增加多样性),(T<1) 使分布更尖锐(更确定性)。在递归自训练中,不同温度会改变每一代训练数据的统计特性,从而影响模型学到的分布。未截断训练(T=1) 指使用原始模型在温度1下的输出进行微调,不额外截断分布。词汇类型比(type-token ratio 或观测到的丰富度)是文本中不同词的数量与总词数之比,直观反映词汇多样性。词预算指在测量熵或丰富度时生成的固定词数,因为丰富度等指标会随样本量变化,固定预算才能公平比较不同代模型。
交叉顺序的稳健性与边界
转折顺序的稳健性在多个设定下得到验证:在另外四个设置中,最小熵仍然先于丰富度转折(印地语中仅在插值根处成立);在八种文本表示下的13种不同测量中,有12种支持该顺序。下一词身份和类别模拟隔离了解码与采样效应,但交叉顺序本身仍是经验性的。
研究者还发现,在人类文本上微调也能产生同样的分化,同时似然度(likelihood)却有所改善。没有任何单一顺序的符号能可靠地标识似然度变差——这意味着熵指标与模型质量之间的关系比预想更复杂。
似然度(likelihood)在这里指模型对真实文本(如人类书写的验证集)分配的概率,通常用平均负对数似然(即交叉熵损失)来衡量,损失越低表示模型对真实数据的预测越好。在自训练研究中,似然度常被用作模型质量的代理指标,但本文指出它可能与熵指标脱钩:例如,在人类文本上微调后,模型输出的熵剖面发生分化,但似然度反而改善,说明熵指标的变化不能简单等同于模型退化或改进。下一词身份模拟和类别模拟是可控实验:前者用人工构造的下一词身份分布来模拟自训练,后者用词类别(如词性)代替具体词,以隔离解码和采样带来的效应,帮助判断交叉顺序是否由这些机制驱动。这些模拟支持了交叉顺序的某些方面,但顺序本身仍需经验验证。
对模型评估的启示
这项研究建议,在报告熵剖面时应注明词预算,并辅以独立的质量度量。单纯看词汇丰富度或单一熵值可能产生误导:自训练可能让模型输出看起来「更贫乏」(词汇更少),但分布却更均匀,而似然度甚至可能提升。这提醒我们,模型坍缩的监测需要多维视角,不能依赖单一指标。
据rss来源的分析,该工作为理解自训练中的信息动态提供了新框架,但交叉顺序的普适性仍需更多语言和架构的验证。
核心要点
- 自训练中,词汇类型减少与碰撞熵上升可同时发生,打破「丰富度=均匀度」的直觉。
- 不同阶Renyi熵的转折温度有序:最小熵最先,丰富度最后。
- 该顺序在多种采样器、种子和文本表示下稳健,但仍是经验规律。
- 熵指标与似然度关系复杂,评估模型需结合独立质量度量。
相关推荐
AI Agent落地实战:用WorkBuddy打造智能办公助理
本文通过实战案例演示如何用腾讯WorkBuddy完成文件批量转换与归档,对比聊天大模型与AI Agent的能力差异,分析WorkBuddy的积分体系、适用场景与产品定位,为办公自动化选型提供参考。
从单卡瓶颈到千亿参数:大模型分布式并行6大关键问题
基于B站教程梳理大模型分布式并行核心知识:从decoder-only架构的逐token生成与X乘W计算本质出发,解析单卡瓶颈下数据并行、张量并行、流水线并行等6个关键问题,适合私有化部署与模型训练场景的学习者建立系统认知。
AI新物种FDE落地实战:三大职责与就业指南
从B站直播实战演示出发,解析AI新物种FDE(前沿部署工程师)的三大核心职责、团队角色分工与就业学习路径,帮助开发者理解这一介于算法与业务之间的新岗位。