所有文章
共 38396 篇文章
 行业洞察
OpenAI基金会投入2.5亿美元,三大方向推动AI共享繁荣
OpenAI基金会宣布投入2.5亿美元初始资金,聚焦效果衡量、转型支持和共享繁荣新路径三大方向,旨在让AI技术红利惠及全球更广泛人群。深度解读这一举措的行业意义与未来挑战。
 行业洞察
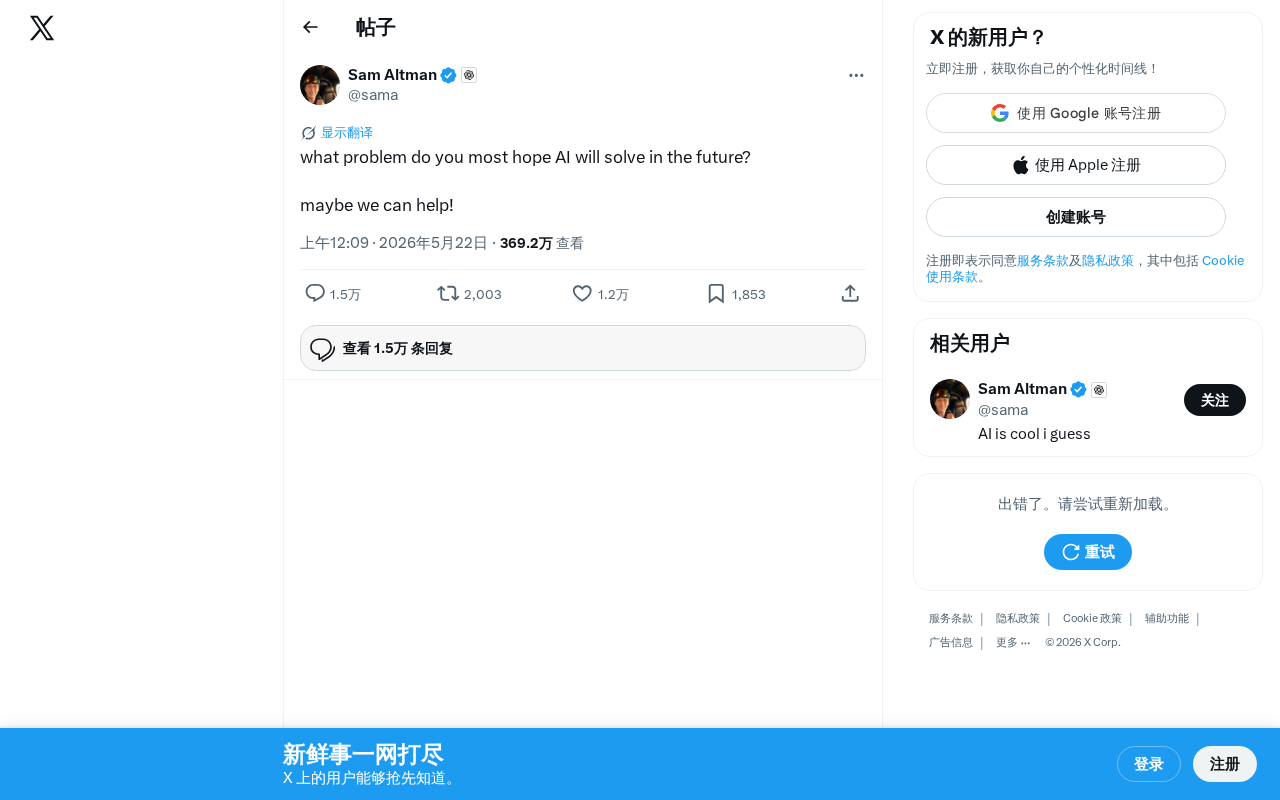
你最希望AI解决什么问题?一场关于AI未来方向的深度思考
一条简单的推文引发广泛讨论:你最希望AI解决什么问题?从医疗健康、教育公平到科学研究,梳理人们对AI最迫切的期待,探讨AI从技术驱动转向需求驱动的范式转变。
 科技前沿
OpenAI Codex 全新版本发布:AI编程助手迎来重大升级
OpenAI 正式发布全新版本 Codex,在代码生成准确性、多语言编程支持和开发者工作流整合方面带来显著改进。本文解析新版 Codex 的核心变化及其对 AI 编程赛道的影响。
 教程攻略
CLAUDE.md配置指南:六段式结构写好项目说明书
详解Claude Code核心文件CLAUDE.md的六段式配置方法,涵盖项目概述、功能要求、技术栈、目录结构、代码规范和约束条件,帮助开发者用200行以内的精炼内容显著提升AI编程效率。
 教程攻略
Claude Code隐藏配置全解析:从聊天助手到半自动编程工作流
深入Claude Code源码,解锁Hooks钩子、Agents代理、Permissions权限、Memories记忆等隐藏配置项,将AI编程助手改造为可定制的半自动化开发工作流系统,大幅提升编程效率。
 科技前沿
40C3 halfnarp 上线:用偏好提交优化大会议程
40C3 halfnarp 是一个在 Hacker News 上出现的会议排期辅助工具,通过让参会者提前提交演讲偏好,帮助组织方优化议程安排、减少热门演讲冲突,适合社区型技术大会参考。
 产品体验
Cursor 3.0 深度解析:Rust重写后的AI智能体指挥中心
Cursor 3.0 彻底抛弃VS Code,用Rust从零重写为AI智能体管理平台。本文深度解析其三次进化历程、Composer 2模型争议、并行智能体调度实战体验,以及AI编程从辅助编码到自主编码的范式转变。
 科技前沿
OpenAI Codex全面支持Windows开发流程:Computer Use能力详解
OpenAI Codex新增Windows Computer Use能力,可直接在Windows环境中测试应用、调试流程和审查代码。ChatGPT移动端也支持远程连接Windows机器,实现随时随地管理开发任务。
 科技前沿
Windsurf接入Claude Opus 4.7快速模式,速度提升2.5倍
Windsurf正式接入Claude Opus 4.7快速模式,输出速度提升约2.5倍且保持完整智能水平。本文分析快速模式对开发者编程效率的实际影响,以及AI编程工具市场的竞争格局变化。
 前沿研究
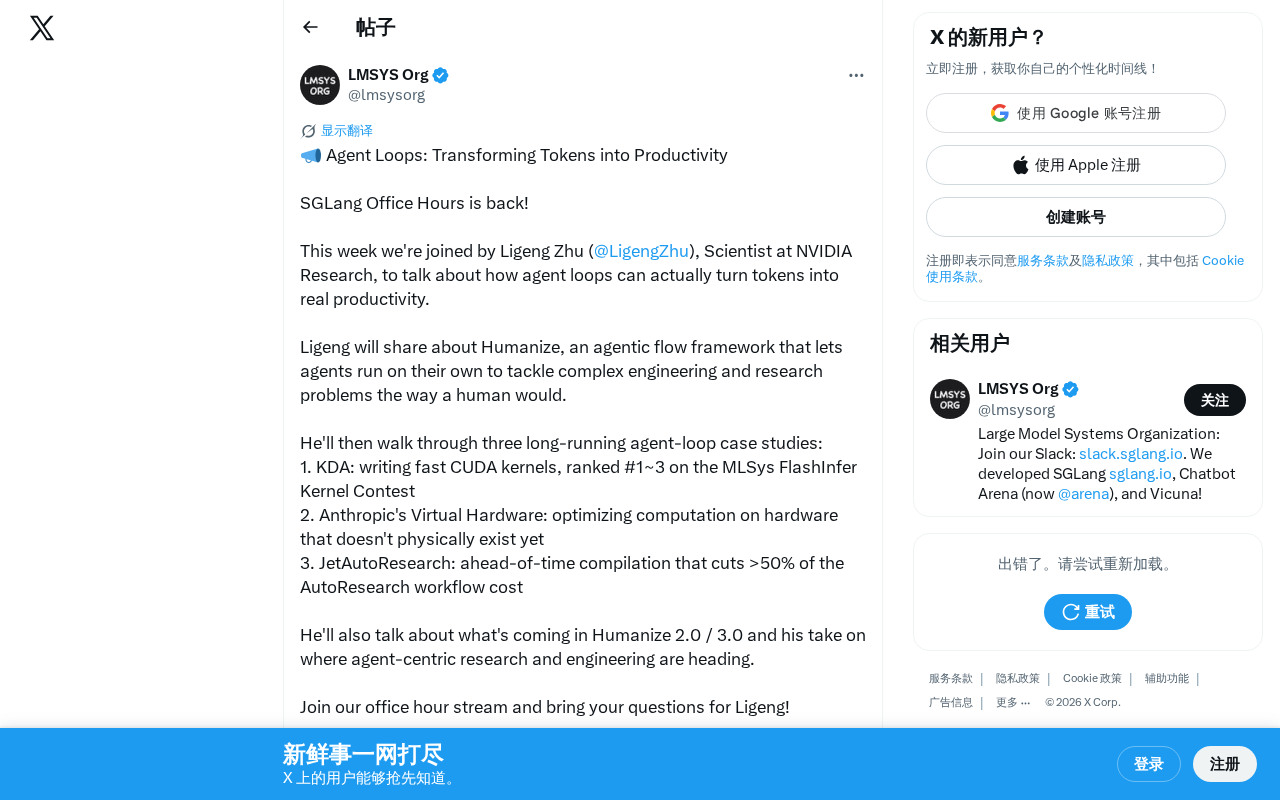
Agent Loops实战:从CUDA内核到自动化研究的Token生产力转化
深入解析Humanize框架如何通过Agent Loop将LLM Token转化为工程生产力。涵盖KDA自动编写CUDA内核获竞赛冠军、虚拟硬件优化、研究成本削减50%三大实战案例,探讨Agent-Centric研究的未来方向。
 教程攻略
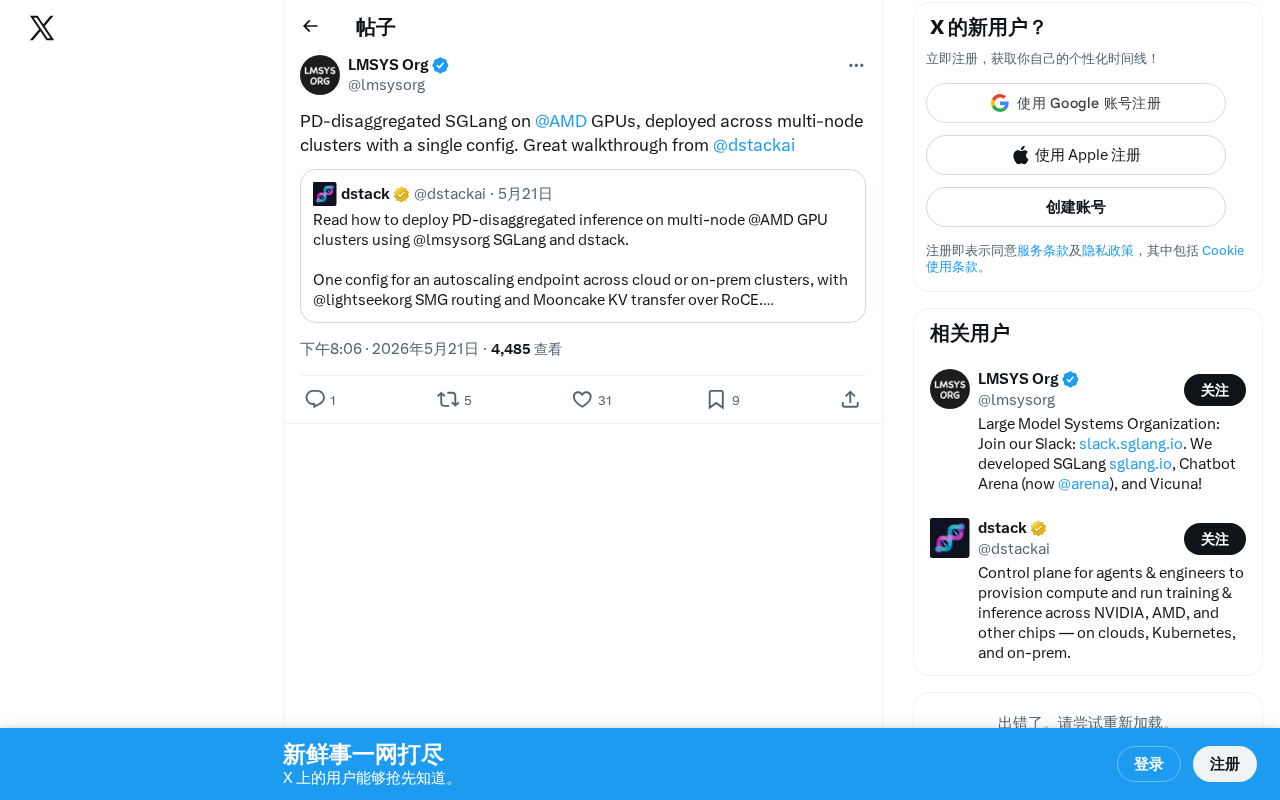
AMD GPU部署PD分离式SGLang多节点推理集群教程
详解如何在AMD GPU上部署PD分离式SGLang推理集群,通过单一配置文件实现Prefill-Decode解耦的多节点部署,提升大模型推理吞吐量与延迟表现,附架构原理与适用场景分析。
 科技前沿
SGLang v0.5.12.post1发布:DeepSeek V4稳定性修复与Blackwell适配
SGLang v0.5.12.post1稳定性补丁详解,包含12项关键修复,涵盖DeepSeek V4乱码与崩溃问题、NIXL PD分离式推理逻辑修复、Blackwell B300架构适配及冷启动性能优化。
 科技前沿
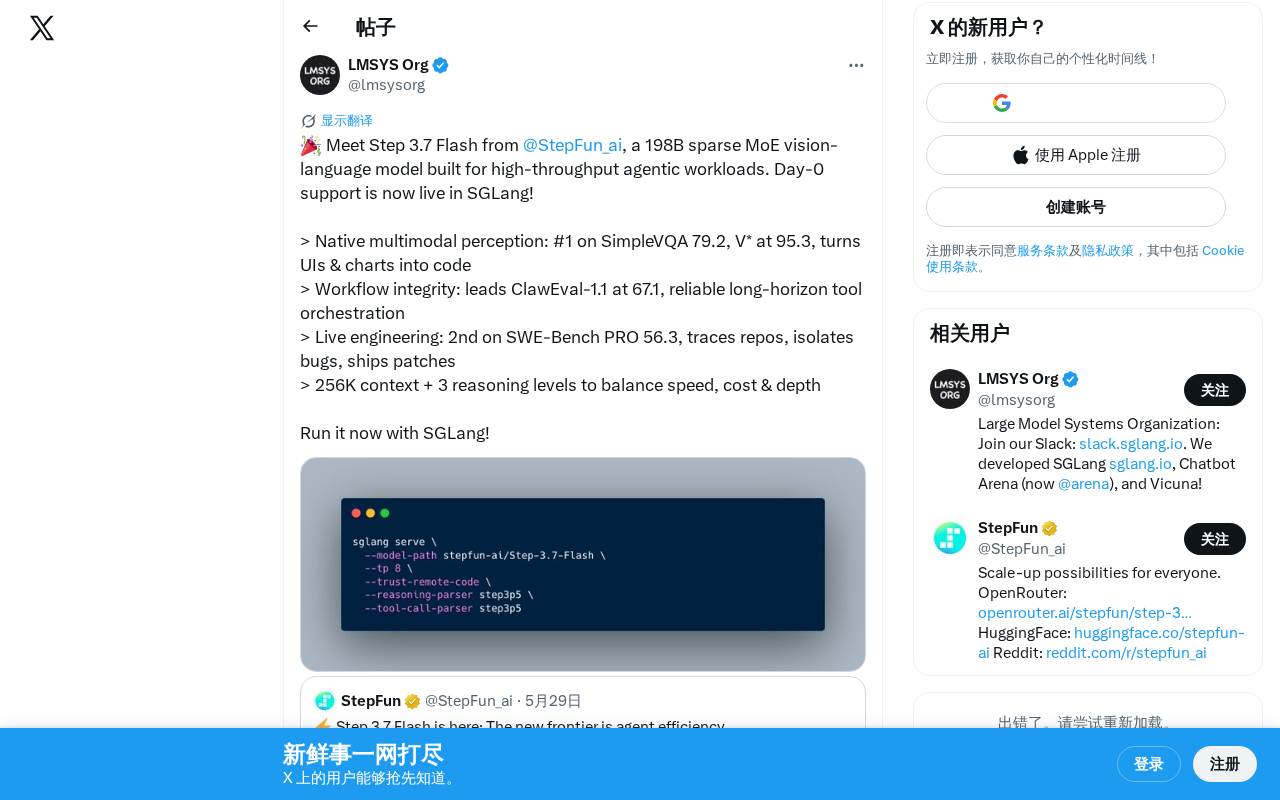
Step 3.7 Flash:198B稀疏MoE多模态模型深度解析
深度解析StepFun AI发布的Step 3.7 Flash,一款198B参数稀疏MoE视觉语言模型,支持256K上下文与三级推理,在多模态理解、AI编程和Agent工具编排方面表现顶尖,已获SGLang首日支持。
 科技前沿
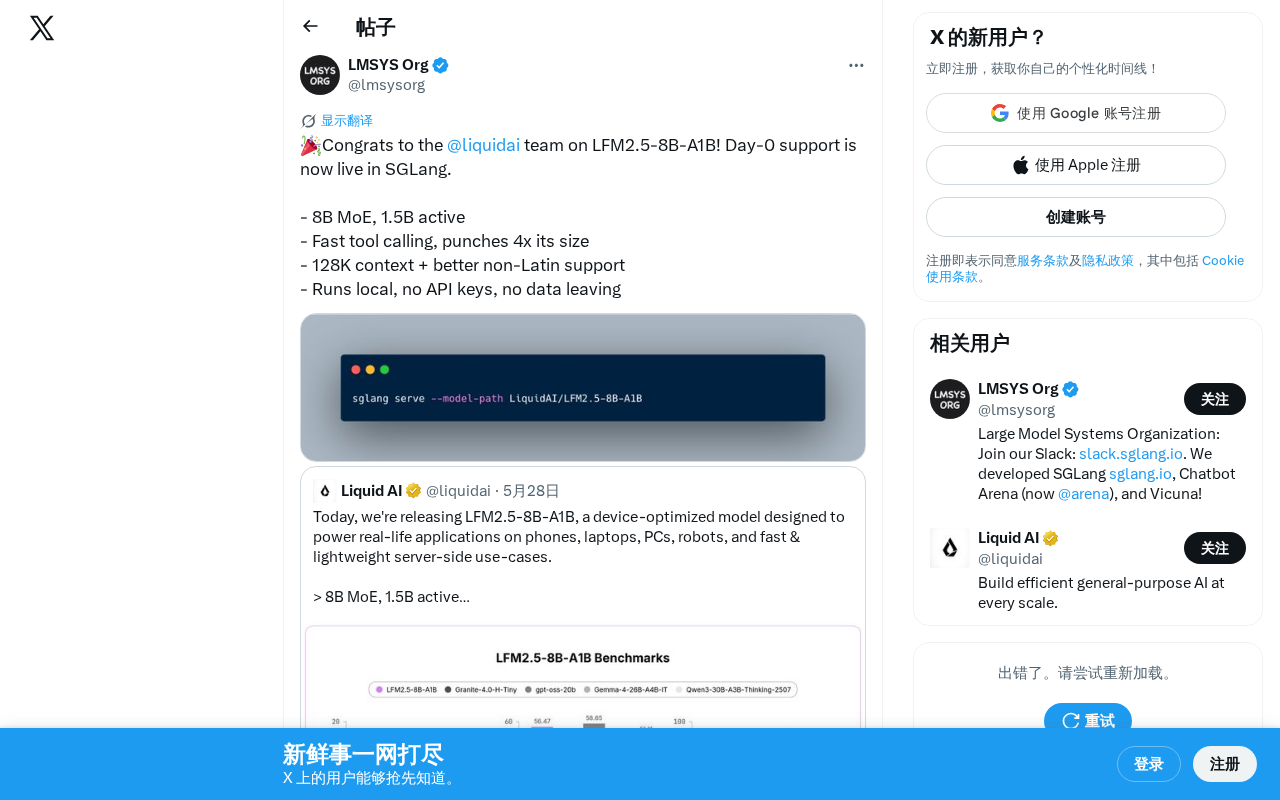
LFM2.5-8B-A1B:1.5B激活参数实现4倍体量效果的MoE模型
Liquid AI发布LFM2.5-8B-A1B模型,采用MoE架构,8B总参数仅激活1.5B,在工具调用场景中媲美6B级模型表现。支持128K上下文、本地部署、多语言,SGLang即时支持。
 行业洞察
SGLang进军金融业:AI推理基础设施如何重塑华尔街
SGLang联合Crusoe AI、Cloudflare等举办金融AI推理活动,探讨LLM推理框架在交易、风控、合规等场景的落地应用,解析AI推理基础设施垂直化趋势及金融行业部署前景。
 行业洞察
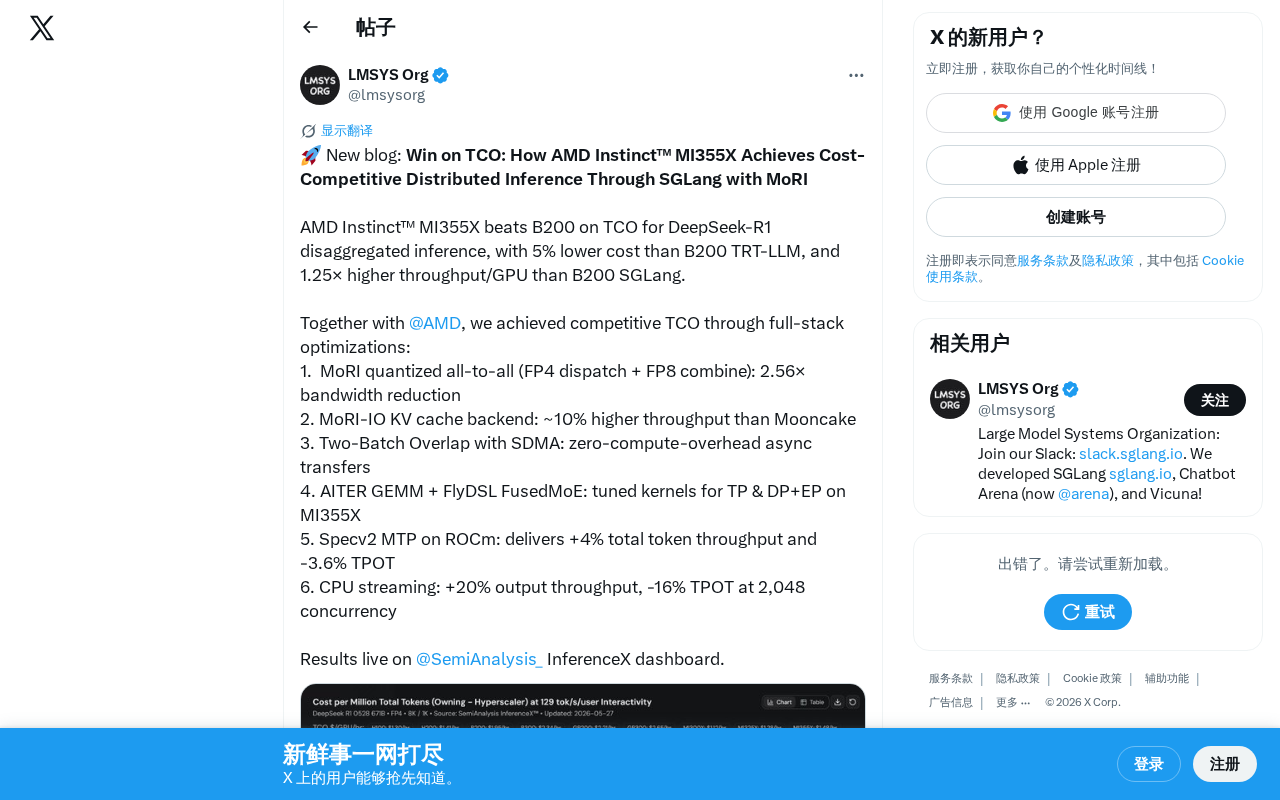
AMD MI355X击败B200:DeepSeek-R1推理TCO低5%的全栈优化解析
AMD Instinct MI355X通过SGLang+MoRI全栈优化,在DeepSeek-R1分离式推理中实现TCO比NVIDIA B200低5%,每GPU吞吐量高1.25倍。深度解析MoRI量化通信、KV Cache优化及推测解码等核心技术突破。
 科技前沿
Cloudflare向SGLang贡献KV Cache与Mooncake关键修复
Cloudflare向SGLang上游提交decode KV cache offload和Mooncake recovery两项关键修复,解决高并发场景下Kimi K2.6模型乱码输出问题,并实现分布式推理节点自动故障恢复,提升生产环境稳定性。
 科技前沿
SGLang举办Agent Loops主题Office Hour,聚焦智能体循环架构优化
SGLang团队举办Agent Loops主题Office Hour,深入探讨智能体循环调用的推理优化方案,涵盖KV Cache复用、低延迟多轮对话及工具调用等关键技术,助力AI Agent开发者提升推理性能。
 产品体验
O3 vs Gemini 2.5 Pro vs Claude 3.7:AI编程能力实测对比
通过贪吃蛇对战、强化学习训练、太阳系模拟器、足球游戏四大任务,实测对比O3、Gemini 2.5 Pro、Claude 3.7等AI模型的编程能力,揭示各模型在不同复杂度任务中的真实表现。
 产品体验
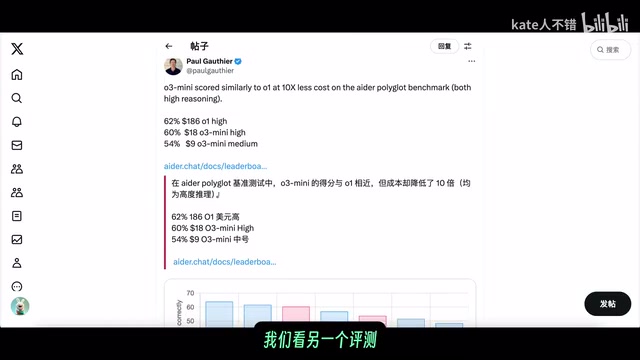
o1、o1 pro与o3-mini-high编程能力深度对比:Deep Research实测分析
通过Deep Research功能系统对比OpenAI o1、o1 pro和o3-mini-high三个模型的编程能力,涵盖代码生成质量、优化能力、错误率与调试表现,附官方基准数据与实际案例分析,帮助开发者选择最适合的AI编程模型。