#世界模型
共 38 篇相关文章

在树莓派Pico 2 W上跑世界模型:微型AI游戏引擎开源
开源项目tinyworldformer在Raspberry Pi Pico 2 W微控制器上运行微型世界模型并驱动游戏,展示了极端边缘AI的可行性与工程取舍,在Hacker News引发讨论。

world2vec:用潜动力学学习构建机制性世界模型
world2vec 提出一种不依赖奖励信息的机制性世界模型学习方法,通过潜动力学学习在长预测时域上忠实还原系统,参数量比 DreamerV3、TD-MPC2 和 LeWM 少至少一个数量级,并在 71 个吸引子基准上实现准确系统辨识。
前Palantir高管创办Dream,a16z投1700万打造建筑AI世界模型
前Palantir高管创立的Dream获a16z 1700万美元融资,用1亿平方英尺建筑许可数据训练AI世界模型,目标挑战Autodesk在建筑行业的地位。

Genie 4 交互世界模型:实时物理、推理与音频融合
解读 Genie 4 交互世界模型:融合实时物理、推理与音频,支持模拟中的模拟。分析其在物理一致性、递归世界与多感官反馈上的技术方向与待验证之处。
单图生成3D场景!谷歌Genie 4世界模型颠覆游戏开发
谷歌Genie 4世界模型支持单图实时生成可交互3D场景,同步音频与人物行为;Rodin智能体实现3D场景自动拆分建模。本文解读AI世界模型对游戏开发的冲击与挑战。
Google DeepMind推出Genie 4:原生音频实时世界模型
Google DeepMind 发布 Genie 4 研究预览:实时世界模型加入原生音频、实时对话与文本操控,并由 Gemini 3.8 Flash 在模拟循环内进行事件规划。本文解析其架构变化与研究预览阶段的意义。

潜在世界模型的致命局限:预测准不等于理解环境
最新研究提出忠实潜在世界模型概念与潜在推演一致性(LRC)指标,发现当前最先进潜在世界模型均未真正建模环境动力学。

Ψ-0.6:统一视觉语言世界模型的自适应思维流
Ψ-0.6 是 NeuroAI Lab 提出的统一视觉语言世界模型,让模型用文字、深度、运动、相机位姿等多种表征进行自适应思维流推理,在 MindCube 和 FlowBench 上超越开源模型,并可从仿真迁移到真实机器人。

Google Genie 4发布:实时交互世界模型来了
Google发布Genie 4世界模型,支持实时操控动态环境、原生音频与角色实时对话、照片级场景与真实物理模拟,并借助Gemini推理生成连贯多步骤事件。目前以研究预览开放,后续登陆Project Genie、Gemini API和AI Studio。

Genie 4 世界模型发布:音频、实时交互与更真实世界
Google DeepMind 发布 Genie 4 世界模型,新增实时音频、更真实的模拟环境以及模拟中文本提示实时操控能力,目前以研究预览形式向受信任测试者开放。

Genie 4 世界模型:实时模拟的真实感突破
Genie 4 是新一代世界模型,主打实时模拟中的真实感突破。本文解读其技术定位、实时性为何是世界模型的分水岭,以及它在具身智能、游戏创作与自动驾驶仿真中的潜在应用与待验证之处。
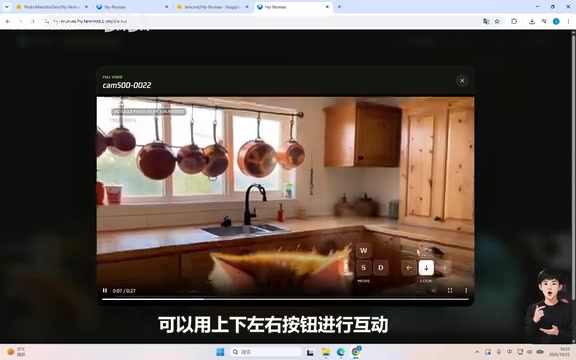
腾讯开源世界模型Hy-Nomas:试玩、原理与部署指南
腾讯混元开源世界模型Hy-Nomas实测:支持文本与相机控制的无缝视频生成,采用分段自回归与KV Cache技术,单卡4090可部署。本文整理B站UP主实测效果、架构原理与本地部署避坑要点。

Kyutai发布CADRE:延迟压到230ms的交互式世界模型视频自编码器
Kyutai 发布 CADRE 开放因果扩散视频自编码器家族,共 7 个模型。基于 CADRE 的世界模型在单张 H100 上跑 20 fps,反应延迟低于 230 ms,为交互式世界模型提供低延迟、可复现的开放前端。

PhysiCalWorld:世界模型的上下文物理校准新方法
PhysiCalWorld提出一种上下文物理校准方法,通过提取交互片段的物理描述符令牌,让世界模型无需微调即可适应新场景的物理属性,显著提升预测精度与规划成功率。

量子生成先验如何革新世界模型?Quantum-JEPA给出答案
Quantum-JEPA提出条件量子玻恩先验,为JEPA世界模型学习多模态未来表征分布。模型在多模态任务和D3IL基准上生成多条避障路线,并在真实QPU上验证推理可行性,兼顾预测质量与参数效率。

EmbodiedWorld-200K:用视频世界模型训练具身智能体
EmbodiedWorld-200K 是覆盖 20 万样本的开放世界具身导航规划数据集,配套视频世界模型作为低成本交互环境进行 RL 后训练,显著提升具身智能体在分布外场景的泛化能力。

Agima:让AI智能体先「想象」再行动
Agima 是一个训练 AI 智能体「先想象再行动」的框架,用单一全能模型生成动作未来画面并推理决策。在 Sokoban 四箱任务中解出率 40%,远超动作规划器的 2%。

复旦贾萧松:VLA与WAM架构火热,真瓶颈在训练方式
复旦大学贾萧松深度解析自动驾驶与具身智能技术路线:端到端解决模块割裂,模仿学习存在目标函数局限,世界模型需行为与渲染分离。他指出VLA、WAM等新架构并非瓶颈所在,数据配比与强化学习规模化才是关键。