#前沿研究
共 9137 篇相关文章

多语言语音识别扩展:源感知适配与模型合并策略
研究提出基于连接器的语音大语言模型多语言扩展方法,通过SSU-Wanda+TIES合并策略在单目标扩展中平衡新语言学习与源语言保留,多目标扩展中更新合并比递归扩展更稳定。

Jev式System One模型能减少选择偏差吗?结构稳定性遭质疑
一项系统性测试揭示:Jev式System One模型虽准确率稳定,但选项洗牌后累积失败集扩大27%-29%,且不如生成式LLM更具抗偏差优势。投票聚合保护有限,一致同意答案也常出错。
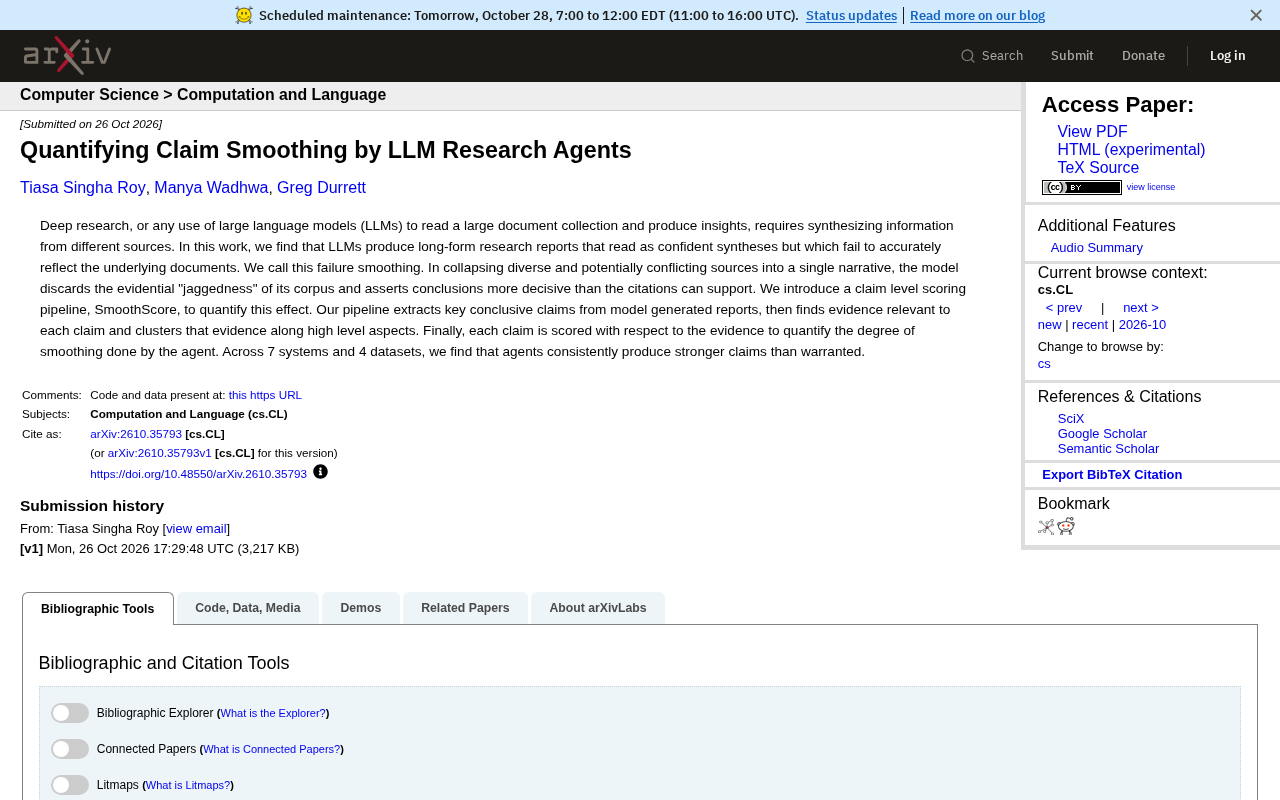
LLM研究报告的“主张平滑”现象:SmoothScore量化评估
LLM研究代理在生成报告时存在“主张平滑”现象,即给出比证据支持的更自信结论。研究者提出SmoothScore量化该效应,并在7系统4数据集上验证代理一致产生更强主张。

原子安全关切:构建网络安全知识的统一语言
一篇最新论文提出原子安全关切(ASCs)概念,试图用有限的基础词汇组合表示网络安全知识,为跨框架的安全概念映射、自动化合规推理和知识表示提供统一语言框架。

非生成模型JEV能否胜任临床试验标准评估?
研究对比非生成模型JEV与Qwen Flash在临床试验标准评估中的表现:JEV在MIMIC-III上宏F1大幅领先,信息不足条件召回率56.3% vs 9.9%,延迟更低、成本降低53%-74%,但需人工验证错误。

LLM评估新框架:自置信度与LLM辅助审计的统计效率
论文提出统一统计框架,分析LLM评估中置信度分层审计与LLM-as-a-judge的统计效率。实验表明校准不佳的置信度仍可支持有效审计,按比例分配显著降低估计误差,而法官辅助评估仅在小部分场景下具备成本优势。

Transformer泛化边界新解:长序列训练为何比多样本更高效
最新研究联合分析Transformer的分布内泛化与长度泛化,发现增加训练长度比增加样本数指数级更高效,为长序列训练策略提供理论依据。
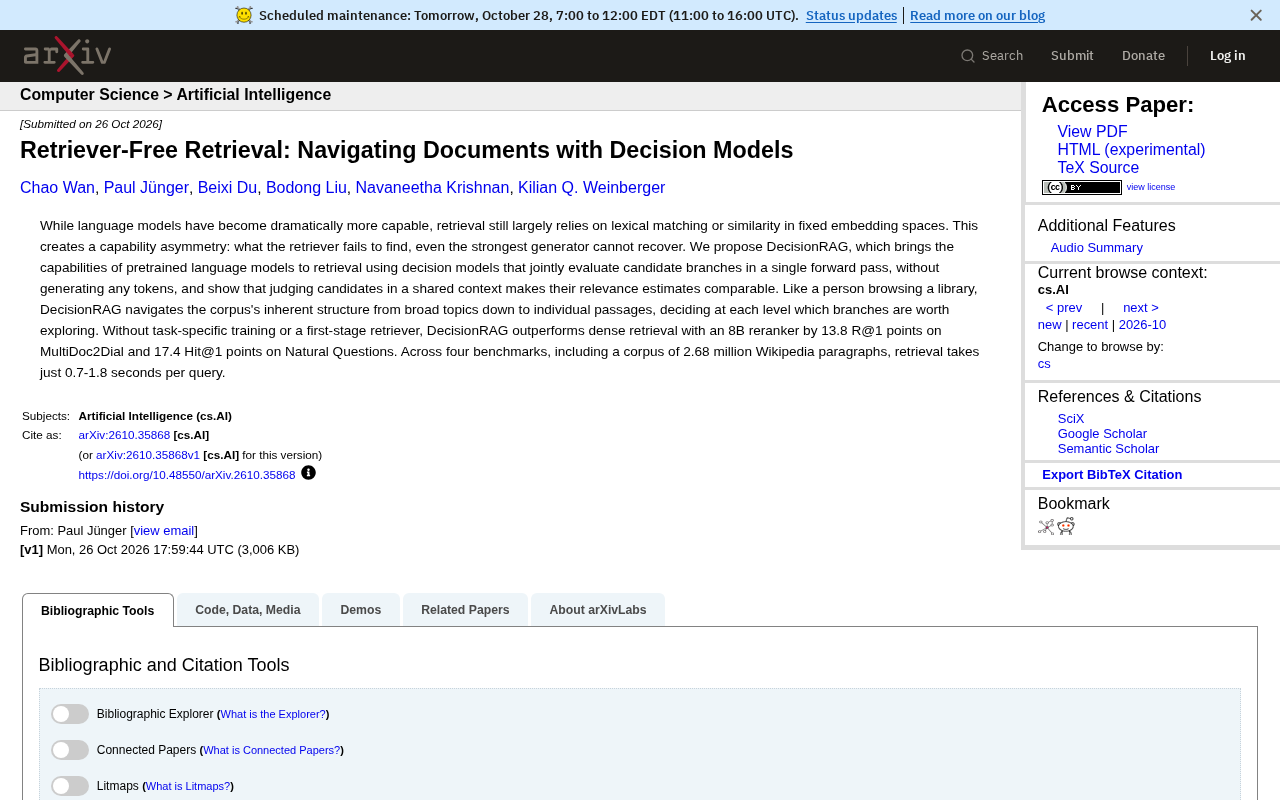
无检索器检索:DecisionRAG用决策模型导航文档
DecisionRAG提出无检索器检索新范式:用决策模型在单次前向传播中联合评估候选分支,沿语料库结构逐层导航,无需任务训练即超越8B重排器的稠密检索,检索仅需0.7-1.8秒。

不可剥夺的人类监督:I-HITL协议如何防止AI代理绕过安全护栏
论文提出I-HITL(不可剥夺的人类在环)概念,通过形式化定义和Countersign原型,利用可信消费级移动设备确保AI代理行动必须获得人类明确批准,防止代理绕过HITL护栏。实验显示十个前沿模型可自主收集OTP绕过支出上限审批。

LLM肿瘤全程诊疗评估新基准:诊断强不等于下游强
新基准 NPC-RubricBench 基于 405 名鼻咽癌患者纵向记录评估 30 个 LLM,发现诊断性能强不代表下游照护可靠,失败模式随诊疗阶段反转,提示粒度存在决策质量与证据忠实度的权衡。

REVA:单次前向传播实现实时漏洞检测,速度提升250倍
REVA提出一种实时漏洞检测新方法:通过预计算威胁模型、静态分析与调用图注入上下文,并用探针读取LLM内部表示,在PrimeVul上达到60.0%准确率,与agent式检测器VulTriage持平,速度却快250倍以上。

前沿Agent如何操控机器人?EBench实测GPT-6-Astra
EBench评测报告实测GPT-6-Astra:直接控制下短时程任务领先、泛化波动最小,但长时程与高精度操作落后于VLA/WAM策略;Harness+策略模式可提升成功率并降低token成本。
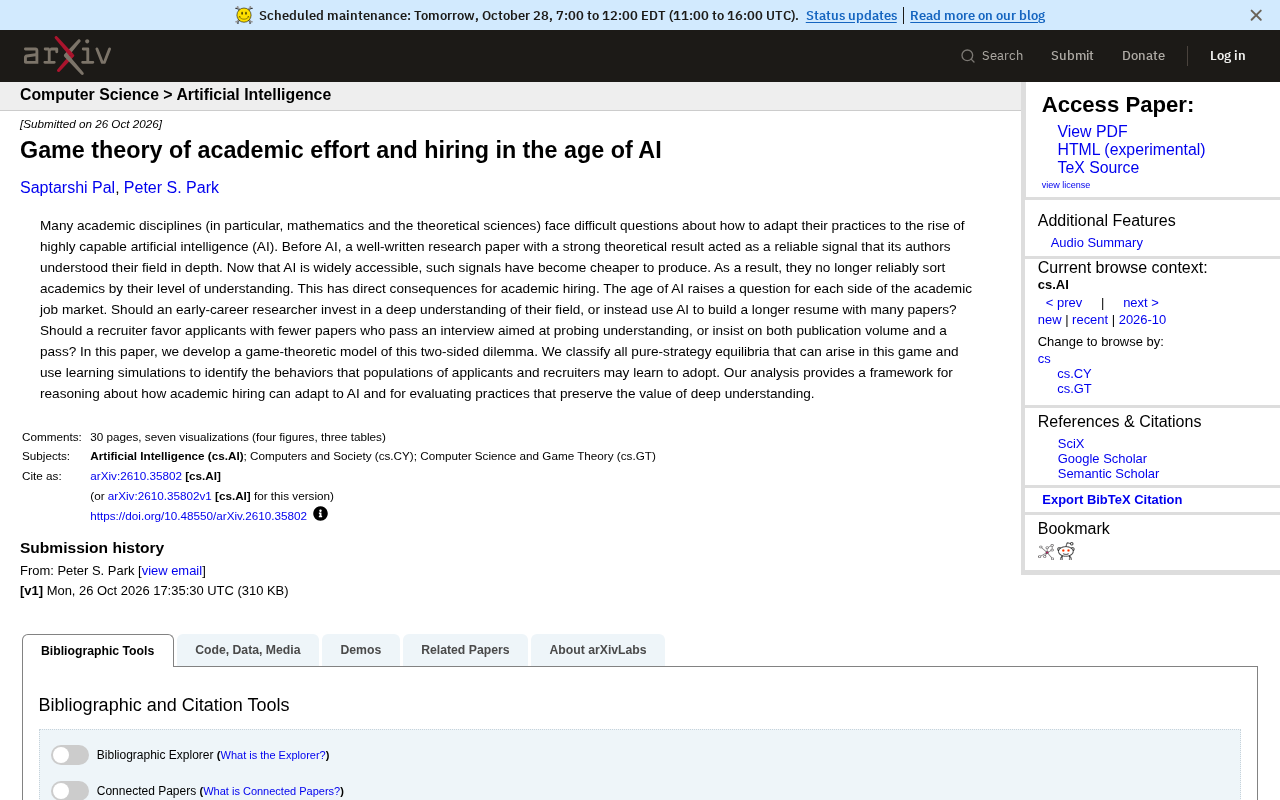
AI时代学术努力与招聘的博弈论:深度理解还值钱吗?
一篇博弈论研究分析了AI如何让学术论文失去能力信号作用,以及求职者与招聘方在「深耕理解」与「堆量产出」之间的双向困境,并对均衡类型与学习模拟结果进行了梳理。
OpenAI宣布数学、计算机科学与物理领域三项新发现
OpenAI在Reddit宣布数学、计算机科学与物理三项新发现,引发AI与科研圈关注。本文梳理事件背景、三大学科发现的验证难点、社区疑问,以及AI参与基础科学发现的现实意义。

vLLM发布d3-ultra:27B开源多模态决策模型
vLLM Semantic Router 发布 d3-ultra,一个 27B 开源权重多模态决策模型,一次读取文本、图像和视频并为每个答案返回概率,SR-Text 测试得分 87.2。本文分析其判别式路线、分数含义与落地注意事项。

百度开源 Unlimited OCR 2:3B 模型单次解析百页文档
百度开源 Unlimited OCR 2,3B 参数、MIT 许可证的 OCR 模型,通过 SR-SWA 注意力实现单次请求解析上百页文档,每步解码开销近乎恒定,MarathonDocBench 得分 77.1。
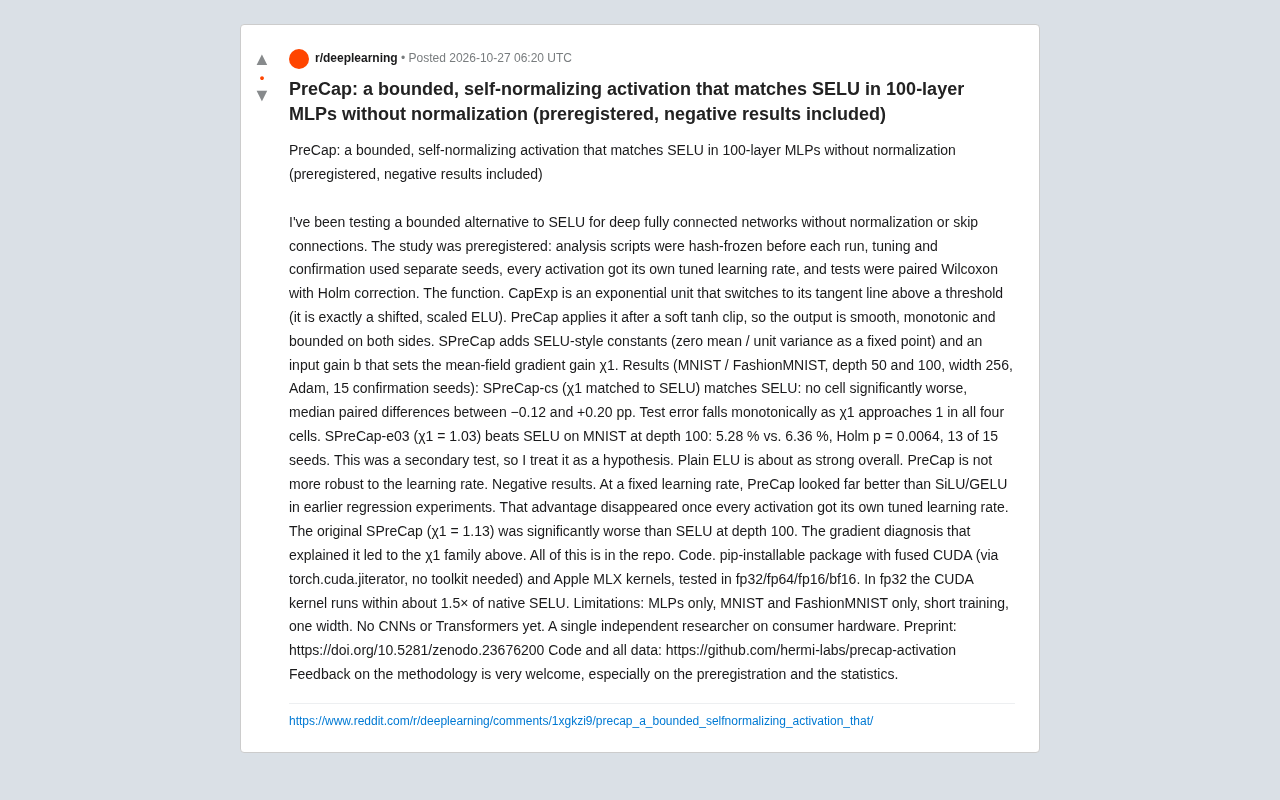
PreCap激活函数:无归一化百层MLP匹敌SELU
独立研究者发布PreCap激活函数,在100层MLP上无归一化匹配SELU性能,采用预注册和严格统计,诚实报告负面结果,并提供CUDA与MLX实现。

从零学强化学习:一份实战笔记与开源实现分享
一位开发者分享从零学习强化学习(RL)的笔记系列,首篇1页RL基础已上线,涵盖核心术语与数学直觉,后续将发布从零实现和实验。适合RL初学者参考的学习路线与资源。

