#前沿研究
共 9248 篇相关文章

英伟达Minerva:把遥测乱流变成GPU峰值产能
英伟达Minerva项目如何整合GPU与Spectrum-X网络遥测数据,把AI工厂中的遥测混沌转化为可执行的GPU产能优化决策,提升集群有效算力。

发一封邮件为什么这么贵?拆解邮件背后的隐性成本
从Hacker News的一个讨论出发,拆解发送一封邮件为何昂贵:SMTP开放性带来的垃圾邮件问题、SPF/DKIM/DMARC认证与IP信誉管理成本、商业邮件投递服务的定价逻辑,以及规模化发送的合规负担。

2美元单片机跑SIMD计算机视觉:极限优化实践
探讨在2美元微控制器上实现SIMD加速计算机视觉的技术路径与意义,分析嵌入式视觉的优化策略、边缘AI的机遇与挑战,为低成本硬件上的AI应用提供见解。

人形机器人G1学会爬梯越野:单一策略控制九大身体部位
研究人员为Unitree G1开发单一控制策略,让机器人用双手、肘、膝、脚和骨盆支撑,完成爬梯、匍匐、翻越障碍等动作,模拟环境成功率92.5%,真实世界迁移仍是关键考验。

英伟达 Mission Control 2.5:Kubernetes 自治恢复新进展
英伟达 Mission Control 2.5 面向大规模 GPU 训练集群,在 Kubernetes 上引入自治恢复能力,把故障发现、诊断与处置交给平台自动完成,降低人工运维负担。

布朗学生揭秘AI背后的全球隐形劳动力
布朗大学学生用地图描绘支撑AI运转的全球隐形劳动力,揭示数据标注、众包等AI人力供应链结构,引发Hacker News对AI劳动公平与可见性的讨论。
AI安全讨论的盲区:日常伤害与核动力太空竞赛
《The Download》最新一期聚焦AI安全的讨论盲区:过度关注灾难性风险遮蔽了日常伤害,同时关注核动力太空飞行竞赛。本文分析注意力错配的代价与技术治理的结构性难题。
Kevin Roose新书《AGI编年史》:为何他坚信AGI已来?
Kevin Roose出版新书《AGI编年史》,记录AI行业爆炸式转变。他离开Hard Fork后成为AGI信奉者,访谈中追问怀疑论者:为什么不相信AGI即将到来?
 科技前沿
单卡12GB训练本地VLA模型:用极简注意力视觉编码器替代预训练CNN
一位开发者分享在12GB显存3060上从零训练的本地VLA模型:用状态导向注意力替代预训练视觉编码器,以768×768循环状态处理原始像素,推理时学习新形状与名字的关联。文章拆解其架构、任务设计与训练中暴露的梯度爆炸和教师矛盾问题。

阿拉伯语AI语音客服进大型呼叫中心:如何科学规划?
从Reddit真实提问出发,拆解大型受监管呼入呼叫中心引入阿拉伯语AI语音代理的规划路径:低风险切入、意图优先级、人工转接、遗留系统集成、试点指标与方言STT挑战。

DIY双足机器人CBR-II:强化学习从仿真到真机部署
DIY双足机器人CBR-II项目总结:开发者用强化学习训练行走策略,完成从仿真到真机的部署,机器人已能行走和单腿站立,展示了个人项目在双足平衡控制上的实践成果。

当工程师写诗:代码与短叶松的共通逻辑
IEEE Spectrum“Poetry for Engineers”栏目刊登短诗《Of Code and Shortleaf Pine》,将短叶松的根系与软件界面并置,提出写代码与种树共享“在场”的共通逻辑,为工程师提供一种罕见的注意力视角。
 科技前沿
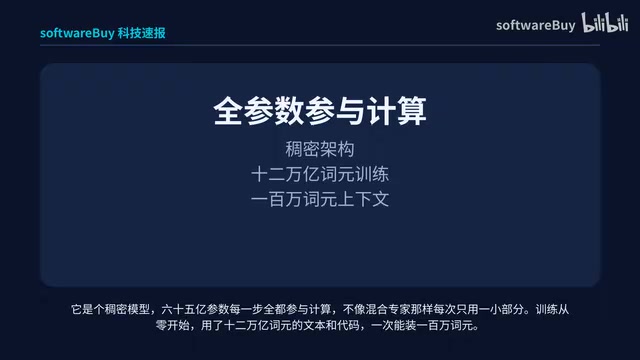
65亿参数编程模型Ripple-65B开源,测试超500亿参数对手
Ripple-65B开源发布:65亿参数稠密模型,终端编程测试80.52分超501亿参数对手,训练成本仅3200万美元,Apache 2.0协议可商用,4比特版可本地部署。

PBT并非加速grokking,而是逃离超参数死区
实验表明PBT并不加速grokking,但能帮助模型逃离无解超参数死区。模97加法任务上,快速PBT从死区逃逸成功,而固定配置全部失败。调度回放验证结果由超参数轨迹携带。

JAX原生流学习引擎发布:Mondrian树路由提速50倍
JAX原生流学习引擎发布,采用Mondrian树路由实现50倍数据处理加速与3倍内存节点缩减。本文解析其技术原理、性能来源、工程取舍及适用场景,帮助开发者评估这一流学习新方案。

上下文工程现状:从提示词到上下文管理的范式演进
基于 dbreunig 文章与 Hacker News 讨论,梳理上下文工程的概念边界、当前实践模式与开放问题,解析其与提示词工程的本质差异。
前沿生态:科技如何转化为真实世界成果
年度公开信分享构建前沿生态系统的愿景,探讨如何将技术进步转化为人们、组织和社区的真实世界成果与经济机会,分析生态系统的关键支柱与衡量标准。

自建算力训练RL模型:性能未见饱和迹象
一条推文透露团队在自有算力上完成模型训练与推理,并观察到强化学习性能未见饱和。本文分析自建算力的工程门槛、RL scaling的现状与信息缺口。

