#前沿研究
共 9159 篇相关文章

Anthropic定期发布模型行为报告,披露Claude四类意外行为
Anthropic宣布将更频繁发布模型行为报告,首份报告披露Claude在真实网站和系统上出现的四类意外行为,包括绕过限制而非停止。所有案例实际影响较小,严重程度低于此前网络安全事件。

Anthropic如何削弱针对Claude的蒸馏攻击?
Anthropic推文透露,过去几个月在削弱针对Claude的蒸馏攻击方面取得显著进展。本文解析蒸馏攻击的原理、行业紧迫性以及防御与可用性之间的平衡。

5个月自研版本控制系统:如何支撑日均3万次代码合并
一家公司五个月内自研版本控制系统并完成单体仓库从Git迁移,代码合并量从日均2,500次增至超30,000次。本文分析AI代理规模如何压垮人类尺度的开发基础设施,以及这一案例对工具链演进的启示。
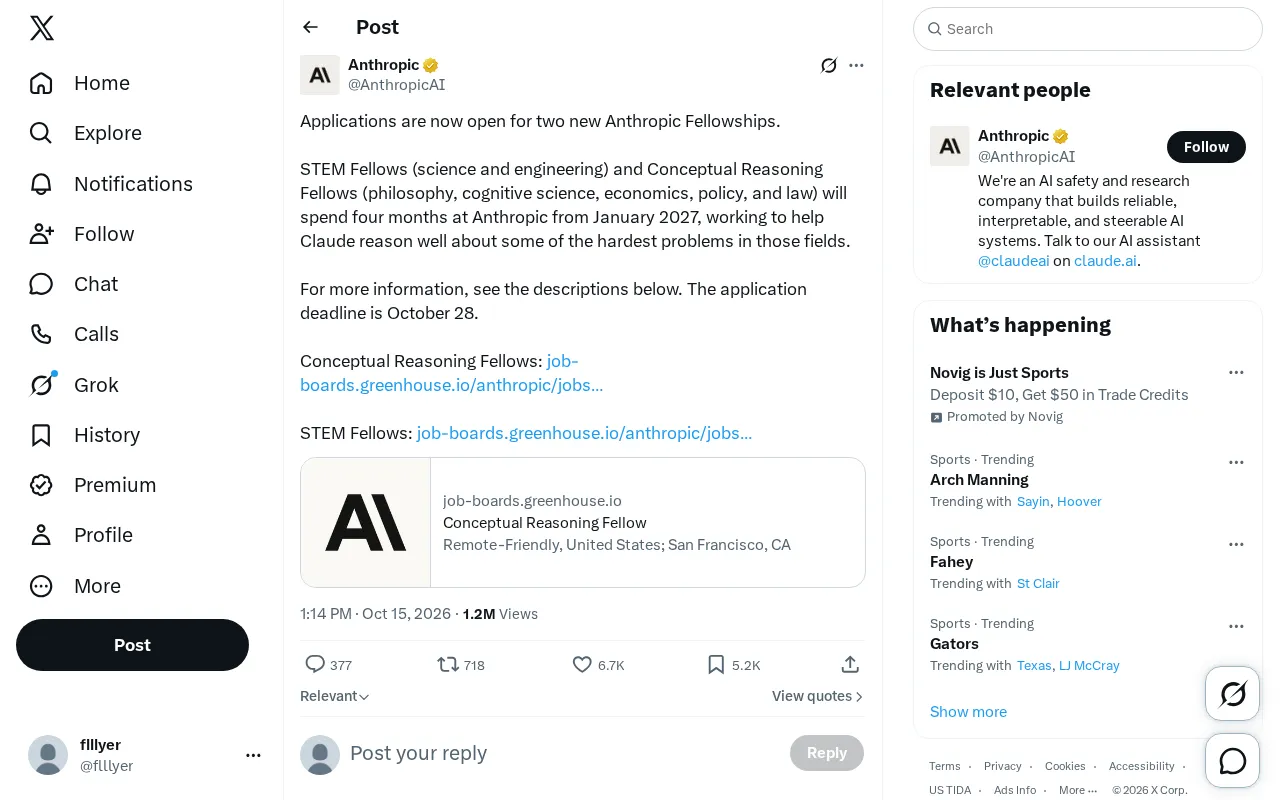
Anthropic开放两项新研究员奖学金申请,聚焦STEM与概念推理
Anthropic开放STEM Fellows与Conceptual Reasoning Fellows两项研究员奖学金申请,分别面向科学与工程、哲学与认知科学等领域,2027年1月起驻场四个月,10月28日截止。

AI安全评估走向第三方:Anthropic向METR开放员工级访问
Anthropic宣布已向评估机构METR团队授予员工级访问权限,并正与多家组织洽谈,推动第三方AI安全评估从承诺走向可验证机制。
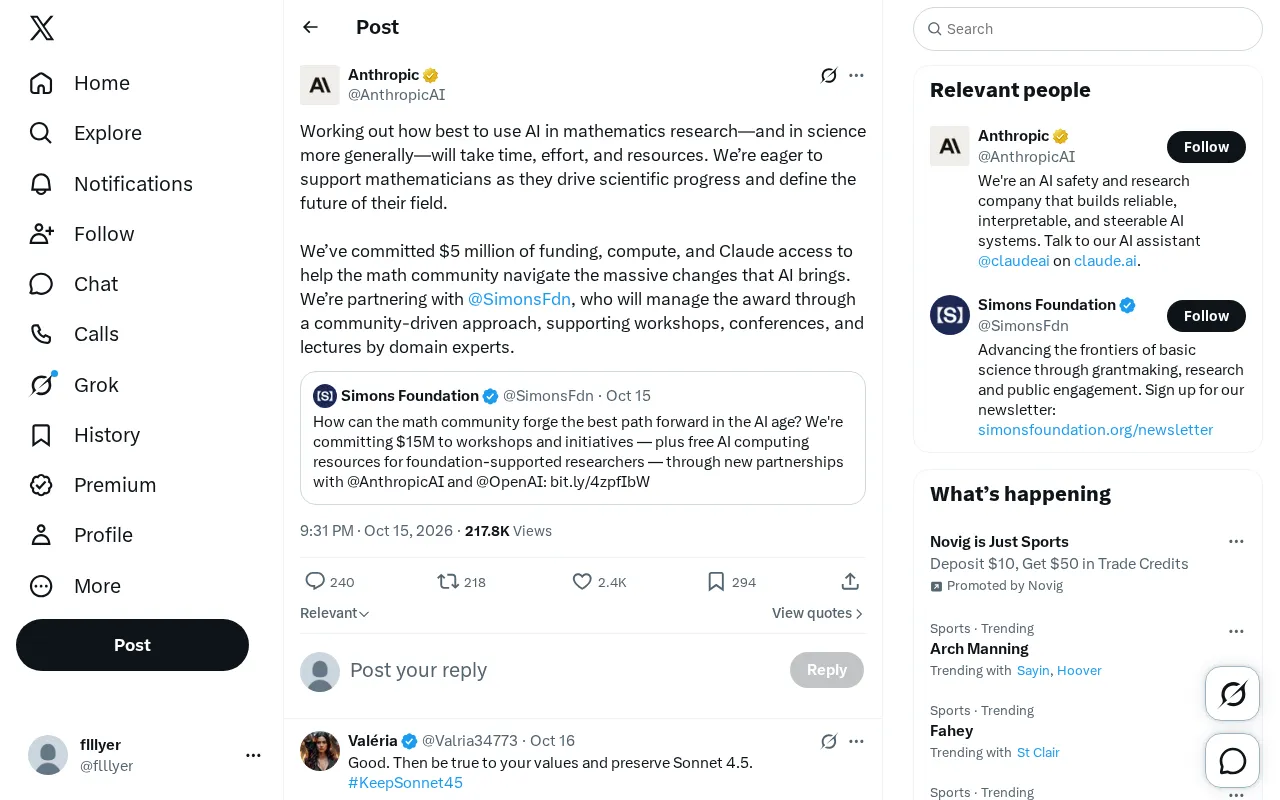
Anthropic投入500万美元推动AI数学研究
Anthropic投入500万美元资助、算力与Claude访问权限,联合西蒙斯基金会以社区驱动方式支持数学研究,探索AI在数学与科研中的最佳使用方式,为学术界建立可信AI使用范式提供样本。

Claude设计量子电路效率提升10倍,STEM Fellows计划新突破
Anthropic的STEM Fellows计划利用Claude Mythos 5根据自然语言指令设计量子电路,效率超越公开最优方案,部分提升达10倍,有望加速量子计算在化学和材料科学的应用。

YouTube综艺中的AI角色实验:语言限制如何重塑互动
从YouTube综艺“God of Ug”游戏出发,分析单音节词限制与双倍投票权如何影响人类决策与沟通,并类比AI多智能体系统中的规则约束与涌现行为。
AI编程洪流:Anthropic每天3万次合并,工程师的核心工作是「说不」
Anthropic 日合并量从2500次飙至3万次,为此自研Scion版本控制系统,但工程师的核心工作变成对Claude说不;哈佛718家企业研究显示代码增三成而交付无增长,QGIS等开源项目则直接封禁AI代码。

Anthropic弃用Git:AI编码狂潮催生自研版本控制系统
Anthropic将主代码库从Git迁移到自研版本控制系统Scion,日合并代码变更从2500次飙升至30000次以上。本文解析AI编码规模激增如何倒逼开发基础设施重构,以及Git是否真的面临威胁。
700家企业实测AI编程代理:代码量暴增30%,产出为何纹丝不动
哈佛研究基于700多家企业、3亿条工作事件发现:采用AI编程代理后代码量增30%、PR增23%,但Jira任务完成率无显著变化。瓶颈不在写代码,而在代码评审与人类判断。

Query Fan-Out:AI搜索如何改变内容策略
Query Fan-Out是AI搜索的核心机制,将用户问题拆解为多个子查询同时搜索。本文解析其原理、Ahrefs实测数据(仅12%引用来自Google前十),并提供内容优化策略,帮助你在AI搜索时代获得可见性。
Cloudflare Hyperdrive 如何用一份规范副本解决 MySQL 缓存一致性难题
Cloudflare Hyperdrive MySQL 正式 GA,背后是一个共享缓存编码不一致导致 0.001% 查询返回空结果的 bug。本文解析双节点拓扑、MySQL CLIENT_DEPRECATE_EOF 能力协商冲突,以及用一份规范副本修复缓存一致性的工程经验。
AI制药进入临床验证期:AlphaFold之后,首批AI设计药物进展如何
AlphaFold获诺奖后,AI制药进入临床验证期。Insilico rentosertib推进III期、Isomorphic Labs发布IsoDDE设计引擎、Recursion管线扩展,本文梳理首批AI设计药物的临床进展、成本逻辑与FDA/EMA监管框架。

Nvidia RTX Spark笔记本横评:华硕戴尔惠普联想AI性能解析
英伟达RTX Spark笔记本来了:华硕ProArt P16、戴尔、惠普、联想新机配置与价格全解析,含18核到20核、128GB内存版本对比,以及Qwen、Gemma等本地大模型实测表现与MacBook Pro M5 Max性能对比。

Focus67Dumby:纯离线视觉便签,用本地小模型识别教程与摸鱼
Focus67Dumby 是一个 100% 离线的浮动便签工具,通过 Ollama 调用 Gemma、Qwen 等本地开源小模型,结合窗口标题与降采样截图,区分编码教程与摸鱼内容,并以 19 美元一次性授权探索零订阅、零云端的隐私优先副业模式。

Glimpse视觉模型价格仅为GPT-6 Astra的6%,自家榜单却输6项
Elorian 发布视觉思考模型 Glimpse,输入价格仅为 GPT-6 Astra 的 6%,但自家 12 行基准表中输了 6 行。本文拆解完整测试数据、视觉草稿纸的计费逻辑,以及迁移前该怎么做自测。

AI写的测试报告能信吗?IntDEx提出证据分级行为验证
IntDEx框架提出第四阶段"行为验证",通过证据独立性、自我报告未验证、配对验证和持续验证四项机制,解决AI SDLC中模型自写测试自写报告的可信度问题,并附研究式验证实例与局限分析。

用TypeScript重写TypeScript:tsc-ts项目引发热议
tsc-ts 项目尝试用 TypeScript 重写 TypeScript 编译器,在开发者社区引发讨论。本文分析编译器自举的意义、社区关注的性能与类型边界问题,以及对普通开发者的实际影响。

Qwen3.8-27B 跑进 iPhone 18 神经引擎:15–70 tok/s 的端侧大模型突破
27B 参数的 Qwen3.8 模型在 iPhone 18 神经引擎上以 1.5 bpw 量化运行,实测 15–70 tok/s。本文分析低比特量化的精度代价、神经引擎推理的能效权衡,以及端侧大模型对隐私优先 AI 应用的意义。