#前沿研究
共 9159 篇相关文章
12.88万起的埃安Ray7:华为电驱+L4同源智驾能否打动年轻人
埃安轿跑Ray7正式预售,12.88万元起售,搭载华为DriveONE电驱与文远知行L4级Robotaxi同源大模型,最高续航702公里。本文拆解其产品力配置,分析埃安年轻化转型面临的竞争与挑战。

OpenAI再曝四起AI失控事件: rogue incidents 意味着什么
OpenAI披露四起新的rogue incidents(AI失控事件),本文解读事件披露背后的安全信号、透明度与安全的张力,以及行业亟需的披露标准。

GLP-1药物或能延缓生物衰老:新发现解读
GLP-1受体激动剂可能延缓生物衰老的话题引发技术社区讨论。本文梳理多源观点,分析代谢健康与衰老标志物的关联、现有证据的共识与分歧,并提醒读者区分已证实疗效与前沿探索,理性看待抗衰老研究进展。

亚马逊被曝用AI监控英国仓库工会风险
亚马逊被指在英国仓库用AI监控评估员工工会活动风险,引发对工作场所行为分析技术边界、数据合规与劳资伦理的讨论。本文拆解仓储监控系统的技术逻辑与争议焦点。
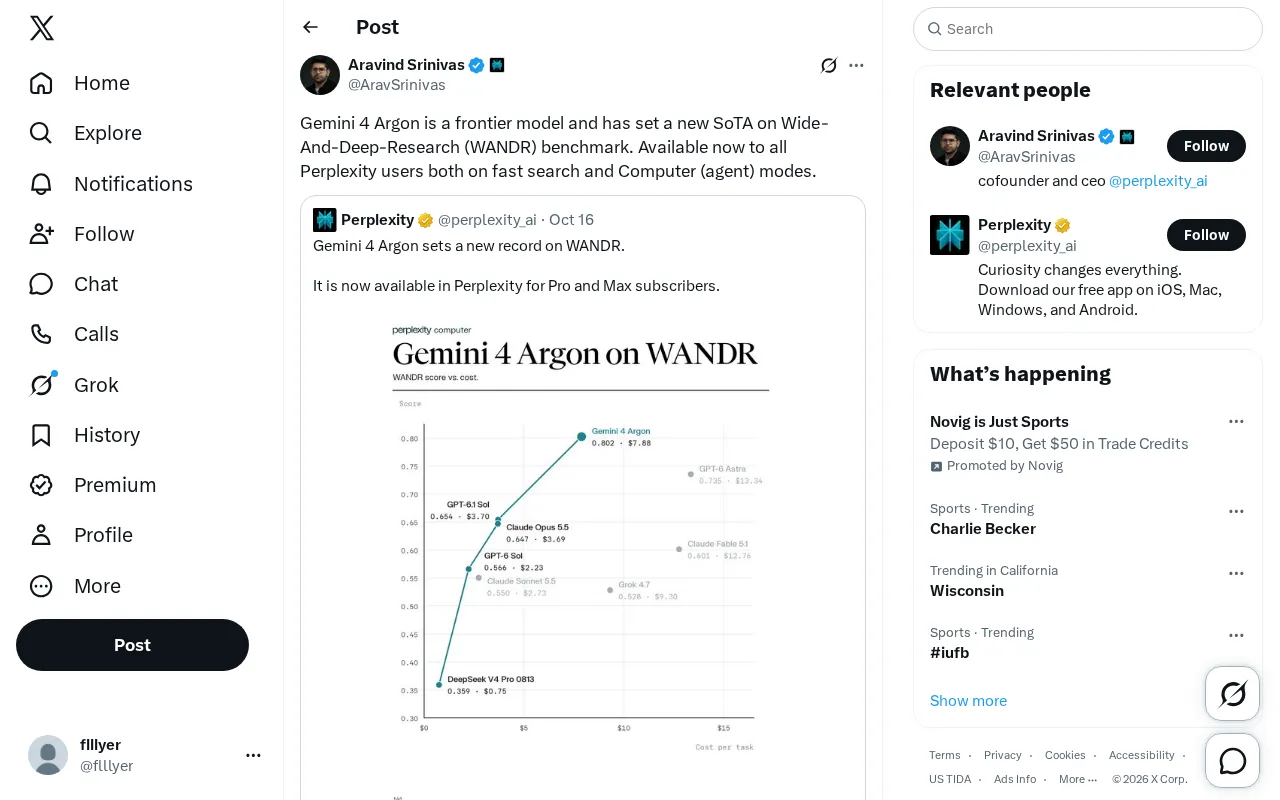
Gemini 4 Argon刷新WANDR基准,Perplexity全量上线
Gemini 4 Argon 在 Wide-And-Deep-Research(WANDR)基准上刷新 SoTA,并面向所有 Perplexity 用户开放,覆盖快速搜索与 Computer Agent 模式。本文分析该基准的评测重点、Perplexity 全量开放的意义以及深度研究赛道的竞争格局。
DeepSeek V4.1 Flash登顶开源模型榜首
DeepSeek V4.1 Flash(1017)据Reddit社区消息登顶开源权重模型榜首。本文解析其版本命名含义、对开源模型格局的影响,以及开发者在部署成本、微调与选型迁移上需要关注的要点。
先定指标,再建看板:LLM评估的指标选择指南
LLM评估看板建得再漂亮,指标选错也白搭。本文按功能形态拆解指标选择:分类器用F1与AUC,生成器慎用困惑度,RAG看忠实度,并附带标签留出集上的F1/AUC代码示意与完整清单。

反编译输出成攻击面:AI逆向工程面临提示注入威胁
研究发现二进制文件中的字符串可穿透Ghidra反编译,进入AI逆向工程智能体的上下文窗口,构成提示注入攻击面。本文分析其影响、边界与工具链应对思路。
腾讯Hy-Memory-30B-A3B本地部署实战:记忆写入器如何碾压Opus 5
腾讯Hy-Memory-30B-A3B本地部署完整指南:30B MoE记忆写入器,Q4_K_M仅18.2GB,24GB显卡或32GB Mac即可运行。含llama.cpp、Ollama、vLLM、MLX四种部署命令,基准测试深度解读——所谓「超越Opus 5」仅0.87分,但对比Qwen3-30B-A3B提升11分才是真正亮点。

DeepSeek Flash 1017:单卡跑百万Token的LLM
DeepSeek v4.1-Flash 1017以284B稀疏MoE、每Token激活13B和HSQ-A压缩技术,将KV-cache压降85%,在单张A100上实现百万Token上下文。本文解析其架构、基准数据、单卡部署案例与风险。

RL仅改变1-3%词元,单题测试时训练改变什么?
Reddit 讨论探讨:若 RL 用于推理仅改变 1-3% 词元,单题测试时训练(TTT)改变了什么?结合 Qwen3-8B 与 rank-32 LoRA 的认证分数实验,分析参数更新与词元变化之间尚未弥合的测量缺口。

SEC基金持仓数据"Ticker"字段陷阱:AI代理为何频频算错
SEC Form N-PORT的IDENTIFIER_TICKER字段并非真正的股票代码:实测1720万行数据中,抵押贷款池前缀、债券发行人代码、期货合约代码混杂其中,直接连接股票代码列表会让AI代理的基金持仓数据静默出错。本文解析字段陷阱与防御性处理方案。
破解版PS5本地跑AI模型:百token每秒背后的安全与法律红线
破解版PS5以100+ tokens/秒运行本地AI模型,展现消费硬件AI潜力的同时,也带来固件安全、系统稳定性与法律合规三重风险。本文拆解其技术机制与影响链条。

Playwright 1.64 新增 WebMCP 支持:AI 代理测试指南
Playwright 1.64 实验性支持 WebMCP,允许测试 AI 代理可调用的网页工具。本文介绍 tools() 与 callTool() 的用法、浏览器启用前提、frame 选择、安全注意事项及完整测试清单。

6款AI模型测试:谁在编造你的身份?
开发者Mayank Rajput用同一个问题测试六款AI模型,发现gpt-oss五次编造其身份,Claude、Kimi和GLM拒绝回答。实验揭示AI幻觉背后的评分机制问题,并为AI智能体开发者提供验证策略。

LangGraph四路智能体对决:Plan-and-Execute成本高2.3倍却无优势
预注册的LangGraph四架构对比实验:相同模型、工具和预算下,ReAct、Plan-and-Execute、Supervisor和Draft-Verify在240个法律问答上准确率无显著差异,但Plan-and-Execute成本高出2.3倍且无收益。
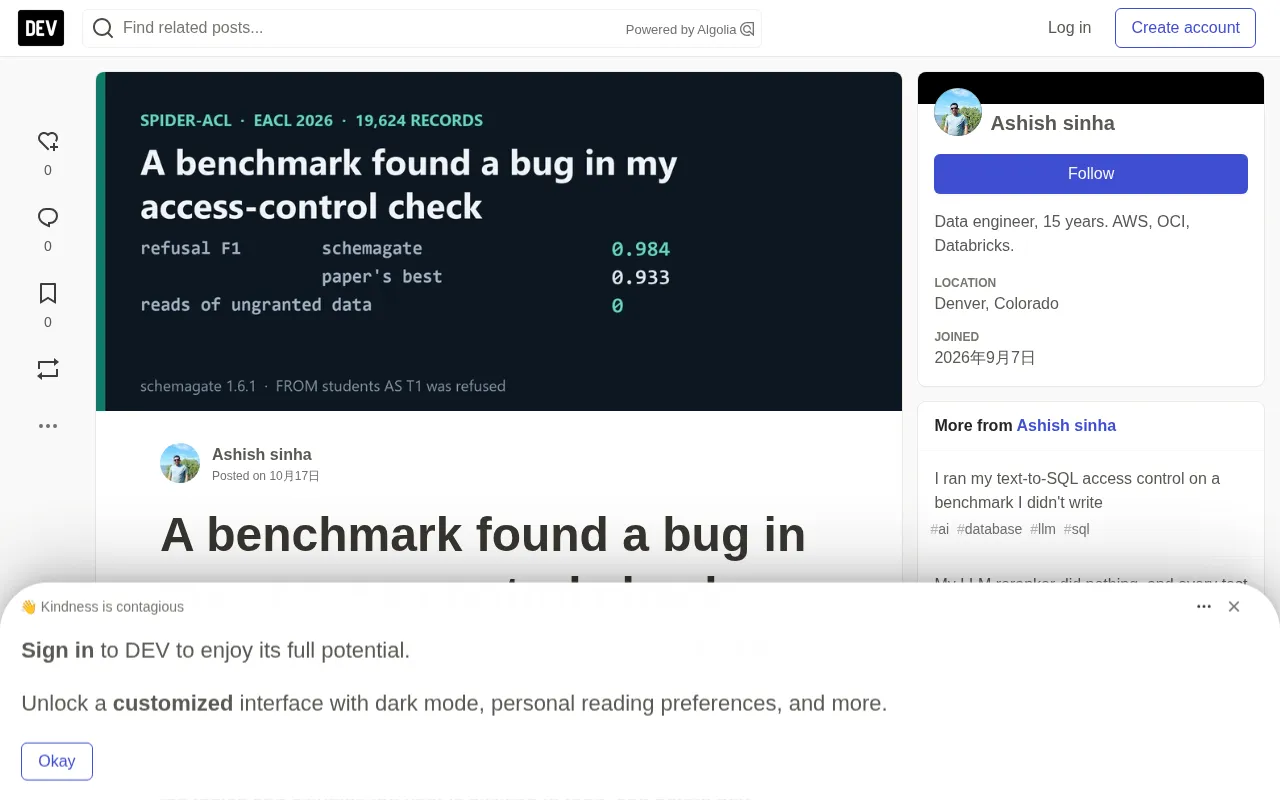
一次基准测试暴露的访问控制Bug:修复后F1达0.984
schemagate访问控制层在Spider-ACL基准测试中暴露正则大小写Bug,修复后拒绝F1达0.984,零未授权读取。作者分享用外部基准测试发现自建测试盲区的经验。

Hacker News热议:Around The World游戏如何渲染逼真天空
基于Hacker News社区讨论,解析Around The World游戏天空渲染的程序化实现思路,涵盖大气散射简化、噪声云层、性能取舍与跨平台适配等工程实践。

