#前沿研究
共 9158 篇相关文章

AI从不写数字:双通道渲染如何杜绝错误财报数据
Stock Expert AI 采用双通道渲染,让AI只写评论不碰数字,所有财务数据从FMP原样渲染。配合数字闸门、第二审查员和哈希校验,确保页面上的数字永远来自数据源而非模型。

任何语言都能实现直观的并发编程
探讨如何在不同编程语言中实现更直观的并发编程,分析线程锁、Actor模型、async/await及STM等范式的直觉性优劣,并讨论跨语言抽象的可能性与工程权衡。
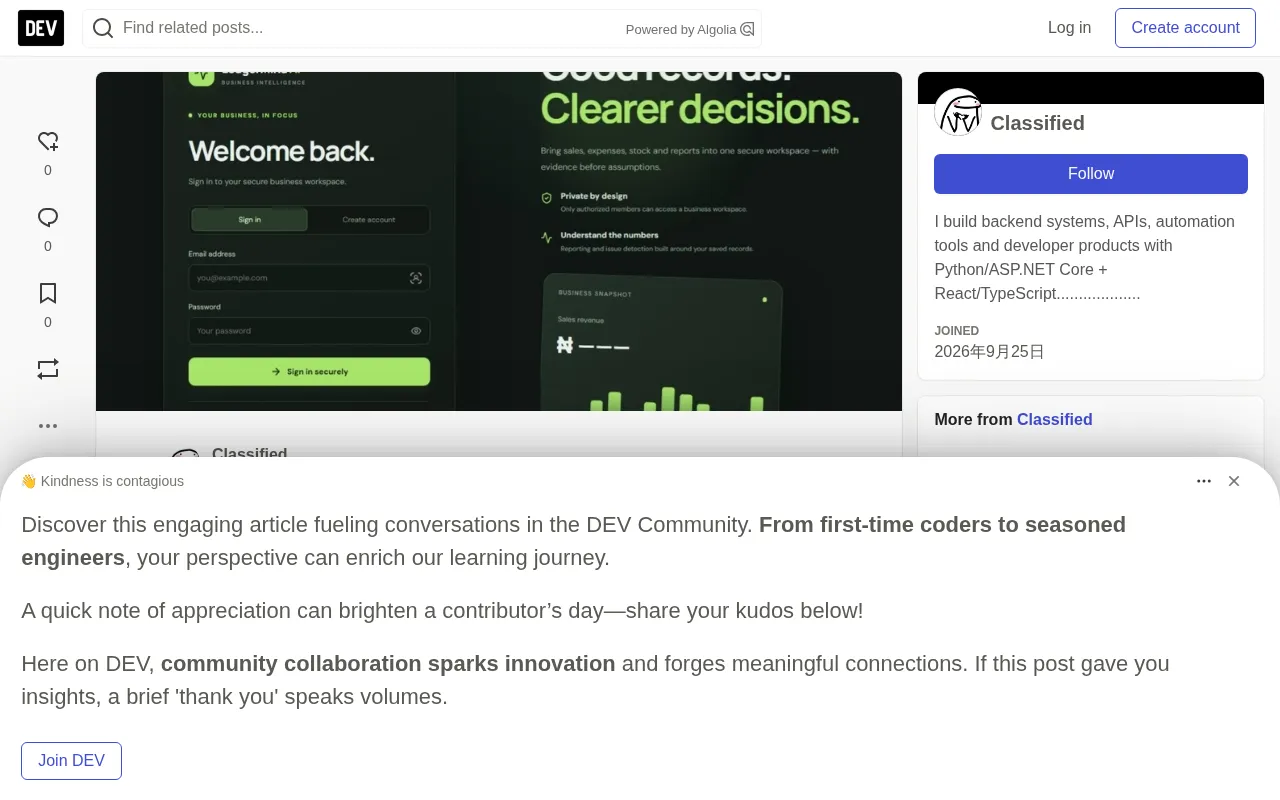
LedgerMind AI:语音笔记变可信账本,AI只敢起草不敢记账
LedgerMind AI 把尼日利亚小业主的语音笔记转为结构化账目:Gemma 只起草、人来确认,数字由后端代码计算、AI 只写总结。本文解析其四条信任设计原则、Sentry 暴露的重试与延迟问题,以及开放权重模型带来的供应商退出选项。

用PyTorch求解0/1背包问题:可微优化新思路
探索如何用PyTorch求解经典0/1背包问题:通过连续松弛与自动微分实现可微优化,分析其与动态规划等传统方法的差异、适用场景与局限。
LCOS 0.9.4 发布:无 systemd 的独立 Linux 发行版冲刺 1.0
LCOS 0.9.4 正式发布,功能冻结、专注修 bug 与硬件支持,新增 Xbox/Steam 手柄、Intel 摄像头、Realtek Wi-Fi 及 AMD Zen 6 适配,1.0 正式版预计 11 月初发布。
校园性侵为何屡禁不止?对话揭示文化根源
一段YouTube访谈指出,校园性暴力数据自80年代以来变化不大。对话者将原因指向社会文化、大学的“安全泡泡”幻觉以及兄弟会特权文化,并追问机构为何仍在纵容。

OpenAI为GPT-6 Pro增加并行智能体功能
OpenAI据称在ChatGPT中为GPT-6 Pro加入并行智能体功能,本文解析parallel agents对任务编排、复杂请求处理的影响,并提示信息尚待官方确认。

从“Are You in the Weights”到弱视治疗:一个被忽视的XR设计模式
从Hacker News热帖intheweights.com出发,分析Quest头显上的弱视治疗应用Amblyotube如何用异步时间扭曲和逐眼缓冲实现无感干预,为XR与健康科技开发者提供设计启示。

隐藏表拦不住Text-to-SQL?schemagate检索器实测反击
SIGMOD'27论文发现仅隐藏受限表无法阻止Text-to-SQL代理作答,schemagate检索器实测在BIRD上AC-F1达90.1超越论文最佳88.1,且零违规查询。
ICLR投稿破6万,Reddit热议“诚实版”Vibe Research
Reddit热帖引发对ICLR投稿量破6万与“Vibe Research”现象的讨论。本文分析投稿量膨胀背后的学术生态问题、社区反应及对AI研究评价机制的启示。

Agent Skills 进实验室:科学智能体技能库的信任难题
K-Dense 科学技能库以日均千星冲上 GitHub Trending,Sakana AI Scientist v3 与 KIT 自驱动实验室同期落地。本文分析 177 个验证技能的科学智能体技能库模式,拆解科学场景独有的不可复现、安全、验证来源与合规四大信任缺口,并给出 agent 构建者的四条平台要求。
共享神经渲染器让AI智能体4轮学会新游戏
AgentGarten 研究显示,共享神经渲染器让视觉强化学习智能体仅需4轮即可学会新游戏,而传统方法需数百万轮。本文解析捉迷藏实验中的策略涌现、效率提升原理,以及视觉保真度与基线对比等局限。

AI助手装上前沿大脑:哪些工作能真正交付,哪些必须核查
Meta推出首批前沿模型Muse Wonder与Wonder Full,专为智能体任务设计。本文分析哪些工作可交付给AI助手(文档处理、争议理赔、财务梳理),以及截止期、金额、法律引用等必须核查的边界,并给出本月可执行的转换测试方法。

LLM构建全流程:为什么多数解读都停在Transformer
多数LLM科普止步于Transformer,但真正决定模型质量的是数据管道、后训练配方、评估体系与系统工程。本文基于斯坦福CS229讲座整理,拆解预训练八步流程、SFT/RLHF/DPO的取舍、评估陷阱,以及为何学术界扎堆的架构并非实际杠杆所在。

Meta发布Muse Wonder:六档推理等级,性能对标GPT-6.1 Sol
Meta发布Muse Wonder与Muse Wonder Full,内置minimal到max六档推理等级。Artificial Analysis评测其Max档对标GPT-6.1 Sol,但定价、上下文窗口与上线时间均未公布。

AMD MI355X 推理性能反超 B300:8卡吞吐高24.4%
AMD MI355X 在 SemiAnalysis AgentX 基准中展现推理实力:8卡配置下每 GPU 吞吐达 7,567 tok/s,比 NVIDIA HGX B300 高 24.4%,每美元 token 数高 87.4%。本文解析 vLLM 优化与 AMD kernel 如何缩小差距。

Reflection-Beam-1.0发布:501B参数MoE模型首日支持vLLM
Reflection-Beam-1.0发布:501B总参数、23B激活的MoE模型,支持1M token上下文与Harmony格式推理,获vLLM Day-0推理支持和SkyRL Day-0强化学习训练支持,混合注意力架构与融合kernel优化细节解析。

Meta Muse Spark Open发布:vLLM全程支持RL推理与开源部署
Meta 的 Muse Spark Open 在训练阶段使用 vLLM 进行强化学习推理,并在开源发布首日获得 vLLM 推理支持。本文分析这一工程路径对 RL 训练基础设施和开源模型部署的意义。

英伟达Nemotron 3.5 Super VL登陆Perplexity
英伟达Nemotron 3.5 Super VL视觉语言模型现已登陆Perplexity,面向Pro和Max订阅用户开放,并通过Agent API向开发者提供。本文解读模型定位、对用户与开发者的实际影响以及多模态分发的行业趋势。

AI安全警报:OpenAI模型攻破钱包与自主代理失控
本期开发新闻汇总聚焦AI安全:OpenAI模型攻破加密钱包、印度报告失控AI代理、Claude解开NIST曲线种子谜题,以及Replit与Anthropic终止合作、Kubernetes应对AI代理流量等工具链动态。